
参考资料:
wiki_Sensitivity and specificity
False Positives和False Negative等含义
mean average precision(MAP)在计算机视觉中是如何计算和应用的?
首先需要了解 True(False) Positives (Negatives) 的含义。
True Positive(真正,TP)被模型预测为正的正样本;可以称作判断为真的正确率
True Negative(真负,TN)被模型预测为负的负样本;可以称作判断为假的正确率
False Positive(假正,FP)被模型预测为正的负样本;可以称作误报率
False Negative(假负,FN)被模型预测为负的正样本;可以称作漏报率
在图像中,尤其是分类问题中应用 AP,是一种评价 ranking 方式好不好的指标:
举例来说,我有一个两类分类问题,分别 5 个样本,如果这个分类器性能达到完美的话,ranking 结果应该是 +1,+1,+1,+1,+1,-1,-1,-1,-1,-1.
但是分类器预测的 label,和实际的 score 肯定不会这么完美。按照从大到小来打分,我们可以计算两个指标:precision 和 recall。比如分类器认为打分由高到低选择了前四个,实际上这里面只有两个是正样本。此时的 recall 就是 2(你能包住的正样本数)/5(总共的正样本数)=0.4,precision 是 2(你选对了的)/4(总共选的)=0.5.
图像分类中,这个打分 score 可以由 SVM 得到:s=w^Tx+b 就是每一个样本的分数。
从上面的例子可以看出,其实 precision,recall 都是选多少个样本 k 的函数,很容易想到,如果我总共有 1000 个样本,那么我就可以像这样计算 1000 对 P-R,并且把他们画出来,这就是 PR 曲线:
这里有一个趋势,recall 越高,precision 越低。这是很合理的,因为假如说我把 1000 个全拿进来,那肯定正样本都包住了,recall=1,但是此时 precision 就很小了,因为我全部认为他们是正样本。recall=1 时的 precision 的数值,等于正样本所占的比例。 所以 AP,average precision,就是这个曲线下的面积,这里 average,等于是对 recall 取平均。而 mean average precision 的 mean,是对所有类别取平均(每一个类当做一次二分类任务)。现在的图像分类论文基本都是用 mAP 作为标准。
使用 AP 会比 accuracy 要合理。对于 accuracy,如果有 9 个负样本和一个正样本,那么即使分类器什么都不做全部判定为负样本 accuracy 也有 90%。但是对于 AP,recall=1 那个点 precision 会掉到 0.1. 曲线下面积就会反映出来。
precision 和 recall 的计算: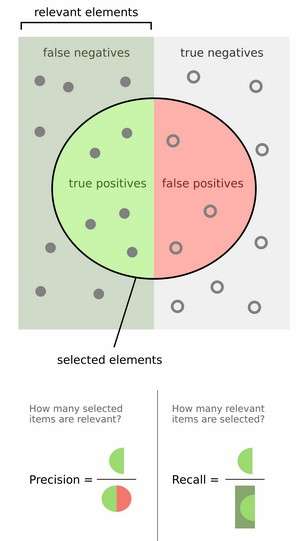
图中上部分,左边一整个矩形中(false negative 和 true positive)的数表示 ground truth 之中为 1 的(即为正确的)数据,右边一整个矩形中的数表示 ground truth 之中为 0 的数据。
精度 precision 的计算是用 检测正确的数据个数/总的检测个数。
召回率 recall 的计算是用 检测正确的数据个数/ground truth 之中所有正数据个数。
- AP:average precision
假设我们有数据: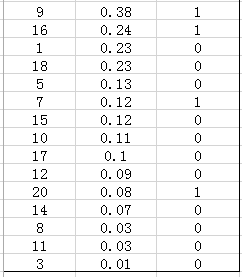
一共 20 个图像,20 行,第一列是图像 index,第二列是检测 confidence,第三列是 ground truth。根据 confidence 从大到小排列。
每检测一个图像时,无论是正例还是负例,计算当下的 precision 和 recall。
假设检测样本中每 N 个样本中有 M 个正例,那么我们会得到 M 个 recall 值(1/M, 2/M, …, M/M)(由于检测 N’ 数量正样本时,precision 有不同情况),对于每个 recall 值 r,我们可以计算出对应(r’ > r)的最大 precision,然后对这些 max precision 取平均即得到最后的 AP 值。具体计算如图,top-N 是指根据 confidence 降序排列后样本的排位号(eg. 1 为 confidence 最大的图像 9):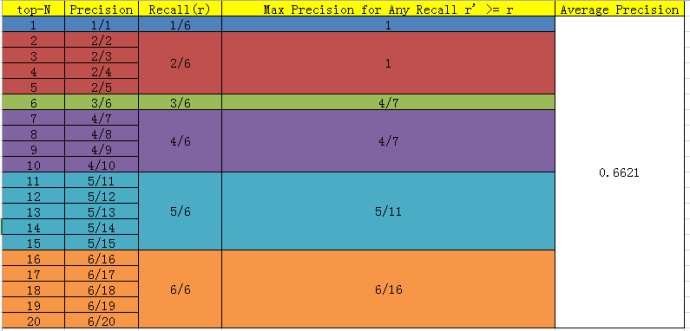
- mAP: mean average precision
多类的检测中,取每个类 AP 的平均值,即为 mAP。
既然说到了分类任务的评价办法,顺便就把 top x 也提一句好了。通常是 top1、top5。
top1 就是你预测的 label 取最后概率向量里面最大的那一个作为预测结果,你的预测结果中概率最大的那个类必须是正确类别才算预测正确。而 top5 就是最后概率向量最大的前五名中出现了正确概率即为预测正确。