最近在重新过 MIT 6.S191 Lecture 3(卷积神经网络)。2017 年刚接触 CV 那会儿,CNN 算是吃饭的家伙,每天都在调。后来精力逐渐转到 ML Infra,成天跟 GPU 显存、通信拓扑和算子优化打交道,卷积网络的很多具体细节就慢慢生疏了——写个 nn.Conv2d 时 weight 的四维形状到底怎么排、Kaiming 初始化的方差怎么推、感受野怎么算,冷不丁被问到,还得在脑子里卡壳一下。
这次顺着课件从头过了一遍,最大的体会是:那些具体的输出尺寸公式、经典模型的层数、固定的 Conv → ReLU → Pool 模板,确实不用死记,需要时翻一眼手册或者 print 一下 shape 就行。反而是以前天天写、觉得理所当然以至于忽略掉的几个底层设计,这次回看时体会更深:
- 为什么处理图像必须从局部看起?
- 为什么一套参数可以在整张图上满场复用?
- 为什么卷积天然是平移等变而不是平移不变?
- 单层卷积只看小窗口,网络深层到底是怎么看到全局的?
- 空间上的变换和通道上的变换,为什么可以解耦开?
说白了,就是当初卷积神经网络为了吃下视觉数据,到底在模型结构里硬编码了哪些先验假设。
拉平成一维接全连接,到底不行在哪?#
拿一张常见尺寸的 RGB 图像来说:
1224 × 224 × 3最直观的暴力做法,就是把它展开成一个 150,528 维的向量,然后接全连接层(Fully Connected Layer)。
以前大家聊到这,第一反应通常是"参数量爆炸":如果隐层开 1024 维,光第一层权重就有一亿五千万个参数,显存和算力根本顶不住。
但这只是工程层面的代价,还有一个更根本的拓扑问题——展开成一维向量之后,网络结构彻底丢失了输入的二维空间邻近关系。
在原始图像里,像素点 (100, 100) 和 (101, 100) 紧挨在一起。但拉平之后,它们无非是向量里两个普通的维度,跟 (0, 0) 与 (223, 223) 的距离在全连接层看来毫无区别。全连接层对每个输入维度都有独立的权重,把所有位置一视同仁,完全不知道输入数据本来带有二维网格拓扑。
如果图像左上角出现了一条边缘,右下角也出现了一条边缘,在物理世界里它们是同一种局部几何结构;但全连接层由于缺乏空间先验,必须给每个位置分配不同的权重重新硬学一遍。
卷积神经网络(CNN)的核心选择恰好相反:显式把图像的空间几何结构做进网络架构里。一个神经元一开始只关注局部的一小块区域,而不是一次性看完整张图。
这种在模型结构中预先注入的数据偏好,就是归纳偏置(inductive bias)。选择一种网络架构,本质上就是在告诉模型:哪些数据关联更值得优先建模。对 CNN 来说,第一个硬编码的假设就是——空间上相邻位置的关联,远比远距离位置更值得优先处理。
为什么图像必须先看局部?#
自然图像里的信息不是均匀散落的。边缘、纹理、角点、色块平滑过渡,这些最基础的视觉基元,本质上都只依赖相邻像素之间的差异与配合。离得八丈远的两个像素点,在低层次特征上几乎没有任何直接因果关联。
CNN 通过局部连接(local connectivity)把这个先验固化在网络中:每个输出单元只和输入的一个局部小窗口相连。
平时写网络时大家习惯了 3×3 卷积核,但这里容易有一个误区:3×3 本身不是什么精妙的数学魔法,真正起作用的是限制在局部邻域内建模关联。无论换成 5×5 还是 7×7,局部连接的核心假设没有变。之所以选小尺寸,主要是为了在获得同样感受野的前提下,用更少的参数堆出更深的非线性层。
左上角学会的特征,右下角为什么不用重学?#
假设网络已经学会了识别一种局部模式,比如一条垂直边缘。这条边缘出现在图像左上角,或者出现在右下角,在局部几何结构上没有任何区别。
如果图像上的每个空间位置都分配一套独立的卷积核权重,就意味着同样的竖线特征,在左上角学了一遍,挪到右下角又得从零再学一遍。
CNN 的解法是权重共享(weight sharing):同一个卷积核(kernel)在整张图的所有空间位置上滑动复用。
很多人复习时容易把权重共享单纯记成"为了减少参数量"。减少参数确实是直接收益,但更深层的设计假设是:视觉特征在统计上具有平移同质性,同一种特征变换在不同空间位置上完全可以复用。
这并非碰巧节省了参数,而是设计者明确认定:在自然图像里,局部特征提取规则不随绝对坐标的改变而改变。
卷积核到底长什么样:[out_channels, in_channels, k, k]#
概念上经常把 kernel 和 filter 混着叫,落到具体实现上,它到底是什么张量?
对于标准的 2D 卷积,输入通常是四维张量(忽略 batch 维度就是 \(H \times W \times C_{in}\))。一个 filter 在空间上只看一个很小的窗口 \(K_h \times K_w\),但在通道维度上,它必须一次性吃下输入的全部通道 \(C_{in}\)。
在 PyTorch 里写一行:
1nn.Conv2d(in_channels=3, out_channels=64, kernel_size=3)这一层的权重形状是:
1[64, 3, 3, 3]
也就是 [out_channels, in_channels, kernel_h, kernel_w]。
- 共有 64 个 filter;
- 每个 filter 本身是一个三维体积块(
3 × 3 × 3),在当前滑窗位置将所有输入通道的数据做内积求和,产出单个标量; - 一个 filter 扫完整张图,产出一张二维特征图(feature map);
- 64 个 filter 各自独立滑动,就堆叠出了 64 个输出通道。
这个参数形状以前天天用,但时间一长容易忽视一个基本事实:卷积核里面的权重不是硬编码的固定算子,而是一组纯粹的可学习参数。 它们和全连接层的权重一样,参与端到端的梯度反向传播,由优化器根据任务 loss 自动更新。
从传统手工算子到端到端特征学习#
在传统数字图像处理里,经常会见到类似 Sobel 的水平梯度算子:
1-1  0  1
2-2  0  2
3-1  0  1
它的系数是人工设计的,目的极其单一:计算水平方向的像素差分,用来提取垂直边缘。
初学 CNN 时,大家很喜欢拿 edge detector 来建立直觉——事实上,训练好的浅层卷积核可视化出来,确实常常呈现出类似 Gabor 滤波器或边缘检测器的形态。
但必须把直觉和定义分开:卷积核的定义绝不是"边缘检测器"。CNN 的核心突破,是把"具体提取什么特征"的选择权从人工手工设计,交给了端到端优化。 网络在浅层学边缘、在深层学语义组合,完全是由梯度反向传播驱动的,而不是靠人脑预先指定一套滤波模板。
初始权重为什么不能随便给?#
既然卷积核是一堆可学习参数,训练从随机初始化开始,那这个"随机"能不能随便从标准正态分布里采几个数?
这也是重温课件时一个值得重新推导的细节。初始化要同时解决两个矛盾:既要打破对称性,又要维持前向与反向传播的信号尺度。
为什么不能全初始化成 0?#
如果所有卷积核权重都初始化成 0(或者完全相同的值):
1Filter 1 = Filter 2 = Filter 3 = ... = 0在前向传播时,它们对同样的输入产出完全一致的激活值;反向传播时,每个 filter 拿到的梯度也完全一致;优化器更新后,所有 filter 依然丝毫不差。这意味着无论训练多少个 step,多个 filter 永远无法分化成提取不同特征的检测器,等价于整个网络只有一个通道。
因此必须通过随机初始化来打破对称性(Symmetry Breaking)。
方差控制与卷积的 fan-in#
光打破对称性还不够。如果初始权重方差偏大,经过多层连续卷积后,特征值会逐层指数级放大最终溢出;如果方差偏小,信号经过几十层之后衰减归零,梯度反向传播时也随之消失。
针对这个问题,何恺明提出了针对 ReLU 激活函数的 Kaiming 初始化(He initialization)。其核心推导是根据每一层的输入连接数(fan-in)来动态缩放权重方差:
$$ W \sim \mathcal{N}\!\left(0,\;\frac{2}{fan_{in}}\right) $$对于全连接层,fan-in 就是输入的特征维度。但对于卷积层,一个输出点实际看到的输入数量不仅包含通道数,还要乘上卷积核的空间面积:
$$ fan_{in} = C_{in} \times K_h \times K_w $$
以一个普通的 in_channels = 64、kernel_size = 3 的卷积层为例:
1fan_in = 64 × 3 × 3 = 576分子的 2 则来自于 ReLU 激活函数将大约一半的负信号截断为 0,为了维持方差守恒必须做 2 倍补偿。
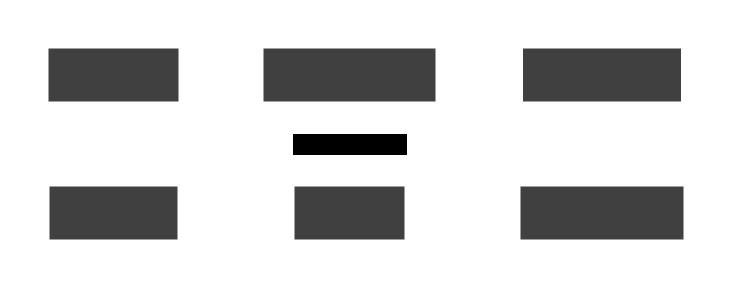
现在的深度学习框架都封装好了默认初始化,日常写模型极少需要手算。但这里的心智模型值得记住:初始化不是随意随机,而是在打破对称性的同时,利用 fan-in / fan-out 精确控制方差,确保深层网络的信号既不爆炸也不消失。
平移等变(Equivariance)还是平移不变(Invariance)?#
以前很多教程和面试题里经常粗暴地总结:“CNN 具有平移不变性。”
重新翻讲义时会发现,这个表述其实不够严谨。卷积操作本身具有的是平移等变性(Translation Equivariance),而不是平移不变性(Translation Invariance)。
等变性的数学形式是:先平移再卷积,等价于先卷积再平移。
$$ \text{Conv}(T(x)) = T(\text{Conv}(x)) $$如果输入图像里的目标从左侧移到了右侧,卷积计算出的响应特征图(feature map)上,代表该目标的高响应区域也会同步向右平移。卷积本身保留了目标的位置变动,而不是抹平位置。
真正的不变性(Invariance)是指:不管目标在画面左边还是右边,整个系统最终给出的分类概率都稳定输出该类别。这种不变性主要不是单层卷积提供的,而是通过后续的池化(Pooling)、全局平均池化(Global Average Pooling)逐步汇总降维,把空间分布压缩掉之后才形成的。
3x3 卷积是怎么看到整张图的?#
如果每一层卷积都只老老实实看 3×3 的微小区域,深层网络凭什么能理解整张大图上的全局语义?
答案就在于层级表征(Hierarchical Representation)与感受野(Receptive Field)的逐层累加。
网络并不是一次性理解整张图的,而是通过深度组合特征:
- 浅层卷积:处理原始像素,组合出边缘、角点等基础纹理;
- 中层卷积:以浅层的局部特征为输入,组合出器官、轮廓、简单部件;
- 深层卷积:在更大感受野上整合各个部件,形成完整的语义对象。
支撑这一组合机制的核心概念就是感受野(Receptive Field)。
以 stride=1、padding=0 的 3×3 卷积为例:
- 第 1 层输出的一个点,覆盖输入的
3×3像素; - 第 2 层输出的一个点,覆盖第 1 层的
3×3区域,对应到原始输入就是5×5; - 第 3 层输出的一个点,对应到原始输入就是
7×7。
每叠加一层 3×3 卷积,理论感受野就向外扩展 2。
这也是 VGG 最经典的洞见:用两个堆叠的 3×3 卷积替代一个 5×5 卷积,或者用三个 3×3 替代一个 7×7。两者覆盖的有效视野完全一样,但堆叠小卷积能引入更多次非线性激活(ReLU),而且参数量显著更少(三个 3x3 是 \(3 \times 3^2 = 27\),单个 7x7 是 \(7^2 = 49\))。
只要网络足够深,局部的滑动计算就能自然长成覆盖全图的全局视野。
特征张量怎么看:空间网格与通道向量#
CNN 中间层的输出通常是一个形状为 \(H \times W \times C\) 的三维特征张量。
以前写代码,直觉上容易把它想象成"叠在一起的 \(C\) 张黑白单通道图片"。但从表征学习的角度看,更自然的心智模型是:
在空间二维网格的每一个坐标 \((i, j)\) 上,都存在一个 \(C\) 维的稠密特征向量:
$$ h_{ij} \in \mathbb{R}^C $$
例如 56 × 56 × 256 的特征图,本质上是 56×56 个离散空间位置,每个位置持有一个 256 维的语义嵌入向量。
通道维度 \(C\) 并不是简单孤立的切片,而是模型学到的隐式特征空间。这 256 维向量的组合,共同描述了输入图像在当前局部视野内的语义状态。
3x3 卷积 vs 1x1 卷积:空间混合与通道混合#
建立了上面"网格上的特征向量"视角后,再看卷积操作,就可以清晰地拆解成两个正交维度的计算:
- 空间混合(Spatial Mixing):信息有没有在不同的空间坐标之间流动传递?
- 通道混合(Channel Mixing):信息有没有在同一个位置的不同通道之间做线性投影与重组?
3x3 卷积:空间与通道同时混合#
每个输出点不仅同时汇聚了局部邻域内 9 个位置的信息(空间混合),还在每个邻域位置上吃满了全部输入通道(通道混合)。因此标准卷积是一次性把空间邻近信息与通道特征深度搅合在一起的运算。
1x1 卷积:纯粹的通道混合#
很多人刚接触 1×1 卷积时都会纳闷:窗口大小只有 1,根本不看周围像素,它到底在"卷"什么?
如果从向量视角看就非常直白了:1×1 卷积在空间上寸步不动,它只是在每个位置 \((i, j)\) 上,把当前对应的 \(C_{in}\) 维向量通过一个矩阵相乘,线性投影到 \(C_{out}\) 维:
并且整张图的所有空间位置,共享这同一个线性变换矩阵。
1x1 卷积完全不做空间混合,它是纯粹的通道混合(Channel Mixing)。 它的作用就是无缝升维、降维(如 ResNet bottleneck)、跨通道特征融合。这个把空间操作和通道操作解耦的思路,后来也直接孕育了 MobileNet 的深度可分离卷积(Depthwise Separable Convolution)。
下采样金字塔与那些查手册就行的公式#
典型的视觉骨干网络都会形成一个分辨率递减、通道数递增的特征金字塔:
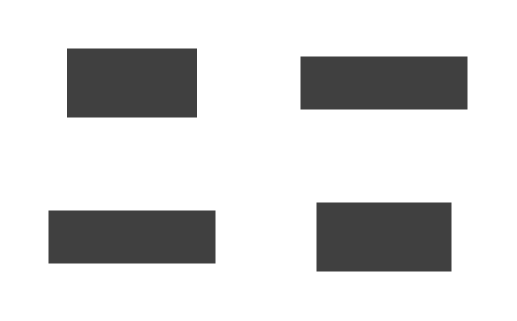
1224 × 224 × 64
2      ↓
3112 × 112 × 128
4      ↓
5 56 ×  56 × 256
6      ↓
7 28 ×  28 × 512
随着网络变深,空间分辨率逐步牺牲,换来的是感受野的成倍扩张与语义维度的成倍提升。
为了实现空间降采样,经典做法是池化(Max/Average Pooling),它通过局部聚合减少计算量并扩大感受野。不过后来的很多现代网络更倾向于直接用 stride > 1 的跨步卷积来代替池化,把降采样的下采样规则也交给网络自主学习。
至于卷积前后的具体尺寸变换公式:
$$ H_{out} = \left\lfloor \frac{H + 2P - K}{S} \right\rfloor + 1 $$这类算术推导在实际写网络或写算子测试时,现场算一下或者在终端里打印一下张量形状即可,完全不需要当作什么高深的理论反复背诵。
剥掉具体实现后,真正留下的是什么?#
回看当初学 CNN 时整理的满篇笔记,大部分内容都在死磕卷积核尺寸、步长、填充规则、池化层参数,以及 AlexNet、VGG、ResNet 各自堆了多少层。
时隔多年再看,这些具体数字和固定模板早就随着模型迭代而褪色了。真正穿透时间、至今依然在指导视觉架构设计的,是当初为了处理图像而量身打磨的几条核心归纳偏置(inductive bias):
- 局部连接(Locality):尊重图像数据的空间相关性,特征提取优先在局部邻域展开;
- 权重共享(Weight Sharing):基于视觉规律的平移同质性,一套特征提取规则全图复用;
- 平移等变(Translation Equivariance):目标位置变动,特征响应同步平移,保留空间拓扑;
- 层级组合(Hierarchical Composition):用深度和感受野的逐层累加,把低阶线条拼成高阶语义;
- 解耦变换(Decoupled Mixing):空间混合负责拓扑聚合,通道混合负责表征投影。
从本质上讲,任何一种成功的深度学习网络结构,都不是凭空堆砌矩阵乘法,而是把人类对特定物理数据的深刻理解,以数学约束的形式硬编码进架构中。
离开 CV 几年、转做 ML Infra 后,日常大部分时间都在跟显存碎片、通信拓扑、算子融合与并行策略较劲。偶尔抽空跳出算子性能的微观视角,回过头重温经典模型最质朴的结构设计,依然会觉得这种数据物理规律与网络先验之间的严整映射非常迷人。
参考资料#
- MIT 6.S191 Lecture 3: Convolutional Neural Networks https://introtodeeplearning.com
- He, K. et al., “Delving Deep into Rectifiers: Surpassing Human-Level Performance on ImageNet Classification,” ICCV 2015
- Glorot, X. and Bengio, Y., “Understanding the difficulty of training deep feedforward neural networks,” AISTATS 2010