起因#
最近在补概率基础的时候,碰到一个解释:连续分布中,每一个单点的概率都是 0,但整个区间的概率可以是 1。
我的第一反应是——如果每一个点的概率都是 0,那么把这些点全部加起来:
$$ 0 + 0 + 0 + \cdots = 0 $$不还是 0 吗?为什么最终会得到 1?
追这个问题的过程中,我发现自己一直有一个默认假设:无限就是无限,没有什么大小之分。
但实际上,Countable Infinity(可数无限)和 Uncountable Infinity(不可数无限)是完全不同的东西。这个区分直接决定了"无穷多个 0 相加"到底能不能像普通级数一样操作。
概率密度的具体机制留到下一篇。这篇先把更基础的问题解决:无限到底有没有大小之分?
怎么比较两个无限集合的大小#
先从有限集合出发。
假设有两个集合:
- A = {苹果,香蕉,橘子}
- B = {1,2,3}
即使不去"数"它们各有几个元素,也可以把它们的元素一对一配对:
- 苹果 ↔ 1
- 香蕉 ↔ 2
- 橘子 ↔ 3
双方都没有剩余元素,那么它们就一样大。
这种"一对一配对"在数学上叫 Bijection(双射,也叫一一对应)。准确地说:如果集合 A 和集合 B 之间存在一个映射 \(f: A \to B\),使得 A 中每个元素恰好对应 B 中一个元素,且 B 中每个元素恰好被对应一次,那么 \(f\) 就是一个双射。
存在双射的两个集合,称为具有相同的 Cardinality(基数)——直观理解就是"大小相同"。
对有限集合,一一对应和"数元素个数"看起来没什么区别,两种方法都能用。
但一旦进入无限集合,“数完"这件事本身就不可能了。这时候"一一对应"就成了唯一可用的工具。
自然数和偶数居然一样多#
先看一个最简单的例子。
- \(\mathbb{N}\) = {1, 2, 3, 4, 5, …}(自然数)
- E = {2, 4, 6, 8, 10, …}(偶数)
E 是 \(\mathbb{N}\) 的真子集——每一个偶数都是自然数,但自然数里还有奇数。按有限集合的直觉:真子集一定比原集合小。
但如果构造一个映射 \(f(n) = 2n\):
- 1 ↔ 2
- 2 ↔ 4
- 3 ↔ 6
- 4 ↔ 8
- 5 ↔ 10
- …
每个自然数都有唯一对应的偶数,每个偶数也有唯一对应的自然数。没有剩余。
所以 \(|\mathbb{N}| = |E|\)。自然数和偶数一样多。
这里真正奇怪的地方在于:一个无限集合可以和自己的真子集拥有相同的基数。这在有限集合里绝不可能发生。你不可能从一个 5 元素的集合里去掉一些元素之后,剩下的还是 5 个。但无限集合可以。
这其实就是无限集合和有限集合最根本的区别之一。有一个著名的思想实验 Hilbert’s Hotel(希尔伯特旅馆)说的也是这件事:一家有无限个房间的旅馆,即使住满了,再来一位客人,只要让每位现有住客搬到下一个房间(n 号搬到 n+1 号),1 号房就空出来了。住满了还能再塞人——正是因为无限集合可以和自己的真子集等大。
“可数"到底是什么意思#
现在引入一个概念:Countable(可数)。
“可数"这个词非常容易产生误解,因为它听上去像"最终可以数完”。但自然数本身就永远数不完,而自然数恰恰是可数的标杆。
Countable 的真正含义是:一个集合的所有元素能不能用自然数编号?
也就是说,是否存在某种排列方式:
$$ x_1, x_2, x_3, x_4, \ldots $$使得集合中的每一个元素都出现在这个序列里的某个位置。
如果可以,这个集合就是 Countably Infinite(可数无限)的。
从程序员的视角换个说法可能更直观:是否存在一种枚举算法,对于集合中任意一个元素 \(x\),都存在一个有限的编号 \(n\),使得 \(x\) 出现在第 \(n\) 个位置?不是说程序真的有时间运行到无限远——而是对于你想找的任意一个目标元素,它在序列中的位置都是某个具体的有限数字。
整数也是可数的#
整数集 \(\mathbb{Z}\) = {…, -3, -2, -1, 0, 1, 2, 3, …} 看起来比自然数"多了一倍还不止”——正数、负数再加一个 0。
但只要换一种遍历顺序:
$$ 0,\ 1,\ -1,\ 2,\ -2,\ 3,\ -3,\ \ldots $$从 0 开始,先走正方向一步,再走负方向一步,交替进行。
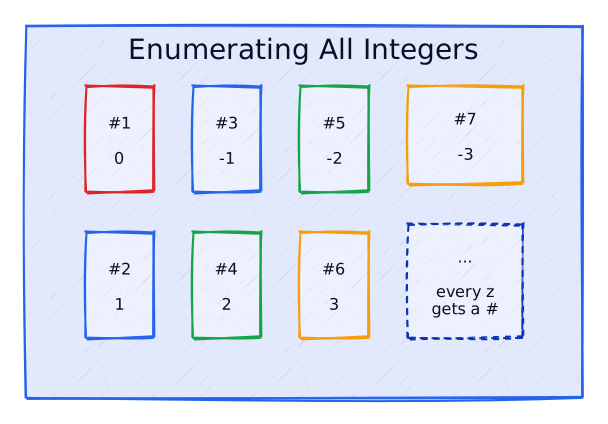
这个序列覆盖了所有整数,而且每个整数都出现在某个有限编号的位置上。所以整数也是可数的:\(|\mathbb{Z}| = |\mathbb{N}|\)。
这里的关键是:能否设计出一个不会永远卡在某一部分、最终覆盖所有元素的枚举顺序? 如果先把所有正整数列完再列负整数,那永远到不了负数部分。正是因为交替的遍历策略,每个元素才不会被永久"饿死”。
有理数居然也是可数的#
Rational Number(有理数)指的是可以写成 \(\frac{p}{q}\) 的数,其中 \(p\)、\(q\) 为整数且 \(q \neq 0\)。
有理数在数轴上看起来密得不可思议。任意两个不同的实数之间,都有无限多个有理数。哪怕是 0.5 和 0.5000001 之间,仍然塞着无穷多个有理数。
这种性质叫做 Dense(稠密):有理数在实数轴上稠密,意思是数轴上任意两点之间必有有理数。
于是直觉上很自然会觉得:这么密的东西,怎么可能还能一个一个编号?
我最初也以为"稠密"意味着"多到不可数"。后来才发现这是两个完全不同维度的事情。
稠密描述的是元素在空间里的分布有多紧凑——两点之间总能找到更多元素。基数描述的是集合里一共有多少元素。这是两个独立的概念。
用二维表格和对角线遍历来编号有理数#
为了证明有理数可数,先只考虑正有理数,把它们排成一张二维表格。行代表分母 \(q\),列代表分子 \(p\),每个格子就是 \(\frac{p}{q}\):
| p=1 | p=2 | p=3 | p=4 | … | |
|---|---|---|---|---|---|
| q=1 | 1/1 | 2/1 | 3/1 | 4/1 | … |
| q=2 | 1/2 | 2/2 | 3/2 | 4/2 | … |
| q=3 | 1/3 | 2/3 | 3/3 | 4/3 | … |
| q=4 | 1/4 | 2/4 | 3/4 | 4/4 | … |
| … | … | … | … | … | … |
这张表格里包含了所有正有理数(有重复,比如 1/1 和 2/2 和 3/3 都是 1,但先不管重复)。
现在问题变成了:怎么用自然数编号去遍历这张无限大的二维表格?
一种自然的想法是先遍历第一行(q=1),再遍历第二行(q=2),依此类推。但第一行自己就是无限的——1/1, 2/1, 3/1, 4/1, …——永远走不完,根本到不了第二行。这就像在一个无限图上做深度优先搜索,一头扎进某条无限分支就再也出不来。
正确的方法是沿对角线遍历。按照 \(p + q\) 的值从小到大,依次访问:
- \(p + q = 2\):1/1
- \(p + q = 3\):2/1,1/2
- \(p + q = 4\):3/1,2/2,1/3
- \(p + q = 5\):4/1,3/2,2/3,1/4
- …
对于任意一个正有理数 \(\frac{p}{q}\),它位于第 \(p + q - 1\) 条对角线上。这条对角线的编号是有限的,对角线上的元素数量也是有限的。所以 \(\frac{p}{q}\) 一定会在某个有限步骤被访问到。
重复怎么处理?2/4 和 1/2 和 3/6 都是同一个有理数。办法很简单:遇到 \(\gcd(p, q) \neq 1\) 的分数就跳过,只保留最简分数。跳过之后,剩下的序列仍然是自然数的一个子序列,所以仍然可以从 1 开始重新编号。
加上负有理数和 0 也不影响结论——正有理数序列和负有理数序列各自可数,0 是一个元素,三者交替排列即可。
所以:\(\mathbb{Q}\)(有理数集)是 Countably Infinite(可数无限)的。
从 CS 视角看"可数"#
这个证明过程其实很像一类算法问题:给你一个无限结构,要求设计一种遍历策略,保证公平地覆盖所有元素。
证明可数,就是在证明存在一种 complete enumeration——一种保证最终不会遗漏任何元素的枚举方式。
- 自然数:直接顺序枚举。
- 整数:0, 1, -1, 2, -2, …——交替枚举。
- 有理数:二维无限网格的 diagonal traversal(对角线遍历)。
如果把这张二维表格看成无限图的邻接矩阵,对角线遍历的思路就很像 BFS:按"距离"(这里是 \(p + q\) 的值)逐层扩展,保证每一层都在有限时间内处理完毕,才进入下一层。DFS 会沿一条路径走到底,在无限图上就意味着永远卡在某一条分支里。BFS 的公平性保证了每个节点都能在有限步内被访问。
是不是所有无限集合最终都能编号#
到这里,故事一路顺利:自然数可数,偶数可数,整数可数,有理数居然也可数。很容易形成一个新的直觉——只要足够聪明地设计遍历顺序,任何无限集合都能用自然数编号吧?
考虑一个很小的集合:区间 [0, 1] 中的所有 Real Numbers(实数)。
能不能把它们写成一个序列?
$$ x_1, x_2, x_3, x_4, \ldots $$答案是:不行。
不是"暂时没找到合适的编号方式",而是数学上可以证明,任何试图列出 [0, 1] 中所有实数的编号方案都必然遗漏一些实数。
康托尔对角线论证#
这就是 Cantor’s Diagonal Argument(康托尔对角线论证),由 Georg Cantor 在 1891 年给出。论证方法是 Proof by Contradiction(反证法)。
假设 [0, 1] 中的所有实数是可数的。那么一定存在某张"完整列表",把它们全部排好:
$$ x_1 = 0.a_{11}a_{12}a_{13}a_{14}\ldots $$$$ x_2 = 0.a_{21}a_{22}a_{23}a_{24}\ldots $$$$ x_3 = 0.a_{31}a_{32}a_{33}a_{34}\ldots $$$$ x_4 = 0.a_{41}a_{42}a_{43}a_{44}\ldots $$$$ \vdots $$这里 \(a_{ij}\) 是第 \(i\) 个实数的小数点后第 \(j\) 位数字(0 到 9 之间)。这张列表声称:[0, 1] 中的每一个实数,都在列表里的某一行。
现在取对角线上的数字:\(a_{11}, a_{22}, a_{33}, a_{44}, \ldots\)
用这些数字构造一个新的实数 \(y = 0.b_1 b_2 b_3 b_4 \ldots\),构造规则是:
$$ b_n = \begin{cases} 2 & \text{if } a_{nn} = 1 \\ 1 & \text{otherwise} \end{cases} $$这里刻意只使用数字 1 和 2,是为了避免十进制表示的一个技术细节:0.4999… 和 0.5000… 其实是同一个实数。只用 1 和 2 两种数字,就不会碰到这种边界情况。
举个具体例子。假设列表的前五行是:
- \(x_1 = 0.\mathbf{[5]}1414\ldots\)
- \(x_2 = 0.3\mathbf{[6]}271\ldots\)
- \(x_3 = 0.80\mathbf{[1]}94\ldots\)
- \(x_4 = 0.237\mathbf{[8]}5\ldots\)
- \(x_5 = 0.9102\mathbf{[1]}\ldots\)
对角线数字是 5, 6, 1, 8, 1, …
按规则翻转:5 不是 1 → 取 1;6 不是 1 → 取 1;1 是 1 → 取 2;8 不是 1 → 取 1;1 是 1 → 取 2;…
所以 \(y = 0.11212\ldots\)
现在检查 \(y\) 是否在列表里:
- \(y\) 和 \(x_1\):第 1 位不同(\(y\) 的第 1 位是 1,\(x_1\) 的第 1 位是 5)
- \(y\) 和 \(x_2\):第 2 位不同
- \(y\) 和 \(x_3\):第 3 位不同
- 一般地:\(y\) 和 \(x_n\) 在第 \(n\) 位一定不同
所以 \(y \neq x_n\) 对所有 \(n\) 都成立。\(y\) 不在列表里。
但 \(y\) 显然是 [0, 1] 中的一个实数(它的每一位只是 1 或 2,所以 \(y\) 在 0.111… = 1/9 和 0.222… = 2/9 之间)。
矛盾。
所以最初的假设——"[0, 1] 中所有实数可以排成一个完整列表"——是错的。
[0, 1] 是 Uncountable(不可数)的。
Cantor 证明真正在做什么#
这个证明的力量不在于"找到了某一张列表漏掉的数"。
如果只是某张具体列表漏了一个数,你可以说"那我把这个数补进去不就行了?"。
但 Cantor 做的事情是:给定任意一张声称完整的列表,我都有一个通用的构造方法,可以根据这张列表本身制造出一个一定不在其中的实数。
不管你怎么排列,不管你的列表有多"聪明",我总能用你自己的对角线打败你。
从 CS 的视角看,这相当于:
- 输入:任意一个声称枚举了所有实数的程序
- 输出:一个该程序永远输出不了的反例
这个结构在理论计算机科学里也有深远的影响——停机问题、哥德尔不完备定理的证明里都能看到类似的对角线构造。但这些不是今天的主题。
无限确实有不同的大小#
到这里可以正式总结了。
前面一路证明下来:
- \(\mathbb{N}\)(自然数):可数无限
- \(\mathbb{Z}\)(整数):可数无限
- \(\mathbb{Q}\)(有理数):可数无限
- \(\mathbb{R}\)(实数,以及 [0, 1]):不可数
所以:
$$ |\mathbb{N}| = |\mathbb{Z}| = |\mathbb{Q}| \lt |\mathbb{R}| $$
Cardinality(基数)就是描述"集合有多少元素"的抽象概念。对有限集合,基数就是普通的元素个数。对无限集合,基数通过一一对应来比较。
自然数的基数通常记作 \(\aleph_0\)(aleph-null,读作 aleph zero)。实数的基数被称为 continuum(连续统)的基数,记作 \(\mathfrak{c}\)。上面的结论就是 \(\aleph_0 \lt \mathfrak{c}\)——可数无限严格小于连续统的基数。
至于 \(\aleph_0\) 和 \(\mathfrak{c}\) 之间是否还有其他大小的无限——这就是 Continuum Hypothesis(连续统假设),已经被证明在标准公理系统下既不能被证明也不能被证否。这些超出了本文的范围。
为什么无理数必须不可数#
Irrational Numbers(无理数)是实数中去掉有理数之后剩下的部分。
$$ \mathbb{R} = \mathbb{Q} \cup \mathbb{I} $$其中 \(\mathbb{Q}\) 是有理数,\(\mathbb{I}\) 是无理数,两者不重叠。
已知 \(\mathbb{Q}\) 可数,\(\mathbb{R}\) 不可数。假设 \(\mathbb{I}\) 也可数,那会怎样?
两个可数集合的并集仍然可数。这一点容易验证:如果 A 和 B 都可以排成序列:
$$ A: a_1, a_2, a_3, \ldots $$$$ B: b_1, b_2, b_3, \ldots $$那么把它们交替排列:
$$ a_1, b_1, a_2, b_2, a_3, b_3, \ldots $$就得到了一个覆盖 \(A \cup B\) 所有元素的序列(如果有重复,跳过即可)。所以 \(A \cup B\) 仍然可数。
回到主线:如果 \(\mathbb{Q}\) 和 \(\mathbb{I}\) 都可数,那么 \(\mathbb{R} = \mathbb{Q} \cup \mathbb{I}\) 也应该可数。但 \(\mathbb{R}\) 不可数——矛盾。
因此 \(\mathbb{I}\)(无理数集)必须是不可数的。
稠密和不可数是两回事#
这个区分值得再强调一次,因为直觉上太容易混淆。
- 有理数 \(\mathbb{Q}\):在实数轴上稠密,但可数。
- 无理数 \(\mathbb{I}\):在实数轴上也稠密,但不可数。
两者在数轴上的"密度"看起来差不多——任意两个实数之间,既有无穷多个有理数,也有无穷多个无理数。但它们的基数完全不在一个量级上。
稠密讨论的是"缝隙"——元素之间还能不能再插进去别的。基数讨论的是"总量"——整个集合到底有多大。
一个集合可以在空间里分布得极其稀疏却不可数,也可以在空间里分布得极其稠密却仍然可数。这两个维度是完全独立的。
回到最初的问题#
现在可以重新回答开头的疑问了。
设 \(X\) 服从 [0, 1] 上的连续均匀分布。对于任何一个具体的实数 \(x\),\(P(X = x) = 0\)。
如果只取所有有理数 \(q_1, q_2, q_3, \ldots\)(因为有理数可数,所以可以这样列出来),那么:
$$ P(X \in \mathbb{Q} \cap [0,1]) = P(X = q_1) + P(X = q_2) + P(X = q_3) + \cdots = 0 + 0 + 0 + \cdots = 0 $$这完全没问题,可数多个 0 相加确实等于 0。
但 [0, 1] 中的全部实数是不可数的。它们不能写成一个序列 \(x_1, x_2, x_3, \ldots\)。所以 \(P(X \in [0,1])\) 根本没法展开成普通的无限级数。
概率公理中保证的是 Countable Additivity(可数可加性):对于可数多个互斥事件 \(A_1, A_2, A_3, \ldots\),有
$$ P\left(\bigcup_{i=1}^{\infty} A_i\right) = \sum_{i=1}^{\infty} P(A_i) $$但这个性质只适用于可数多个事件的并。不可数多个事件不能直接套用这个公式。
所以"每个点概率为 0"和"整个区间概率为 1"之间并不矛盾。矛盾只在你试图把不可数多个单点概率像普通级数一样加起来的时候才出现——而概率公理从来没有允许你这么做。
那如果不能给每一个点分配一个概率然后加起来,连续随机变量的概率到底怎么描述?答案是 Probability Density(概率密度)。这是下一篇的内容。
写在最后#
我最开始只是被一个概率问题卡住了:一个点的概率是 0,一个区间的概率为什么不是 0?沿着这个问题往下追,发现真正缺失的不是某个概率公式,而是一个更基础的认知——我从来没有认真区分过可数无限和不可数无限。
几个到现在还觉得有点反直觉的事情:
- 偶数只是自然数的一部分,但它们一样多。
- 有理数在数轴上无处不在、密得没有缝隙,但仍然是可数的。
- Cantor 的对角线论证不是在攻击某一张特定的列表,而是证明了所有可能的列表都不够用。
- 稠密和不可数是两个完全不同的概念。
这个障碍清除之后,下一个问题就自然了:既然连续变量不能靠给每一个点分配概率来描述,那应该怎么描述?这就是下一篇要讲的——概率密度不是概率。
参考资料#
- Georg Cantor, Über eine elementare Frage der Mannigfaltigkeitslehre, 1891
- Halmos, Naive Set Theory, Springer
- 陶哲轩, Analysis I, Hindustan Book Agency — Chapter 8: Countability