之前我负责过一个推荐系统深度学习 Serving 框架的功能开发与性能优化。
我们的系统主要跑在 CPU 上,以 TensorFlow 为主力 inference engine。随着模型迭代,尤其是 Embedding 层越来越大,模型导出、传输和上线变得非常慢,Serving 节点的内存成本也眼看着往上飙。
为了省内存,系统开始支持 FP16 和 INT8 的模型压缩。
方案上线后,模型体积是小了,内存是省了,但单次请求的推理耗时却肉眼可见地变长了。
内存是省下来了,但延迟涨了#
当时评估压缩方案时,第一目标就是「省 Serving 内存」。
我们不是没想过全链路低精度方案:把 DNN 和 Embedding 全部用低精度,甚至迁到 GPU 上跑 TensorRT。但线上的现实是 GPU 资源不足,系统改造成本极高,而且还要解决 INT8 calibration 等一系列工程麻烦。
第二个想到的方案是:只用低精度保存 Embedding,上线加载时一次性恢复成 FP32。这能解决模型传输大小,但 Serving 内存并没有省下来,意义有限。
最后选定的方案是:Embedding 继续以 FP16 / INT8 的形式常驻内存。
这主要是因为推荐模型的一个特点:每个请求实际上只会激活巨大 Embedding table 中极少的一部分参数。既然只有少部分被访问,我们根本没有必要把整个模型全盘解压。只有对当前请求真正访问到的 Embedding,才在 request 时恢复成 FP32,再交给原来的 FP32 链路去算。
这样就能把存储格式和计算格式分开:存储时追求高密度,真正参与计算时,再按需转换成对计算友好的形式。
代价就是,每次请求的关键路径上多了一步解码(Decompression / Decode)。
我最开始用普通的 for-loop 写了一版转换代码,跑出来的线上请求真实耗时数据如下:
- 原始 FP32:
7778 us - Naive INT8:
10589 us(比 FP32 慢约 36.1%) - Naive FP16:
15341 us(比 FP32 慢约 97.2%)
注:这只代表当时那组特定 workload 的数字,不能作为 CPU FP16/INT8 的泛化性能结论。
节省的内存保住了,但按需解码带来的延迟,已经影响到了请求耗时。
接下来需要在保留内存收益的前提下,降低这部分开销。
用 SIMD 处理格式转换#
新增的开销集中在 FP16 / INT8 到 FP32 的逐元素转换上,我先从这段代码看起。
以前在 CV 场景用 Halide 做图像预处理优化时遇到过类似情况。这种 workload 的特点太鲜明了:元素之间基本独立,计算模式完全重复,内存数据连续,且每个元素都执行同一种解码操作。
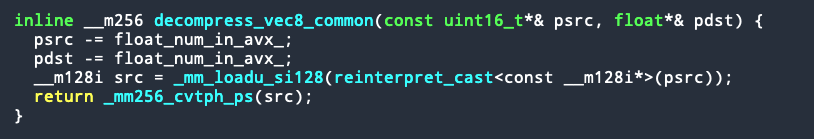
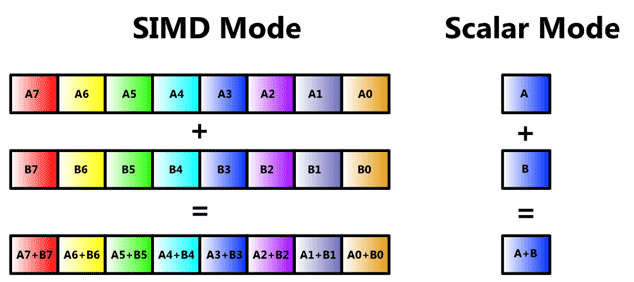
这种逐元素转换适合用 SIMD(Single Instruction, Multiple Data)处理。
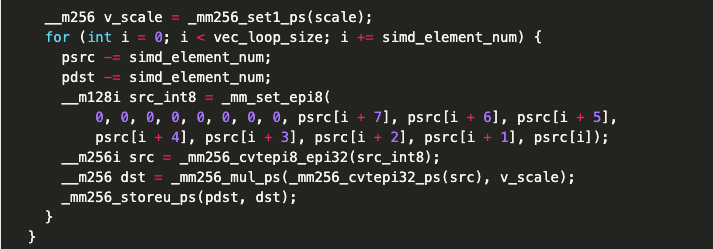
于是我直接上了 AVX2 指令集,每次把 8 个元素打包一起处理。
这一版的请求耗时:
- INT8:降到了
8091 us(对比 naive 版本降低约 23.6%) - FP16:降到了
13481 us(降低约 9.8%)
INT8 已经接近 FP32 baseline,但 FP16 仍然慢了很多。
剩下的 4 个元素去哪了?#
卡在这里的时候,我回头看了一眼这批推荐模型里的 Embedding size 分布。
我发现 size 并不是均匀随机的,模型里存在大量 size = 12 的 Embedding。
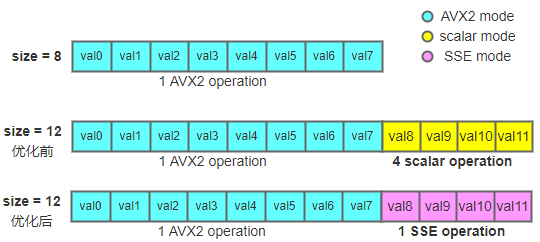
AVX2 一次处理 8 个元素。也就是说,12 个元素会被拆成:8 + 4。
如果前面 8 个跑了 AVX2,剩下 4 个却走回最慢的 scalar fallback 路径,那这就浪费了大量机会。通用代码当然要写得能处理任意 size 的 remainder,但真实模型通常只使用很少的一组 shape。
为了接住这 4 个元素,我把 SSE 也加了进来:
- 前 8 个元素用 AVX2
- 剩下 4 个用 SSE
- 最后的极少数余数再用 scalar
FP16 的请求耗时降了下来:
- AVX2 + SSE 联合后:
10416 us(对比 naive FP16 累计降低 32.1%)。
对这批大量使用 size 12 的模型,补上 4 个元素的向量路径比继续优化通用 remainder 更有用。
卡住我的一个反直觉结果#
加上 SSE 后,FP16 确实快了很多,但 INT8 的数据几乎没动:
- INT8 AVX2:
8091 us - INT8 AVX2 + SSE:
8090 us
几乎毫无变化。
原本以为,大量 size=12 的情况下,补上 4 个元素的 SSE 路径也会改善 INT8。这个结果说明,那部分 scalar 开销并没有主导 INT8 的耗时。
补齐向量路径没能改善 INT8,我需要重新定位耗时。
我把这段 热点路径 抽成了一个非常小的、剥离了框架逻辑的 microbenchmark,用 gperftools 挂上去看函数级的 profiling 耗时分布。
昂贵的不是计算,是数据搬运#
Profiling 的火焰图指向了一个极其具体的函数调用:INT8 SIMD 实现里的 _mm_set_epi8 消耗了大量时间。
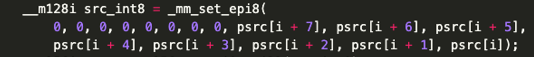
当时的写法大致是这样:把内存里原本就连续的 8 个 byte,一个一个读出来,塞进寄存器里。
1// 示意伪代码
2_mm_set_epi8(src[i+7], src[i+6], ..., src[i]);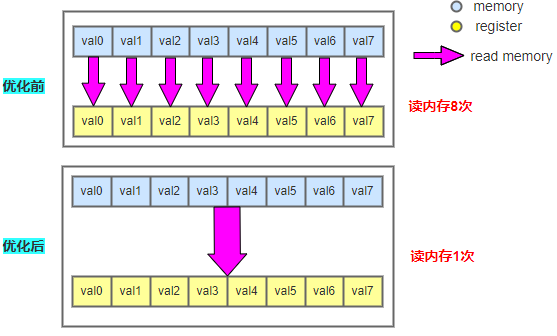
这段写法逐个构造寄存器元素,没有直接表达连续加载。
当我把这段代码换成一次连续的 load 操作 _mm_loadu_si128(...) 后,INT8 请求耗时降到了 7135 us(累计下降约 32.6%)。

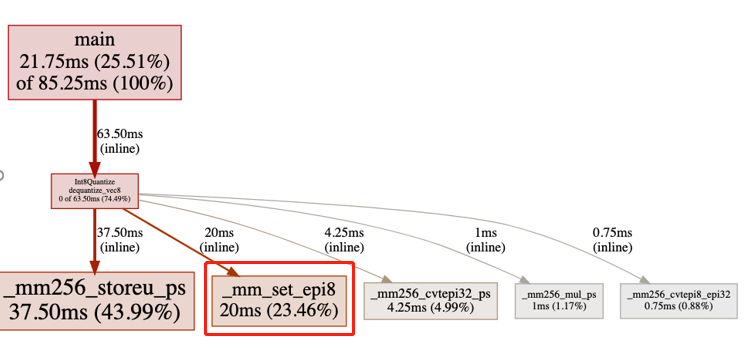
这次减少耗时的地方,是把连续数据放进寄存器的过程。只把后面的运算换成 SIMD,还不足以保证整段代码更快。
真的需要那个中间产物吗?#
INT8 终于降下去了,那 FP16 还能怎么榨?
我重新画了一下当时 FP16 的执行路径。它在逻辑上分成了两步:
Decode 之后,我们会生成一个 FP32 的 intermediate embedding。这个中间产物会被老老实实写回到内存里。紧接着下一阶段(比如 axpy)又会从内存把它读出来参与后续的计算。
这个写回内存的动作,真的有必要吗?
去掉了中间结果回写后,顺着「减少数据搬运」的思路,我把 FP16 decode 和后续的 multiply/add 合并在一起,并用上了 FMA (Fused Multiply-Add) 这样的指令。
新的路径变成了这样:
中间那个庞大的 FP32 embedding 不再需要 materialize 到 memory 里。数据流变成了纯粹的:load → register → compute → store。
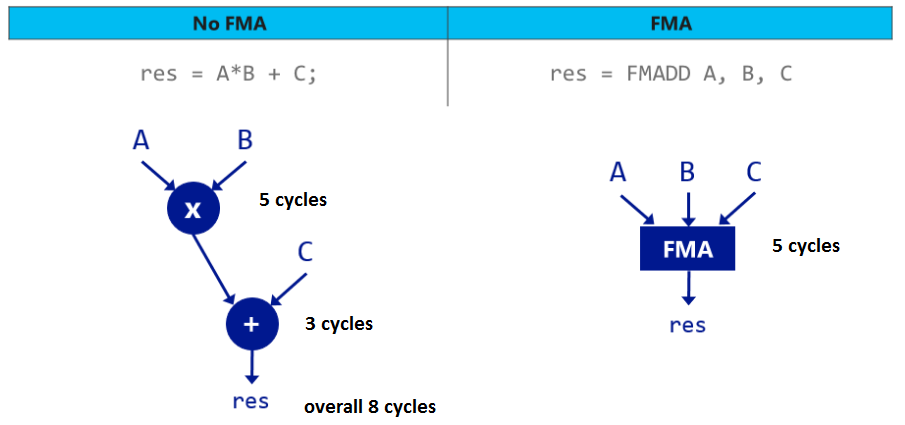
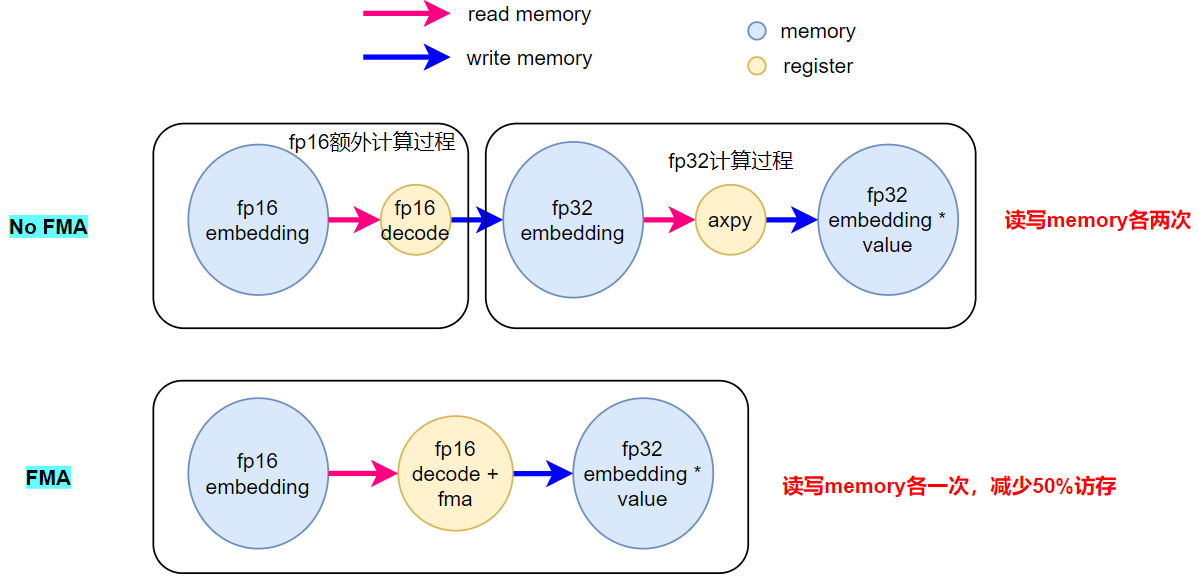
去掉这次中间结果回写后,FP16 请求耗时降到 7022 us(相比 naive FP16 降低约 54.2%)。
这次修改同时涉及 fusion 和 FMA,不能把全部收益归到某条指令上。执行路径上的变化是:decode 和后续计算共用寄存器里的数据,省掉了中间结果的写回与读取。
把运行时的判断挪到编译期#
做到这里,耗时其实已经降下来不少了,但代码里还有个瑕疵。
前面为了处理各种边界,我们写了类似 size >= 8、remaining >= 4 的动态分支判断。推荐模型一次请求要查成百上千个 embedding,这些分支判断就在 热点路径 上被疯狂重复执行。
既然对于一个固定的模型,embedding size 的取值就那么几个,那为什么要把所有的判断都留到 runtime 去算?
于是我针对一些常见 shape 做了 Template Specialization:
- 针对
size是 8 的倍数的特化; - 针对
size是 4 的倍数的特化; - 最后留一个 generic fallback 兜底。
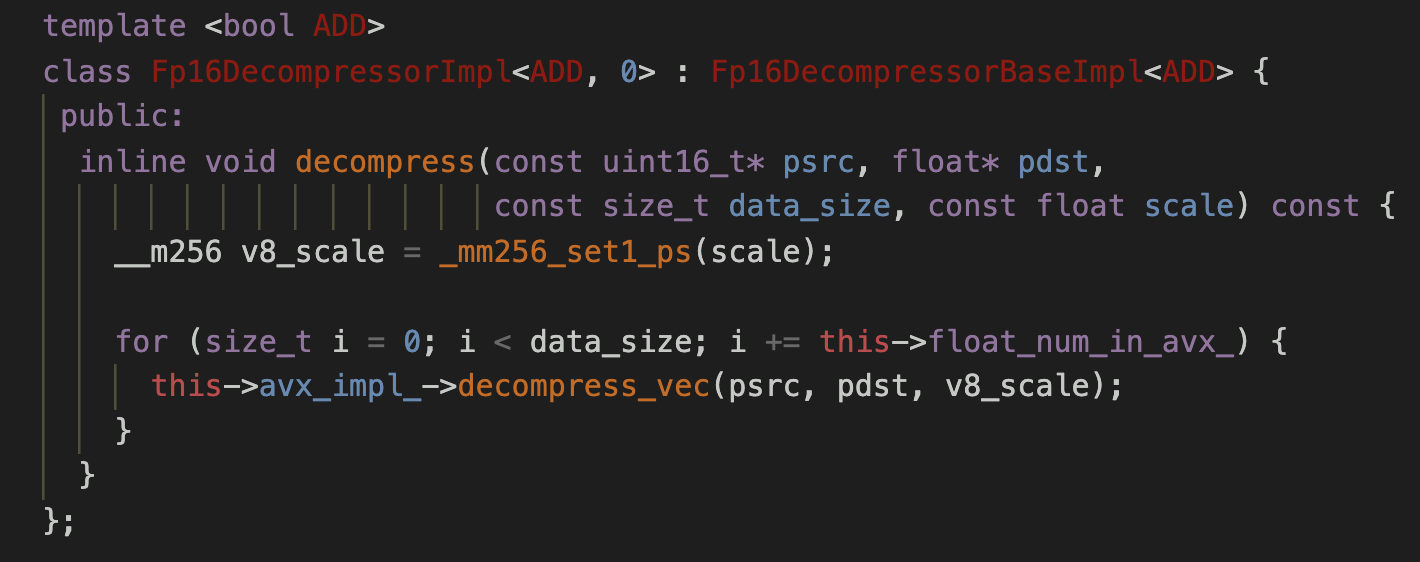
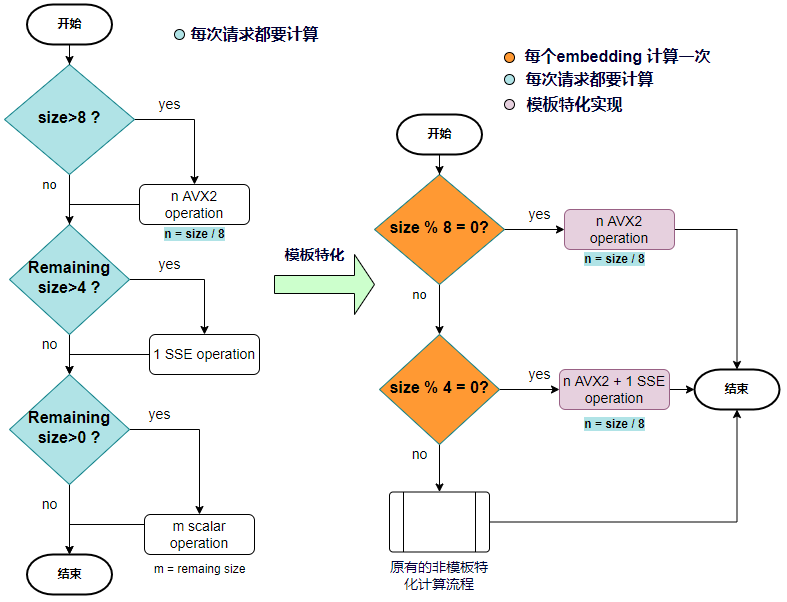
把部分判断提前到 compile time 后:
- INT8 降至
6659 us - FP16 降至
6875 us
常见 shape 走特化路径,其他 size 仍由 generic fallback 处理。
最终结果#
后面还通过 loop unrolling 减少分支开销增加指令级并行,以及处理 AVX 和 SSE 混用时的 upper state transition penalty(避免切换带来的额外延迟),我又扣下了一点时间。
最终的结果定格在:
- INT8:
10589 us→6528 us(相比初始压缩方案降低 38.3%) - FP16:
15341 us→6733 us(降低 56.1%)
如果拿这个数字和一开始没有压缩的 FP32 baseline(7778 us)相比,最终优化后的压缩路径,甚至跑得比原本的 FP32 路径还要快。
这里的压缩路径仍然恢复成 FP32 后计算,数字不能说明 CPU 上低精度计算天然更快。这轮优化也改进了「创建计算图输入」的过程,减少了原有的循环、分支和中间数据读写。
现在回看这段经历,所有有效的优化线索全都是顺着具体的 workload 扒出来的:大量 size=12 的分布决定了要加 SSE 兜底;INT8 对 SSE 没反应,逼着我们用 profiling 定位到了访存瓶颈;而 FP32 中间产物的读写冗余,又自然导向了 FMA 融合。
这些收益对应的是当时那组模型和 shape。换一组模型,需要重新检查耗时分布。