上一篇结尾我写:Multi-Head Attention 仍然只是一个 information routing / read mechanism,一个完整的 Transformer layer 还包含 FFN、residual connection、layer normalization 等组件。
写完那句之后我就去看完整的 Transformer architecture 了。然后立刻撞上一个新的困惑——不是某个组件看不懂,而是名词突然变得很多:attention layer、attention block、attention sublayer、Transformer block、Transformer layer、Transformer stack。这些东西到底是什么层级关系?有些资料把 Transformer block 和 Transformer layer 混着用,有些资料把 attention block 当成 Transformer block 的同义词。
我当时的状态是:Multi-Head Attention 的内部细节已经拆清楚了,但一到"把它放进完整 Transformer"这一步,反而不确定自己在看的是哪一层抽象。
这篇想把这件事理清楚。从命名混乱开始,一步步走到最后的完整结构。
先把名词理清#
我在不同资料里遇到的术语大概有这几种,按粒度从小到大排。
Attention module#
狭义的 Multi-Head Attention 本身。就是上一篇拆过的那个东西:
1QKV projection → multiple heads → concat → W_O输入 [B, T, d_model],输出 [B, T, d_model]。它是一个 computation module——负责从 sequence 中做 dynamic read,产生 read result。
这个 module 本身不包含 residual connection,不包含 normalization,不包含 dropout。它就是那个 routing + read 的计算单元。
Attention sublayer#
在 Transformer block 的语境中,Attention 通常作为一个 sublayer(子层)出现。sublayer 指的不只是 Attention module 本身,还包括围绕它的 residual connection、normalization,以及可能的 dropout。
也就是说:
1Attention module ≠ Attention sublayer前者是纯粹的计算模块,后者是它在 Transformer block 内的完整包装。具体 normalization 放在哪里(sublayer 前还是后),后面会展开。
需要说明的是,sublayer 这个词更多是 Transformer architecture 文献中对 block 内部主要计算单元的称呼,而不是某个严格的 PyTorch class 定义。不同 codebase 里的命名可能完全不一样。
Transformer block / Transformer layer#
一个典型的 Transformer block 主要包含两类 sublayer:
1Attention sublayer
2FFN sublayer
以及围绕它们的 residual connection 和 normalization。
我一开始把 Transformer block 和 Attention block 当成了同一个东西。后来发现这是不对的——Attention 只是 Transformer block 内的一类主要 sublayer,不是 block 的全部。 一个完整的 block 至少还有 FFN sublayer,以及各自配套的 residual 和 normalization。
至于 Transformer block 和 Transformer layer 的关系:在很多资料里这两个词互换使用,指的是同一个东西。术语并不完全统一,这是事实。
Transformer stack#
多个结构相同、参数不同的 Transformer block 叠起来,就是 Transformer stack。原始 Transformer 的 encoder 和 decoder 分别有 6 个 block。
这里有一个容易滑过去的点:每个 block 有自己独立的参数。 RNN 中同一个 transition function 的参数跨 timestep 重复使用,但 Transformer stack 里不同 block 的 Attention 和 FFN 各自拥有独立的权重。Block 1 的 \(W_Q, W_K, W_V\) 和 Block 2 的 \(W_Q, W_K, W_V\) 不是同一套。
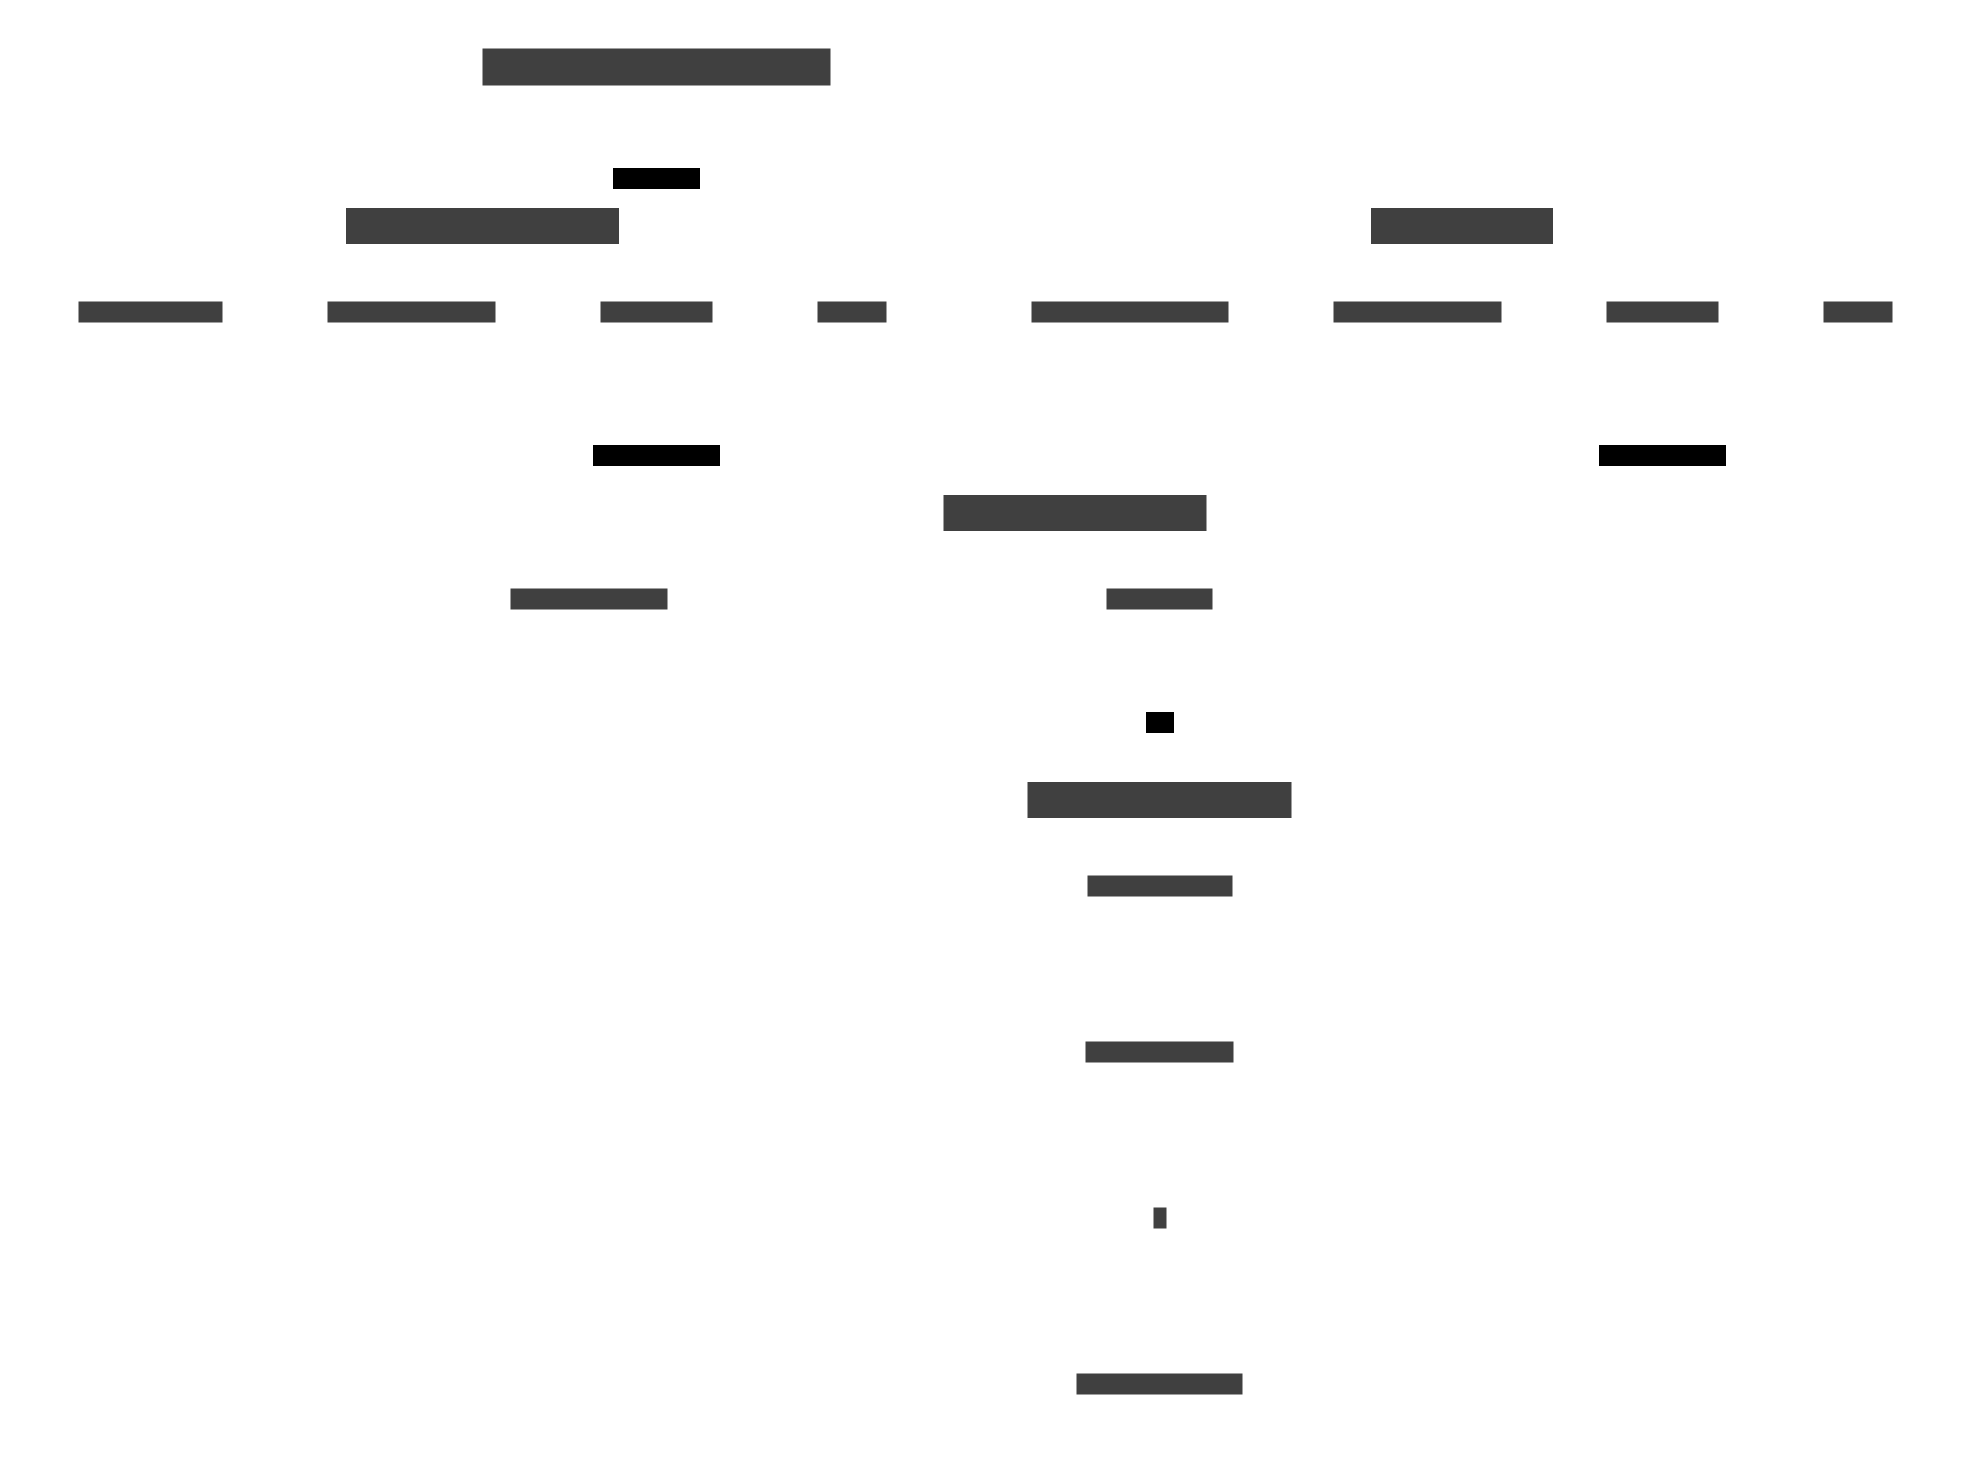
走到这里,我给自己的结论是:与其死记每个名字对应什么,不如看清楚结构层级。不同论文、不同 codebase 的命名不一致是常态,但层级关系是稳定的:module → sublayer → block → stack。
为什么 Attention 和 FFN 不能只写成串联#
理清名词之后,下一个问题自然就是:这些组件怎么连起来?
最直觉的做法是:
1x → Attention → FFN → output每一层把输入彻底变换成下一层的 representation,前一层的输出就是后一层的输入。
这种纯串联结构能工作,但有两个问题让我觉得不太对。
第一个是 information path。如果每一个 block 都直接把输入彻底变换成新的 representation,那么深层网络中,最早的信息想到达最后一层,必须经过中间每一层的完整非线性变换。原始 information 没有任何直通的路径——它全部依赖每一层变换的"准确传递"。gradient path 也一样:反向传播时梯度必须经过每一层变换的 Jacobian,深层时梯度很难稳定。
第二个是语义上的。上一篇建立过一个理解:Attention 的输出是当前 token 根据自己的 query,从整个 sequence 中动态读回来的 contextual information——一个 read result。这个 read result 更像是"新获取的信息",而不是"完全替代原有 representation 的新 hidden state"。
如果把 Attention output 理解为一种 update,那纯串联结构就有点奇怪——你把旧 representation 直接扔掉了,只留下了 update 本身。
这两个问题指向同一个东西:Residual Connection。
Residual Connection#
最普通的形式:
$$ y = x + F(x) $$其核心拓扑结构由一条直通的 Identity 旁路与一条残差计算分支构成:
一条 identity path 直接把 \(x\) 送到加法处,另一条路经过 \(F\)(Attention 或 FFN)计算出一个结果,两者相加。
这个想法和 ResNet 同源。ResNet 的核心 insight 是:与其让网络学习一个完整的目标映射 \(H(x)\),不如让网络学习一个相对于 identity 的残差 \(F(x) = H(x) - x\)。identity path 始终保留,网络只需要学习 update。
对于 Transformer 来说,这意味着:Attention 或 FFN 不需要输出一个完整的新 representation,只需要输出一个 update;原有的 representation 通过 identity path 保留,update 加上去就是新的 representation。
我在这里纠正过自己的一个误解。我以前以为 residual connection 是发生在 Transformer block 与 block 之间的——Block 1 的输出加上 Block 2 的输出。但实际上更准确的说法是:residual 通常包围 block 内部的每一个主要 sublayer。每个 Attention sublayer 有自己的 residual,每个 FFN sublayer 也有自己的 residual。一个 block 内部就有两次 residual add。
Residual 为什么和 Attention 的 read-result 语义特别契合#
这是我梳理过程中觉得最有意思的一个点。
前面几篇一直在建立一个理解:Attention 的输出是当前 token 根据自己的 query,从整个 sequence 中动态读取回来的 contextual information。不是凭空生成的,是 read result。
现在加上 residual connection:
$$ x' = x + \Delta_{\text{attention}} $$这里 \(\Delta_{\text{attention}}\) 就是 Attention module 的输出。

把这个公式用语义翻译一遍:
1当前 token 已有的 representation
2+
3它刚从 context 中读回来的新信息
4=
5更新后的 representation
这在直觉上非常自然。token 不是"被替换成了一个新东西",而是"在已有信息的基础上,补充了从上下文读到的内容"。
我想强调的是:这不是说 Attention output 在数学上被定义为"增量"。从 linear algebra 的角度,\(x + F(x)\) 和 \(G(x)\) 只是两种不同的 function form,前者未必比后者更对。但 residual architecture 让我们可以非常自然地把 Attention 理解成一个 update producer——它读取 context,产生一个 contextual update,然后写回到当前 representation 上。 这个心智模型在后面理解整个 Transformer stack 时会反复用到。
FFN 放入同一个框架#
FFN(Feed-Forward Network,position-wise MLP)做的事和 Attention 不同:
- Attention:从 sequence 的其他位置读取信息 → contextual update
- FFN:对当前 token 的 representation 做非线性 feature transformation → feature update
但从 residual 的角度看,它们的角色可以统一:
Attention 和 FFN 是两种不同来源的 update producer。 前者的 update 来自 inter-token interaction(从别的 token 那里读信息),后者的 update 来自 intra-token transformation(对当前 token 自己的 representation 做变换)。两者都通过 residual connection 把 update 写回同一条 stream。
为什么还需要 LayerNorm#
到这里结构已经有了:Attention 和 FFN 各自计算 update,通过 residual 加回去。但如果真的就这样一路叠下去:
1x ← x + attention_update
2x ← x + ffn_update
3x ← x + attention_update
4x ← x + ffn_update
5...
一个实际问题会浮出来:residual stream 的数值尺度和统计分布,随着网络深度持续变化。每一层的 Attention 和 FFN 面对的输入,其 mean 和 variance 都在漂移。这会增加优化难度——sublayer 需要不断适应变化的输入 scale。
于是引入 normalization。Transformer 使用的是 LayerNorm(Layer Normalization)。
对于 shape 为 [B, T, d_model] 的 tensor,LayerNorm 的做法是:每个 token 单独在自己的 \(d_{\text{model}}\) 个 feature dimension 上计算 mean 和 variance。
1token 1: [768 dims] → 计算 mean/var → normalize
2token 2: [768 dims] → 计算 mean/var → normalize
3token 3: [768 dims] → 计算 mean/var → normalize
不同 token 之间互不干扰,不同 batch sample 之间也互不干扰。
公式:
$$ \hat{x} = \frac{x - \mu}{\sqrt{\sigma^2 + \epsilon}} $$其中 \(\mu\) 和 \(\sigma^2\) 是当前这一个 token 的 \(d_{\text{model}}\) 个 feature 上的均值和方差。\(\epsilon\) 是一个很小的常数,防止除零。
normalize 之后再做一步 affine transform:
$$ y = \gamma \odot \hat{x} + \beta $$\(\gamma\) 和 \(\beta\) 是 learnable parameters,维度和 \(d_{\text{model}}\) 一样。\(\gamma\) 是 learned scale,\(\beta\) 是 learned shift。它们允许网络在 normalization 之后重新调整每一维 feature 的尺度和偏移——如果某一维需要更大的 variance,\(\gamma\) 可以学着放大它。
和 BatchNorm 做一个简短对比。两者的核心差异在于统计切片的维度不同:
BatchNorm 依赖 batch statistics,在 batch size 变化、inference 时行为不一致等问题上需要额外处理。LayerNorm 对每个 sample 独立计算,不依赖 batch,天然适合 sequence model 和 inference 场景。不展开了。
Post-LN 和 Pre-LN#
知道了 residual connection 和 LayerNorm 各自的作用之后,下一个问题是:LayerNorm 放在哪?
这个问题我一开始没当回事,以为只是一个 engineering detail。后来发现它对 residual stream 的结构性质有明显影响。
Post-LN:原始 Transformer 的做法#
原始论文(Vaswani et al. 2017)使用的结构,现在通常叫 Post-LN:
对于 Attention sublayer:
$$ x' = \text{LN}(x + \text{Attention}(x)) $$对于 FFN sublayer:
$$ x'' = \text{LN}(x' + \text{FFN}(x')) $$顺序是:先做 sublayer 计算,再加 residual,最后对相加结果做 LayerNorm。名字的由来:LayerNorm 在 sublayer 和 residual add 之后(Post)执行,所以叫 Post-LN。
Pre-LN:后来更常见的做法#
另一种放置方式,通常叫 Pre-LN:
$$ x' = x + \text{Attention}(\text{LN}(x)) $$$$ x'' = x' + \text{FFN}(\text{LN}(x')) $$顺序变了:先做 LayerNorm,再做 sublayer 计算,最后加 residual。写成代码更直观:
1normalized = norm(x)
2update = attention(normalized)
3x = x + update
两者的拓扑差异非常鲜明:
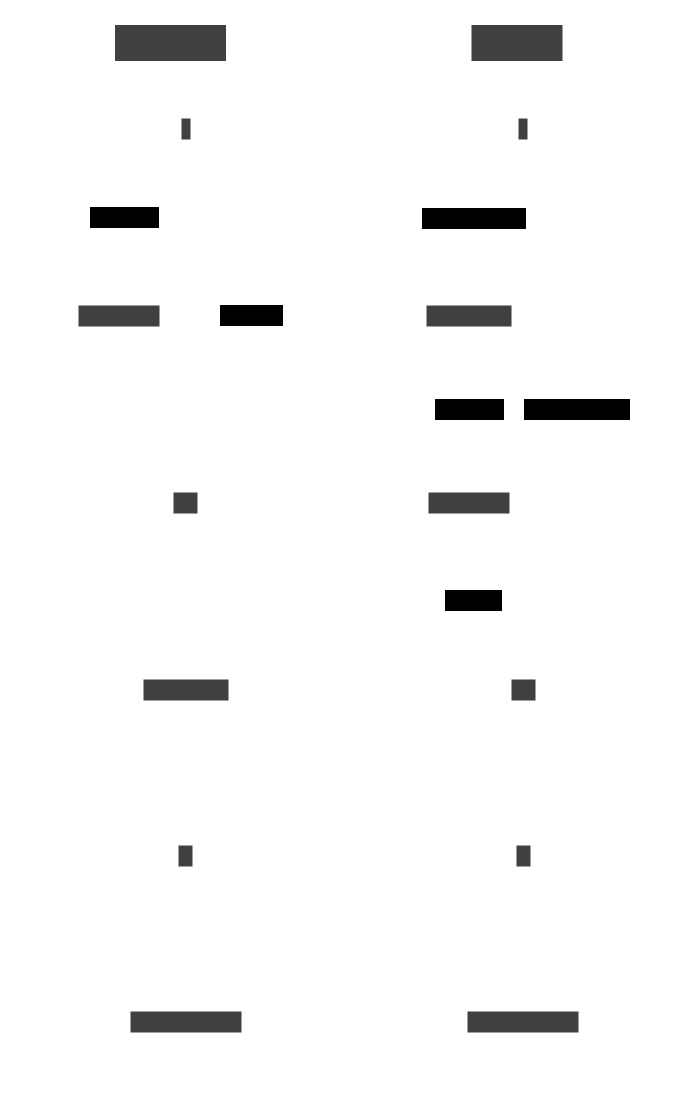
为什么位置不同,结构性质就不同#
我以前觉得"把 LN 往前挪一下"只是一个 trick。后来认真看了一下 residual stream 里发生的事,才发现这个变化的意义比想象中大。
Pre-LN 中,residual branch 是什么样的?
1x ──────── identity path ──────── (+) ──→ x'
2                                   ↑
3              LN → Attention → update
从 \(x\) 到 \(x'\),存在一条纯粹的 identity path。\(x\) 原封不动地到达加法处,不经过任何变换。LayerNorm 只作用在送入 sublayer 的那条分支上——它是 sublayer 在读取 residual stream 之前,对输入做的 conditioning。
Post-LN 中呢?
1x ──────────────── (+) ──→ LN ──→ x'
2                    ↑
3              Attention → update
residual add 之后,整个结果(包括 identity 分支)还要经过一次 LayerNorm。也就是说,identity path 也被 LayerNorm 改写了。从 \(x\) 到 \(x'\),不存在一条完全干净的 identity path。
Pre-LN 和 residual stream 的展开#
Pre-LN 的结构可以写成:
$$ x_{l+1} = x_l + F(\text{LN}(x_l)) $$每一步都是"当前 stream + update"。把多步展开:
$$ x_1 = x_0 + \Delta_0 $$$$ x_2 = x_1 + \Delta_1 = x_0 + \Delta_0 + \Delta_1 $$继续下去:
$$ x_L = x_0 + \sum_{l=0}^{L-1} \Delta_l $$其中 \(\Delta_l = F(\text{LN}(x_l))\) 是第 \(l\) 个 sublayer 的 update。
这个展开式的直觉是:Transformer stack 中存在一条持续贯穿网络的 representation 主干。各个 sublayer 读取当前 stream,计算一个 update,再写回。 最终的 representation 是初始 embedding 加上所有 sublayer updates 的累加。
这就是 residual stream 这个概念的由来。
梯度也更干净#
这段稍微数学化一点,因为和前面 RNN 的 Jacobian 连乘那篇有直接联系。
对于 Pre-LN:
$$ x_{l+1} = x_l + F(\text{LN}(x_l)) $$对 \(x_l\) 求 Jacobian:
$$ \frac{\partial x_{l+1}}{\partial x_l} = I + J_F $$其中 \(J_F\) 是 \(F(\text{LN}(\cdot))\) 的 Jacobian。关键是那个 \(I\)——identity matrix 的贡献始终存在。梯度在回传时,即使 \(J_F\) 很小或者数值不理想,identity path 也提供了一条直通的梯度通路。
对于 Post-LN:
$$ x_{l+1} = \text{LN}(x_l + F(x_l)) $$Jacobian 变成:
$$ \frac{\partial x_{l+1}}{\partial x_l} = J_{\text{LN}}(I + J_F) $$identity 分支也必须经过 \(J_{\text{LN}}\)。LayerNorm 的 Jacobian 不是 identity——它依赖当前输入的 statistics,会对梯度做额外变换。深层网络中这个额外的 Jacobian 累积起来,可能让训练不稳定。
Jacobian 连乘那篇写过,RNN 的 BPTT 面临的核心问题就是一串 Jacobian 的连乘导致梯度难以稳定。Pre-LN 在每一步都保留了 \(I\) 的 identity contribution,让这个问题缓和了很多。
所以 Pre-LN 更容易训练很深的 Transformer。这不是 Pre-LN 在所有场景下都优于 Post-LN 的意思——原始 Transformer 使用 Post-LN 也能训练,只是深层时 Pre-LN 更稳定。后来的深层 Transformer 大量采用 Pre-Norm 结构。现代模型还常把 LayerNorm 换成 RMSNorm(去掉 mean centering,只保留 variance normalization)等变体,但 normalization placement 的核心考量是一样的。
把完整 Transformer Block 拼起来#
现在所有组件都到齐了。以 Pre-Norm 结构为例,一个完整的 Transformer block 由两个标准的残差子层(Attention 子层与 FFN 子层)串联装配而成:
一个 block 不是:
1Attention而是:
1Attention update + FFN update + Residual + Normalization共同形成。每个 block 经历两次"读取 stream → 计算 update → 写回 stream"的过程,一次由 Attention 执行,一次由 FFN 执行。
从 Block 到 Stack,再到 Residual Stream#
多个 Transformer block 叠起来构成了 Transformer Stack:

但这种经典堆叠画法容易让人觉得每一层都在"彻底覆盖与替换"上一层的输出。如果换一种视角会更有意思。
前面已经展开过:
$$ x_L = x_0 + \sum_{l=0}^{L-1} \Delta_l $$这意味着整个 Transformer stack 可以看成:一条 residual stream 从头到尾贯穿,每个 sublayer(Attention 或 FFN)都是这条 stream 上的一个分支——读取当前 stream 的内容,计算一个 update,再写回去。

这个 mental model 把 Transformer stack 从"N 层依次处理"变成了"一条持续流动的 representation,不断被 Attention 和 FFN 补充新信息"。
对于典型的 Pre-Norm 结构,整个过程可以用一个公式高度概括:
$$ x_{l+1} = x_l + F(\text{Norm}(x_l)) $$其中:
- \(x_l\):当前 residual stream 的状态
- Norm:为 sublayer 提供数值条件更稳定的输入
- \(F\):Attention 或 FFN
- \(F(\cdots)\):当前 sublayer 产生的 update
- \(+\):把 update 写回 residual stream
写在最后#
回到最初的困惑。一开始看完整 Transformer 时,面前摆着的是一堆看似独立的组件:Attention、FFN、Residual、LayerNorm、Block、Stack。我不确定它们之间的层级关系,也不确定为什么要用这种方式组合。
现在可以把它们统一到一个 picture 里。
Transformer block 不是 Attention 外面随意包了几个工程组件。Attention 和 FFN 负责计算新的 update——前者从 sequence context 中读取信息,后者对当前 token 的 representation 做 feature transformation。Residual connection 保留并更新贯穿整个网络的 representation。Normalization 让每次计算面对更合适的输入尺度。多个 block 叠起来以后,看到的不再只是一堆层,而是一条贯穿整个 Transformer stack 的 residual stream——各个 sublayer 不断读取它、计算 update、再写回。
参考资料#
- Vaswani et al., Attention Is All You Need, 2017 — https://arxiv.org/abs/1706.03762
- He et al., Deep Residual Learning for Image Recognition, 2015 — https://arxiv.org/abs/1512.03385
- Ba et al., Layer Normalization, 2016 — https://arxiv.org/abs/1607.06450
- Xiong et al., On Layer Normalization in the Transformer Architecture, 2020 — https://arxiv.org/abs/2002.04745
- MIT 6.S191, Introduction to Deep Learning — https://introtodeeplearning.com/
- 一组 QKV 就够了吗:Multi-Head Attention 到底在拆什么
- 从动态读取到 QKV:Self-Attention 的公式是怎么长出来的
- 从局部线性化到 RNN:理解 Jacobian 连乘