起因#
上一篇文章理清了 latent variable 和 latent space 的概念,最后停在一个地方:
不要直接在复杂的数据空间中生成数据。先在简单的 latent space 中采样一个 \(z\),再通过学到的映射把 \(z\) 变成 \(x\)。
这个思路很漂亮,但当时只讲了"这个方向可以做",没有讲具体怎么做。
接着看 6.S191 的内容,第一个出场的具体模型就是 VAE(Variational Autoencoder,变分自编码器)。我最初以为 VAE 就是"一个 Autoencoder 加上一些概率约束",看下去才发现它做了一个非常关键的改变——这个改变本身就能回答"为什么 Autoencoder 不能直接拿来生成"。
这篇就围绕这一个改变展开。
从 Autoencoder 开始#
VAE 名字里有 Autoencoder,所以先回顾一下普通的 Autoencoder(自编码器)。
结构非常直接:
$$ x \xrightarrow{\text{Encoder}} z \xrightarrow{\text{Decoder}} x' $$Encoder 把输入 \(x\) 压缩成一个 latent representation \(z\),Decoder 再把 \(z\) 展开成重建结果 \(x'\)。训练目标是让 \(x'\) 尽量接近原始的 \(x\)。
这里有一个对后面讨论很重要的性质:普通 Autoencoder 里,\(z\) 是一个确定性的映射结果。
$$ z = f_\phi(x) $$同一个 \(x\) 送进 Encoder,永远得到同一个 \(z\)。这和查表一样——输入确定,输出就确定。
拿 Autoencoder 做生成,卡在哪里#
Autoencoder 本来就不是为生成设计的。它的训练目标是 reconstruction——给一张图,压缩再重建,尽量不丢信息。
但既然我们已经有了 Decoder,一个自然的想法是:
如果我随便在 latent space 里选一个 \(z\),丢给 Decoder,能不能生成一个合理的新样本?
这个想法听起来很自然,但做起来会碰壁。
原因是:普通 Autoencoder 的训练目标并没有对 latent space 的全局结构做任何要求。Encoder 只关心一件事——怎么编码才能让 Decoder 重建得更好。它没有义务把 latent space 整理成一个"到处都能生成合理输出"的空间。
具体来说:
- 训练数据经过 Encoder 后,只会在 latent space 中落到某些特定区域。
- 这些区域的分布可能非常不规则——某些地方密集,某些地方空旷,相邻区域之间不一定平滑过渡。
- 随便选一个 \(z\),很可能落在 Decoder 训练时几乎没有见过的区域。
这里要注意措辞:我不是说"Autoencoder 的 latent space 一定不连续"。而是说,它的训练目标并没有明确要求 latent space 满足某个方便采样的全局概率结构,因此没有理由保证从某个简单分布随机采样出的 \(z\) 会落到 Decoder 熟悉的区域。
于是问题变成:怎么让 latent space 变成一个"我们知道该怎么采样"的空间?
VAE 做了什么改变#
VAE 的核心改变可以用一句话概括:
把 Encoder 的输出从"一个确定的点"变成了"一个概率分布"。
普通 Autoencoder:
$$ x \to z $$VAE:
$$ x \to q(z|x) $$对于一个输入 \(x\),Encoder 不再简单地回答"它对应 latent space 中的 \(z = 1.37\)"。它回答的是:“对于这个 \(x\),我认为 \(z\) 大概分布在这个范围里。”
更具体地说,经典 VAE 中这个分布被定义为一个高斯分布:
$$ q_\phi(z|x) = \mathcal{N}(\mu(x),\, \operatorname{diag}(\sigma^2(x))) $$Encoder 实际输出的是两组参数:均值 \(\mu(x)\) 和方差 \(\sigma^2(x)\),它们共同描述一个高斯分布。
我后来觉得有一个视觉上很好用的理解方式:
- 普通 Autoencoder:每个输入对应 latent space 中的一个点。
- VAE:每个输入对应一团概率云。
这个从"点"到"云"的变化,就是理解 VAE 最重要的一步。后面所有的设计——prior、KL divergence、采样——都是围绕这个变化展开的。
高斯分布速查#
在继续之前,先做一个最小的概率复习。后面会反复出现高斯分布,如果这部分已经熟悉可以跳过。
\(X \sim \mathcal{N}(\mu, \sigma^2)\) 表示随机变量 \(X\) 服从高斯分布(Gaussian distribution,也叫正态分布)。
其中:
- \(\mu\)(mu)是 mean(均值),决定分布的中心位置——钟形曲线的峰在哪里。
- \(\sigma\)(sigma)是 standard deviation(标准差),控制分布有多宽——\(\sigma\) 越大,曲线越矮胖。
- \(\sigma^2\) 是 variance(方差)。
一个容易混淆的地方:\(\mathcal{N}(\mu, \sigma^2)\) 的第二个参数写的是方差,不是标准差。比如 \(\mathcal{N}(0, 4)\) 意味着 \(\sigma^2 = 4\),因此 \(\sigma = 2\)。
高斯曲线表示的是概率密度(probability density),不是某个单点的概率——之前写过一篇专门讨论这件事。这里只需要知道:曲线越高的位置,从附近采样到的可能性越大。
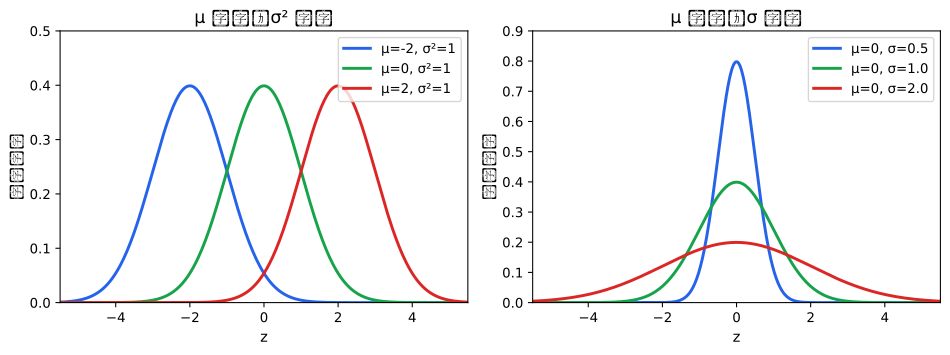
左图:三条曲线均值不同(\(\mu = -2, 0, 2\)),方差相同——\(\mu\) 控制"分布在哪里"。
右图:三条曲线均值相同,标准差不同(\(\sigma = 0.5, 1, 2\))——\(\sigma\) 控制"分布有多宽"。
Encoder 为什么输出"恰好"是高斯#
这是我看 VAE 时产生的第一个真实困惑。
看到"Encoder 输出一个高斯分布"这个说法,我的第一反应是:
训练居然能让 Encoder 的输出恰好是高斯分布?模型怎么控制输出一定是高斯?
后来发现这个理解的方向完全反了。
不是 Encoder 自己训练着训练着发现了一个高斯分布。而是模型设计者事先决定:\(q(z|x)\) 使用高斯这个分布族。
Encoder 真正输出的不是一个分布,而是分布的参数。具体来说,Encoder 网络的最后一层会输出两组向量:
- \(\mu(x)\):均值向量
- \(\log \sigma^2(x)\):对数方差向量(实际实现中用 log variance 而不是直接输出 \(\sigma\),因为 log 可以取任意实数值,数值上更稳定)
然后我们人为定义:
$$ q_\phi(z|x) = \mathcal{N}(\mu(x),\, \operatorname{diag}(\sigma^2(x))) $$所以逻辑是这样的:
- 高斯这个分布族(distribution family)——是设计者选择的。
- \(\mu(x)\) 和 \(\sigma(x)\) 的具体数值——是训练学出来的。
分布族是选择的,分布参数才是学习的。
用分类模型做个类比#
这个逻辑其实和其他神经网络设计完全一样。
比如一个 1000 类的图像分类模型,最后一层输出 1000 个 logit:
$$ \text{hidden state} \to \text{Linear}(d, 1000) \to \text{1000 logits} $$它为什么"恰好"输出 1000 个数?不是训练过程中"发现世界上有 1000 类"。而是模型结构在一开始就硬写了 output_dim = 1000。训练负责的是:这 1000 个 logit 应该各自取什么值。
VAE 的 Encoder 一样。网络结构规定了输出层有 \(2d\) 个神经元(\(d\) 个给 \(\mu\),\(d\) 个给 \(\log \sigma^2\)),然后由设计者定义"这些输出参数化一个对角高斯"。训练负责学习这些参数应该是什么。
为什么偏偏选 Gaussian#
既然分布族是人选的,为什么选高斯而不是别的?
我本来以为答案是"因为自然界很多东西服从正态分布"。但这不是 VAE 这里最核心的原因。后来回头看,发现这个问题要分两层回答:第一层是我们到底想让 latent space 具有什么性质;第二层才是为什么标准高斯是一个特别方便的具体选择。
生成需要什么样的 latent space#
如果 latent space 只用来压缩和重建,对它的结构没什么额外要求。但 VAE 的目标是生成——训练完成后要从 latent space 中采样,然后靠 Decoder 产出有意义的内容。
这就对 latent space 提出了两个隐含的期望:
连续性(continuity)。 Latent space 中彼此接近的两个点 \(z_1 \approx z_2\),经过 Decoder 后,希望倾向于得到语义上相近的结果。如果 \(z\) 稍微挪动一点,生成结果就跳变到完全不相关的东西,这个 latent space 对生成来说就不太好用。
完整性(completeness)。 从 latent prior 的高概率区域中采一个 \(z\),希望 Decoder 大概率能生成有意义的内容,而不是经常采到训练过程中 Decoder 从未见过的"洞"。
这两个性质不是严格的数学保证,更像是对 latent space 的设计期望——一个同时具备这两个性质的 latent space,才适合拿来做生成。
只把 x 编码成 distribution 还不够#
我一开始以为,VAE 把 \(x \to z\) 改成 \(x \to q(z|x)\) 这一步本身就解决了问题。后来发现并不是。
即使每个 \(q(z|x)\) 是一个概率分布,如果没有额外约束,完全可能出现:
- 每个 \(q(z|x)\) 的方差非常小,几乎退化成一个点;
- 不同样本的均值彼此距离非常远;
- 每个 posterior 都是一小团孤立的概率云;
- 云团之间存在大片 Decoder 从未训练过的区域。
“从确定的点变成概率分布"本身不能保证 continuity,也不能保证 completeness。 没有额外约束的话,这些概率云可以各自为政,和普通 Autoencoder 中散落的离散点本质上没有太大区别。
MIT 6.S191 的 slide 里也明确说过这一点:encoding as a distribution does not guarantee these properties。
想通这一步之后,KL regularization 为什么要存在就变得自然了。
Prior 的真正作用#
经典 VAE 规定一个 prior \(p(z) = \mathcal{N}(0, I)\),然后在 loss 中加入 KL 项 \(D_{\text{KL}}(q(z|x) \| p(z))\),要求每个样本的 posterior 不要离这个共同的 prior 太远。
几何上效果是这样的:原本每个 \(q(z|x)\) 可能是一个孤岛,散落在 latent space 各处。加入 KL 约束后,所有 posterior 都被要求留在 prior 的主要概率区域附近。因此:
- 不同样本的 posterior 之间更容易重叠;
- Decoder 在更连续的一片 latent region 上接受训练;
- latent interpolation 更容易得到平滑变化;
- 从 prior 采样时,更容易落在 Decoder 熟悉的地方。
不是高斯分布本身保证了 continuity 和 completeness,而是用一个连续、连通、密度平滑的先验去 regularize latent space,强烈鼓励了这两个性质的形成。
高斯本身并不神奇#
这里值得多说一句,防止产生误解。真正起作用的不只是"Gaussian"这个名字,而是 prior 的整体几何结构。
举一个反例。假设 prior 是一个双峰的 Gaussian mixture:
$$ p(z) = 0.5 \cdot \mathcal{N}(-100, 1) + 0.5 \cdot \mathcal{N}(100, 1) $$里面仍然用了高斯,但这个 prior 天然有两个相距极远的 mode。KL regularization 会把 posterior 推向这两个 mode 之一,两个 mode 之间仍然存在大片概率密度为零的区域。
所以不能说"只要用了 Gaussian 就天然获得一个连续的 latent semantic space”。经典 VAE 选的是 \(\mathcal{N}(0, I)\)——单峰、对称、连通——这些几何性质和"Gaussian"这个分布族名字同样重要。
为什么最终通常选 N(0, I)#
理解了建模动机之后,再看具体选择就清楚了。\(\mathcal{N}(0, I)\) 之所以成为默认 prior,同时满足了几何需求和工程便利:
几何上,它是单峰、连续、连通、对称的——各方向没有人为偏好,密度从中心向外平滑衰减。
工程和数学上:
参数简单。 \(d\) 维的对角高斯只需要 \(2d\) 个参数(\(d\) 个均值 + \(d\) 个方差),不是 \(d^2\) 量级。
KL divergence 有解析解。 两个对角高斯之间的 KL 散度可以用解析公式直接算出来,不需要蒙特卡洛近似。这一点对训练效率的影响非常大——每个 training step 都要算 KL,如果每次都需要数值估计,计算开销和方差都会显著增加。
容易采样。 从 \(\mathcal{N}(\mu, \sigma^2)\) 中采样只需要 \(z = \mu + \sigma \cdot \epsilon,\; \epsilon \sim \mathcal{N}(0, I)\)。
数值实现成熟。 几乎所有深度学习框架都有现成的高斯采样和 KL 计算。
层次拉到一起:需要 prior 是为了让 latent space 具有适合生成的全局结构;选连续连通的 prior 是为了鼓励 continuity 和 completeness;经典 VAE 偏偏选 \(\mathcal{N}(0, I)\),是因为它既满足建模需求,又特别简单、对称,而且 KL 有解析解。
一个容易过度解读的地方#
即使用了 \(\mathcal{N}(0, I)\) 加上 KL regularization,也不能在数学上严格保证 \(z_1 \approx z_2\) 就一定意味着 \(\text{Decoder}(z_1) \approx \text{Decoder}(z_2)\)。
标准高斯的 support 是整个 \(\mathbb{R}^d\),极端 tail 中的 \(z\) 是模型几乎没有训练过的区域。更准确的说法是:从 prior 的主要概率质量所在区域采样,更有机会落在 Decoder 训练过、能够合理解码的 latent region。
这不是缺陷,只是提醒自己不要把"鼓励"当成"保证"。
采样操作怎么做反向传播#
到这里有一个看起来很细节但其实很关键的技术问题:训练 VAE 的时候,需要从 \(q(z|x)\) 中采样一个 \(z\) 交给 Decoder。但"采样"是一个随机操作——梯度怎么穿过它?
训练的前向过程大致是:
$$ x \xrightarrow{\text{Encoder}} \mu, \sigma \xrightarrow{\text{sampling}} z \xrightarrow{\text{Decoder}} x' \to \text{loss} $$如果把"从 \(\mathcal{N}(\mu, \sigma^2)\) 中随机采样"当成一个黑盒操作,它不是 \(\mu\) 和 \(\sigma\) 的确定性函数——同样的 \(\mu\) 和 \(\sigma\),每次采出来的 \(z\) 不一样。梯度没有办法简单地沿着这个节点传回 Encoder。
VAE 的解法叫 reparameterization trick(重参数化技巧)。思路是把采样改写一下。
先从一个与网络参数完全无关的固定分布采样:
$$ \epsilon \sim \mathcal{N}(0, I) $$然后用确定性变换得到 \(z\):
$$ z = \mu + \sigma \odot \epsilon $$\(\odot\) 表示逐元素乘法。对于一次具体的 forward pass,\(\epsilon\) 已经采好了,是一个常量。而 \(z = \mu + \sigma \odot \epsilon\) 本身就是普通的加法和乘法——完全可微。所以梯度可以从 loss 经过 Decoder、经过 \(z\),正常传回 \(\mu\) 和 \(\sigma\),再传回 Encoder。
Reparameterization trick 的本质不是消除随机性——每次 forward 时 \(\epsilon\) 仍然是随机采样的。它做的是把随机性从依赖模型参数的采样操作中移出去,改写成"与参数无关的噪声 + 确定性的可微变换",从而让普通的反向传播可以工作。
顺便把一个前面提过但没展开的细节说清楚。Encoder 实际输出的不是 \(\sigma\),而是 \(\log \sigma^2\)(log variance)。原因很直接:方差必须为正(\(\sigma^2 > 0\)),但网络的输出可以是任意实数。让网络预测 \(\log \sigma^2 \in (-\infty, +\infty)\),然后用 \(\sigma = \exp(0.5 \cdot \log \sigma^2)\) 恢复标准差,就天然满足 \(\sigma > 0\),数值上也更稳定。
Prior:从哪里采样 z#
现在回到生成的问题。如果训练完成后,我们想生成新样本——不给具体的 \(x\),直接从 latent space 中采一个 \(z\)——我们需要知道"从哪里采"。
这就是 prior(先验分布)的角色。
Prior \(p(z)\) 回答的问题是:在没有看到任何具体输入 \(x\) 之前,latent variable \(z\) 应该大致遵循什么分布?
经典 VAE 的答案很简单:
$$ p(z) = \mathcal{N}(0, I) $$也就是一个标准多维高斯。
因为 latent \(z\) 通常是一个 \(d\) 维向量 \(z = (z_1, z_2, \ldots, z_d)\),所以这里的 \(\mathcal{N}(0, I)\) 是多维的。\(I\) 是单位矩阵(identity matrix),直观理解就是:每个 latent 维度独立、均值都是 0、方差都是 1。
这个 prior 提供了一个简单、明确、可以采样的全局规则。生成时只需要从这个分布里抽一个 \(z\),交给 Decoder 就行。
q(z|x) 与 p(z) 的冲突#
到这里有一个矛盾出现了。
一方面,对于每个训练输入 \(x\),Encoder 输出一个 conditional distribution \(q(z|x)\)。
另一方面,我们事先规定了 prior \(p(z) = \mathcal{N}(0, I)\),希望将来生成时能从这个分布采样。
问题是:如果 Encoder 想输出什么分布就输出什么分布,那 prior 还有什么意义?
比如 Encoder 完全可以学出:
$$ q(z|x_1) = \mathcal{N}(100,\, 0.01^2) $$$$ q(z|x_2) = \mathcal{N}(-500,\, 20^2) $$一个 \(z\) 集中在 100 附近,另一个跑到 -500 去了。训练时 Decoder 确实能适应这些位置。但将来生成时,我们从 \(\mathcal{N}(0, 1)\) 采样,采到的 \(z\) 根本不在 100 或 -500 附近——训练区域和采样区域完全对不上。
所以需要一种机制来衡量:每个 \(q(z|x)\) 到底和 prior \(p(z)\) 偏离了多少。
这就引出了 KL divergence。
KL Divergence 在比较什么#
KL divergence(Kullback–Leibler divergence,KL 散度)是一种衡量两个概率分布有多不一致的方法。
公式是:
$$ D_{\text{KL}}(q \| p) = \int q(z) \log \frac{q(z)}{p(z)} \, dz $$不需要通过积分来理解它。在 VAE 的语境里,它回答一个非常具体的问题:
对于这个输入 \(x\),Encoder 给出的 \(q(z|x)\) 与我们希望的 prior \(p(z)\) 之间,差距有多大?
- 如果 \(q(z|x)\) 和 \(p(z)\) 完全一样,KL = 0。
- \(q(z|x)\) 偏离 \(p(z)\) 越远,KL 越大。
下面的图直观展示了三种情况:
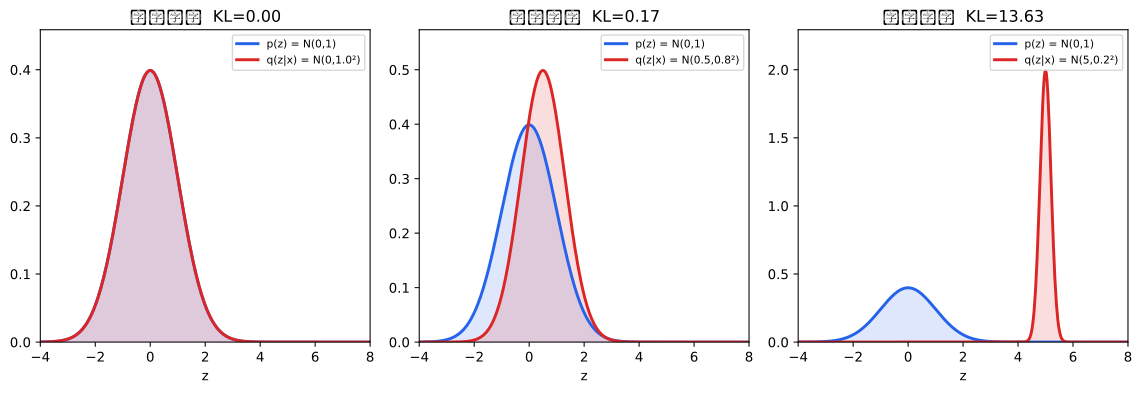
左图:两个分布完全重合,KL = 0。中图:稍有偏移,KL 较小。右图:严重偏离,KL 很大。
有一点需要额外说明:虽然直觉上可以把 KL 理解成衡量两个分布"距离多远",但数学上它不是 distance metric,因为一般来说 \(D_{\text{KL}}(q \| p) \neq D_{\text{KL}}(p \| q)\)——它不对称。这里不需要深入信息论,只需要知道 KL 是一种有方向的 divergence。
Reconstruction 与 KL 的拉扯#
这是我后来觉得理解 VAE 最重要的一个直觉。
VAE 的训练可以概念性地理解成同时满足两个目标:
$$ \text{Loss} \approx \text{Reconstruction} + \text{KL} $$这里我只是在建立训练目标的直观理解,不是给严格的 ELBO 定义。
Reconstruction 想做什么? 它希望从 \(z\) 能恢复出原始输入。这意味着不同输入的 \(q(z|x_1)\)、\(q(z|x_2)\)、\(q(z|x_3)\) 需要保持区别——如果所有输入都被编码成完全一样的分布,Decoder 就无法区分它们,重建质量会崩溃。
KL 想做什么? 它希望每个 \(q(z|x)\) 不要严重偏离 prior \(p(z) = \mathcal{N}(0, I)\)。如果某个输入的 \(q(z|x)\) 跑到了 \(\mathcal{N}(100, 0.01^2)\),KL 会很大,loss 会被惩罚。
这两个目标存在天然的张力。Reconstruction 想让每个输入的概率云尽量有特色、彼此可区分。KL 想把所有概率云往标准高斯覆盖的区域拉拢。
VAE 最终学到的 latent representation,是信息表达能力和全局规则性之间的折中。
两个容易产生的误解#
理解了 Reconstruction 与 KL 的拉扯之后,有两个容易出现的错误理解需要纠正。
第一个:KL 并不是要求所有 \(q(z|x)\) 都变成 \(\mathcal{N}(0, I)\)。如果所有输入都对应完全相同的标准高斯,那 latent \(z\) 就不携带任何关于输入的信息了,Decoder 没法重建任何东西。实际上不同输入的 \(q(z|x)\) 是不同的——比如一个输入可能对应 \(\mathcal{N}(-0.7, 0.8^2)\),另一个对应 \(\mathcal{N}(0.9, 0.6^2)\)——它们有区别,但都没有离 prior 特别远。
第二个:每个 \(q(z|x)\) 是高斯,不等于整个 latent space 上的分布就是一个高斯。 每个 conditional distribution \(q(z|x_i)\) 确实是高斯(因为我们这么定义的)。但如果把所有训练数据的 \(x\) 混在一起,得到的 aggregated distribution \(q(z) = \mathbb{E}_{x \sim p_{\text{data}}}[q(z|x)]\) 是很多高斯的混合,可能具有复杂的多峰形状。KL regularization 做的是推动每个 conditional distribution 不要严重偏离 prior,但不是说整体一定就是一个漂亮的标准高斯。
为什么 VAE 因此可以生成#
现在终于可以回到最初的问题:为什么 VAE 能做生成。
训练完成后,我们不需要一个现成的输入 \(x\)。直接从 prior 采样:
$$ z \sim p(z) = \mathcal{N}(0, I) $$然后把 \(z\) 交给 Decoder:
$$ z \xrightarrow{\text{Decoder}} \text{generated } x $$这就是 VAE 的生成过程。
这里最关键的一点:普通 Autoencoder 也有 Decoder,但它不能这样用,因为它的 latent space 没有被整理成一个我们知道如何采样的概率空间。 VAE 通过 KL regularization,让训练数据在 latent space 中的分布不至于离 prior 太远——这样从 prior 采样的 \(z\),有更大的概率落在 Decoder 见过、能产出合理输出的区域。
从 AE 到 VAE:真正改变了什么#
把前面的内容拉到一起看。
左边是普通 Autoencoder:输入经过 Encoder 变成一个确定性的 latent point,再由 Decoder 重建。训练目标是 reconstruction。Latent space 没有全局概率约束,不保证随机采样能得到合理输出。
右边是 VAE:Encoder 输出的不是一个点,而是一个分布 \(q(z|x)\) 的参数 \(\mu(x)\) 和 \(\sigma(x)\)。从这个分布中采样一个 \(z\),再交给 Decoder 重建。KL divergence 约束 \(q(z|x)\) 不要严重偏离 prior \(p(z) = \mathcal{N}(0, I)\)。
而生成路径完全绕过了 Encoder:直接从 \(p(z) = \mathcal{N}(0, I)\) 采样 \(z\),交给 Decoder 生成新样本。
我一开始理解错在哪里#
写到这里,回头看我最初的理解演化。
第一阶段,我把 VAE 理解成:
普通 Autoencoder 学一个确定性的 \(z\),VAE 学一个"符合高斯分布的 \(z\)"。
方向接近,但不准确。更准确的说法是:普通 Autoencoder 对每个输入得到一个确定性的 latent point;VAE 则对每个输入参数化一个 latent probability distribution \(q(z|x)\),经典 VAE 选择高斯 family,然后学习其参数 \(\mu\) 和 \(\sigma\)。
第二个卡点是"为什么 Encoder 出来的就一定是高斯"。修正后的理解:高斯不是训练发现的,而是建模假设。Encoder 网络的结构决定了输出是 \(2d\) 个数,设计者定义这些数参数化一个对角高斯。训练学习的是参数取什么值。
第三个容易滑过去的错误是"KL 就是让所有 latent distribution 都变成 \(\mathcal{N}(0, I)\)"。但如果真的全变成标准高斯,所有输入的信息就丢了。KL 是 regularization,它和 reconstruction objective 之间有张力;VAE 要在表达输入信息和遵守 prior 之间找到平衡。
本文没有展开的训练数学#
VAE 的训练还有一个值得继续追的问题:为什么训练目标恰好是 Reconstruction + KL? 更完整的回答需要从 variational inference(变分推断)出发,引出 evidence lower bound(ELBO,证据下界)的概念和推导。
到本文为止已经足够理解 VAE 的核心设计逻辑。ELBO 推导是后续深入训练数学的入口。
写在最后#
把全文压缩成一条因果链:
Autoencoder 对每个输入得到一个确定性的 latent point → 重建没有问题 → 但 latent space 没有被要求服从一个方便采样的全局分布 → 如果想主动生成新样本,不知道从哪里采样 \(z\) → VAE 把 \(x \to z\) 改成 \(x \to q(z|x)\) → 选择高斯 family,Encoder 学习 \(\mu(x)\) 和 \(\sigma(x)\) → 规定 prior \(p(z) = \mathcal{N}(0, I)\) → KL divergence 约束 \(q(z|x)\) 不要严重偏离 prior → Reconstruction 保证 \(z\) 仍然携带输入信息 → 最终得到一个既能表达数据,又可以从已知 prior 中采样的 latent space → 从 prior 采样 \(z\),交给 Decoder,生成新样本。
VAE 最值得记住的,不是某个 KL 公式或者 ELBO 推导,而是它对 latent representation 的重新定义:一个输入不再对应 latent space 中的一个确定点,而是对应一个概率分布。 一旦做出这个改变,prior、KL divergence、采样这些设计就不再是孤立的数学技巧,而是沿着同一条逻辑自然出现。
参考资料#
- MIT 6.S191: Introduction to Deep Learning — Lecture 4: Generative Modeling
- 从特征表示到生成语义:深入理解 Latent Variable 与 Latent Space
- 概率密度不是概率:连续随机变量为什么需要 PDF
- Kingma & Welling, Auto-Encoding Variational Bayes (2013)