
起因#
上一篇写完随机标签实验之后,我对泛化的理解更新了一轮:模型有能力记住随机标签,不代表它面对真实数据时只会死记硬背。capacity、learned function 和 generalization 是三件不同的事。
带着这个认知继续看 6.S191 Lecture 6 的内容,碰到了对抗攻击(Adversarial Attack)这个话题。看完之后我意识到,泛化好了,离"可靠"还差得远。
一个模型可以在正常测试集上达到很高的准确率,但只要对输入做一点精心设计的修改,它就可能产生完全错误的预测。
这件事值得停下来想一想。
经典的熊猫实验#
2015 年 Goodfellow 等人在论文 Explaining and Harnessing Adversarial Examples 中给了一个后来被反复引用的例子。
一张熊猫图片,ImageNet 分类器以 57.7% 的置信度正确识别为"panda"。研究者对这张图片添加了一个精心构造的微小扰动——每个像素的改变量小到人眼完全看不出区别。修改后的图片,同一个分类器以 99.3% 的置信度将其判定为"gibbon"(长臂猿)。
(原图见论文 Figure 1:https://arxiv.org/abs/1412.6572)
这里有几个概念需要过一下。被精心构造出来的、能欺骗模型的输入叫 Adversarial Example(对抗样本)。添加到原始输入上的那个微小修改叫 Adversarial Perturbation(对抗扰动)。
我第一次看这个例子时有两个反应。
第一,99.3% 的置信度看起来很高,但 Softmax 的输出值不等于"模型有 99.3% 的概率是对的"。Softmax 只是把 logits 归一化成一个概率分布,它可以在模型完全搞错的时候给出很高的数值。所以"高置信度地判错"这件事本身不算特别离谱。
第二,真正让我不舒服的是另一件事。这个模型在正常测试集上表现不差——它能正确识别各种各样的图片。但在一张它已经认对了的图片上,只要做一点人类察觉不到的修改,它就彻底改了主意。
模型能正确识别一张图片,不代表它对这张图片附近的输入变化也保持稳定。
随机噪声和对抗扰动有什么不同#
我最初想:如果随便加点噪声就能让模型犯错,那所有模型不都很脆弱吗?
但随机噪声通常不会改变分类结果。关键区别在于扰动的方向。
想象一个最简单的二维分类问题。有一条 Decision Boundary(决策边界),把输入空间分成两个区域,分别对应两个类别。一个样本点落在边界附近的某一侧。
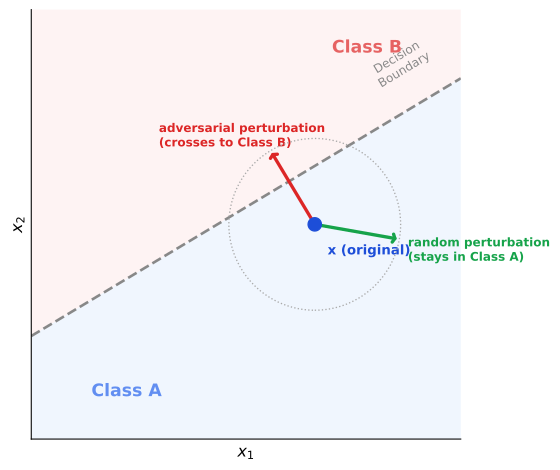
同样幅度的扰动,沿着平行于边界的方向移动,样本始终待在原来的类别区域里。但如果沿着垂直于边界的方向移动,样本可能跨过边界,进入另一个类别的区域。
随机噪声的方向是随机的,大部分时候不会恰好指向边界的另一侧。而对抗扰动是有目的地寻找那个能跨越边界的方向。
对抗攻击的关键不只是扰动的大小,还包括扰动的方向,以及样本与决策边界之间的距离。
攻击者怎么找到那个方向#
这里有一个我觉得很漂亮的对称关系。
正常训练模型时,输入 \(x\) 和标签 \(y\) 是固定的,我们通过反向传播计算 Loss 对参数 \(\theta\) 的梯度,然后沿着梯度的反方向更新参数,让 Loss 下降:
$$ \theta' = \theta - \eta \nabla_\theta L(\theta, x, y) $$现在反过来想:如果模型参数 \(\theta\) 固定不动,我们对输入 \(x\) 求梯度呢?
$$ \nabla_x L(\theta, x, y) $$这个梯度告诉我们:在当前输入 \(x\) 的位置,往哪个方向稍微改一下输入,Loss 会增大最快。
反向传播本来就能算这个——它计算 Loss 对计算图中所有节点的梯度,输入只不过是计算图的叶子节点之一。
Goodfellow 等人在此基础上提出了 FGSM(Fast Gradient Sign Method,快速梯度符号法):
$$ x_{\mathrm{adv}} = x + \epsilon \, \mathrm{sign}(\nabla_x L(\theta, x, y)) $$逐项拆开:\(\nabla_x L\) 是 Loss 对输入的梯度;\(\mathrm{sign}(\cdot)\) 取每个分量的符号(+1 或 -1);\(\epsilon\) 是一个控制扰动幅度的常数;最后把扰动加回原始输入,得到对抗样本 \(x_{\mathrm{adv}}\)。
一行公式,没有迭代,没有复杂优化,就能生成对抗样本。
为什么取 sign 而不直接用梯度#
这是学的时候一个值得细想的地方。既然已经算出了梯度,为什么不直接用梯度方向来构造扰动?为什么要多一步取 sign?
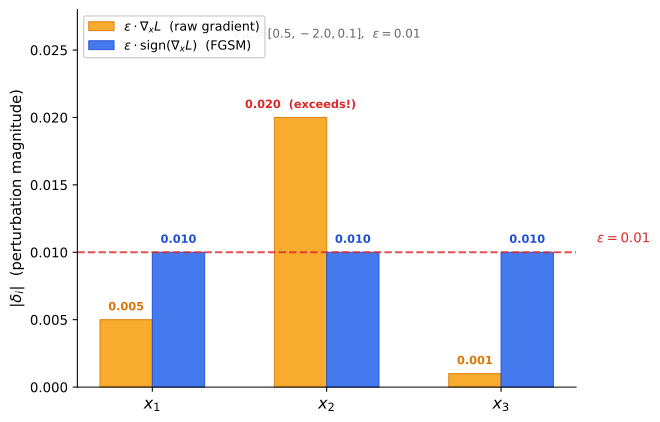
用一个三维的例子。假设梯度是:
$$ \nabla_x L = [0.5, -2.0, 0.1] $$如果直接用梯度乘以 \(\epsilon = 0.01\):
$$ \delta = \epsilon \cdot \nabla_x L = [0.005, -0.02, 0.001] $$第二个分量的绝对值是 0.02,已经超过了 \(\epsilon = 0.01\)。如果我们要求每个像素的改变量不超过 \(\epsilon\)(也就是 \(L_\infty\) 约束),直接缩放梯度不满足限制。
取 sign 之后:
$$ \delta = \epsilon \cdot \mathrm{sign}(\nabla_x L) = [0.01, -0.01, 0.01] $$每个分量的绝对值恰好等于 \(\epsilon\),满足约束,而且每个分量都把自己的扰动预算用满了。
更根本的原因来自一阶近似。Loss 在 \(x\) 附近的泰勒展开:
$$ L(x + \delta) \approx L(x) + \nabla_x L^\top \delta $$我们想在 \(\|\delta\|_\infty \leq \epsilon\) 的约束下,让这个增量 \(\nabla_x L^\top \delta\) 尽可能大。这是一个简单的线性优化问题,最优解就是让每个 \(\delta_i\) 取 \(\epsilon\) 乘以对应梯度分量的符号:
$$ \delta^* = \epsilon \, \mathrm{sign}(\nabla_x L) $$所以 FGSM 的 sign 不是一个近似或简化——它是 \(L_\infty\) 约束下一阶最优的扰动方向。
顺便提一句:如果约束换成 \(L_2\)(扰动向量的欧氏范数不超过某个值),那最优方向就变成了归一化后的梯度 \(\nabla_x L / \|\nabla_x L\|_2\),而不是 sign。不同的约束对应不同的最优扰动形式。
ε 究竟是什么#
我最初不太理解为什么要限制扰动。攻击的目标是让模型犯错,为什么不直接把输入改得更大?
后来想明白了:如果把一只熊猫的图片彻底改成另一种动物的样子,模型把它分类成另一种动物,这完全不奇怪,也不算模型犯错。
对抗样本有意思的地方在于:人类认为输入的语义没有改变,但模型的判断却改变了。
所以 \(\epsilon\) 是扰动预算(perturbation budget),不是学习率。它控制攻击者被允许对输入做多大程度的修改。
\(L_\infty\) 约束 \(\|\delta\|_\infty \leq \epsilon\) 的意思是:每个像素的改变量不超过 \(\epsilon\)。如果像素值归一化到 \([0, 1]\),常见的设置是 \(\epsilon = 8/255 \approx 0.031\),也就是每个像素最多改变约 3%。
需要说明的是,“数学上的小扰动"不严格等于"人类视觉上不可察觉”。\(\epsilon = 8/255\) 在大多数图片上确实难以察觉,但这是一个工程近似,不是理论保证。
用 PyTorch 实现 FGSM 只需要十几行:
1import torch
2import torch.nn.functional as F
3
4def fgsm_attack(model, x, y, epsilon):
5    x_adv = x.clone().detach().requires_grad_(True)
6    loss = F.cross_entropy(model(x_adv), y)
7    loss.backward()
8    x_adv = x + epsilon * x_adv.grad.sign()
9    return x_adv.clamp(0, 1).detach()
如果想要更强的攻击,可以迭代多次。PGD(Projected Gradient Descent)本质上就是多步 FGSM:每步走一小步,每步之后把结果投影回 \(\epsilon\)-球内。Madry 等人 2018 年的论文把 PGD 作为衡量模型鲁棒性的基准攻击方法。
高维空间为什么会放大对抗攻击#
到这里还有一个核心疑问:每个像素只改了这么一点点,加起来怎么就能让模型的输出发生这么大的变化?
Goodfellow 在同一篇论文里给了一个我觉得很漂亮的解释。先从最简单的线性模型开始。
假设 \(f(x) = w^\top x + b\),添加扰动 \(\delta\) 之后:
$$ f(x + \delta) = f(x) + w^\top \delta $$输出的变化量是 \(\Delta f = w^\top \delta\)。
先看一个只有 3 个特征的例子。假设 \(w = [0.1, 0.1, 0.1]\),\(\epsilon = 0.01\)。
如果扰动是随机的,每个 \(\delta_i\) 等概率取 \(+0.01\) 或 \(-0.01\):
$$ w^\top \delta = 0.1 \times (\pm 0.01) + 0.1 \times (\pm 0.01) + 0.1 \times (\pm 0.01) $$各项正负抵消,期望为 0,典型波动量级(标准差)大约是 \(0.001 \times \sqrt{3} \approx 0.0017\)。
如果扰动是对齐的(每个分量都取 \(+0.01\),即 \(\mathrm{sign}(w)\) 方向):
$$ w^\top \delta = 0.1 \times 0.01 \times 3 = 0.003 $$3 个维度看不出太大差别。但把同样的逻辑放到一张 \(224 \times 224 \times 3 \approx 150{,}000\) 维的图片上:
- 随机噪声:波动量级约 \(\epsilon \cdot |w| \cdot \sqrt{n} = 0.001 \times \sqrt{150{,}000} \approx 0.39\)
- 定向扰动:\(\epsilon \cdot |w| \cdot n = 0.001 \times 150{,}000 = 150\)
差了将近 400 倍。
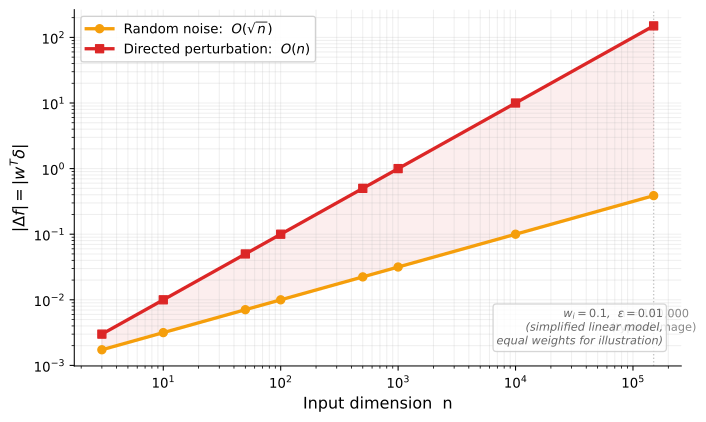
随机噪声因为方向不一致,各分量的贡献部分抵消,总效应按 \(O(\sqrt{n})\) 增长。定向扰动让每个分量都朝同一个方向贡献,总效应按 \(O(n)\) 增长。维度越高,两者的差距越大。
必须明确:上面的数量级分析依赖于简化假设——等大权重、线性模型、独立噪声。真实神经网络的权重分布和非线性结构更复杂,这些数字不是普适规律。 但直觉是对的:高维空间中大量微小扰动的有方向累积,可以产生比随机噪声大得多的效果。
这就是 Goodfellow 提出的 Linear Explanation:对抗样本的存在不需要非线性来解释,线性模型在高维空间中同样存在这个问题。深度网络的非线性不是对抗脆弱性的原因——恰恰相反,即使模型是线性的,高维输入空间本身就足以让微小的定向扰动产生大影响。
泛化好不等于鲁棒好#
到这里,我可以把这篇和上一篇的认知串起来了。
上一篇随机标签实验让我理解了:
模型有能力记住所有数据(高 capacity),不意味着它在真实数据上一定会死记硬背(能泛化)。
现在对抗攻击让我理解了另一层:
模型在正常测试集上泛化得很好,也不意味着它面对特定扰动时足够鲁棒。
想象一个假设性的场景:一个图像分类器训练准确率 99%,正常测试准确率 99%——按照标准评估,这个模型泛化得很好。但如果用 FGSM 对测试集生成对抗样本,准确率可能降到 20% 甚至更低。
这里涉及几个容易混淆的概念。
Standard Generalization(标准泛化):模型在和训练数据同分布的新数据上表现如何。
Adversarial Robustness(对抗鲁棒性):模型面对有目的的对抗扰动时表现如何。
Distribution Shift(分布偏移):测试数据的分布和训练数据不同。比如训练用的是晴天照片,测试时遇到了雨天照片。
Out-of-Distribution(分布外)样本:输入来自训练分布之外。
对抗扰动改变了输入,但改变后的输入是否算 OOD,取决于你怎么定义"分布"。如果把训练数据的 \(\epsilon\)-邻域都算在分布内,对抗样本就不是 OOD。如果只算训练集精确的数据流形,它可能算 OOD。这不是一个有唯一答案的问题。
关键是:正常准确率和鲁棒准确率是不同的评估维度。一个模型可以在第一个维度上表现优秀,在第二个维度上表现很差。
对抗攻击的实际意义#
我之前一直觉得对抗攻击是一个偏学术的话题。后来想了想:如果一个 ML 模型被部署在安全相关的场景中,它面对的不只是自然产生的输入,还可能有人主动寻找它的弱点。
几个真实的研究场景。
交通标志识别。 Eykholt 等人 2018 年的实验中,研究者在真实的停车标志上贴了几张特殊设计的贴纸。自动驾驶系统的分类器把它识别成了限速标志。这个实验是在物理世界中完成的——不是在像素层面修改数字图片,而是在实际标志上贴东西、用真实摄像头拍摄。
恶意软件检测。 如果安全系统用 ML 模型判断一个文件是否是恶意软件,攻击者可以对文件做微小修改(比如添加无效字节),让模型把恶意文件误判为正常文件,同时不影响文件的实际功能。
人脸识别。 研究者通过特殊设计的眼镜框就可以让人脸识别系统把一个人识别成另一个人。
需要注意三件事的区别:论文中在特定模型上攻击成功,不等于特定实际部署的系统一定可以被同样方式攻击,更不等于一个完整的安全系统会因此失效。实际系统可能有多层防御、输入预处理、异常检测等机制。
理解对抗攻击需要引入 Threat Model(威胁模型)的概念:攻击者能控制什么(输入?训练数据?模型参数?)、攻击者知道什么(模型架构?权重?只有输入输出接口?)、攻击者的目标是什么(让模型判错?判成特定类别?)。
如果攻击者完全知道模型的架构和参数,这叫 White-box Attack(白盒攻击),FGSM 就属于这一类。如果攻击者只能查询模型的输入输出,不知道内部结构,这叫 Black-box Attack(黑盒攻击)。有意思的是,很多对抗样本具有 transferability(迁移性)——在一个模型上生成的对抗样本,可能对另一个不同架构的模型也有效。
对抗机器学习(Adversarial ML)还包括其他方向,比如 Data Poisoning(数据投毒,在训练数据中混入恶意样本)和 Backdoor Attack(后门攻击,让模型在遇到特定触发模式时产生错误行为)。这些不在本篇范围内,但它们共享一个基本认识:传统机器学习关心模型能否正确处理自然产生的新输入。对抗机器学习还要考虑一个额外维度——有人在主动寻找模型的弱点。
Adversarial Training#
既然可以用梯度生成对抗样本,一个自然的想法是:能不能在训练时就把对抗样本考虑进去?
Adversarial Training(对抗训练)的目标可以写成:
$$ \min_\theta \mathbb{E}_{(x,y)} \left[ \max_{\|\delta\| \leq \epsilon} L(\theta, x + \delta, y) \right] $$这是一个 Min-Max Optimization(极小极大优化)问题。
内层的 \(\max\):对于当前的模型参数 \(\theta\),找到最强的扰动 \(\delta^*\),让 Loss 尽可能大。这一步本质上就是在做对抗攻击。
外层的 \(\min\):拿到这些最难的对抗样本之后,更新模型参数 \(\theta\),让模型即使面对这些最坏情况也尽量预测正确。
和普通的 Data Augmentation(数据增强)对比:Data Augmentation 一般使用随机裁剪、翻转、色彩抖动等方式,产生的是"自然"的变换。对抗训练产生的是"最难"的输入——不是随机变换,而是针对当前模型专门构造的。
对抗训练有几个需要注意的地方。
首先,它不保证能抵御所有攻击。模型在 PGD 攻击下变鲁棒了,不代表面对更强或不同类型的攻击也鲁棒。
其次,存在一种叫 Gradient Masking(梯度掩蔽)的现象:某些防御方法让攻击算法难以得到有用的梯度,表面上看攻击失败了,但模型并没有真正变得更安全。用更强的攻击方法一试,就会暴露问题。
最后,对抗训练有成本。内层的 \(\max\) 通常用多步 PGD 来近似,这意味着每个训练 batch 需要额外做若干次前向和反向传播。训练时间可能增加数倍。对抗训练后的模型在正常测试集上的准确率也可能略有下降——正常准确率和鲁棒性之间可能存在权衡。
写在最后#
回到开头的熊猫。
一张正确识别为熊猫的图片,加上人眼看不见的扰动,模型就说它是长臂猿。这不是因为模型"不好"——同一个模型在正常数据上表现完全正常。问题在于,正常数据上预测正确,和面对有目的的输入扰动时仍然保持正确,是两种不同的能力。
上一篇从随机标签实验里得到的认知是:能记住,不意味着不能泛化。
这一篇从对抗攻击里得到的认知是:泛化好,不意味着足够鲁棒。
参考资料#
- Ian Goodfellow, Jonathon Shlens, Christian Szegedy, Explaining and Harnessing Adversarial Examples, ICLR 2015 — https://arxiv.org/abs/1412.6572
- Aleksander Madry, Aleksandar Makelov, Ludwig Schmidt, Dimitris Tsipras, Adrian Vladu, Towards Deep Learning Models Resistant to Adversarial Attacks, ICLR 2018 — https://arxiv.org/abs/1706.06083
- Kevin Eykholt et al., Robust Physical-World Attacks on Deep Learning Visual Classification, CVPR 2018 — https://arxiv.org/abs/1707.08945
- MIT 6.S191, Introduction to Deep Learning — https://introtodeeplearning.com/