
起因#
上一篇搞清楚了 AllReduce、ReduceScatter 和 AllGather 三种通信原语,末尾提到 DDP 和 ZeRO Stage 2 选择了不同的通信原语组合,根本原因是参数更新的责任分配不同。
当时我把那句话写完就停了,因为还没想清楚一件事:
之前算过,7B 模型 BF16 + AdamW 的 Model States 是 112 GB。DDP 那篇也明确说了,DDP 每张 GPU 保存完整的参数、梯度和 Optimizer States——4 张卡各持 112 GB,集群总共 448 GB Model States,但单卡显存一点没省。
我当时的困惑是:4 张 GPU 通过 AllReduce 拿到了完全相同的平均梯度,然后各自用完全相同的 Optimizer States 做完全相同的参数更新,得到完全相同的新模型。这四份完全一样的工作,真的都有必要做吗?
顺着这个问题想下去,我发现 ZeRO 的三个 Stage 其实在依次消除一层冗余:
- 4 张 GPU 做完全相同的参数更新,真的每张都需要存完整的 Optimizer States 吗?
- 如果每张 GPU 只负责更新一部分参数,那它还需要拿到完整的平均梯度吗?
- 如果计算过程中不是所有参数同时被需要,那每张 GPU 有必要长期保存完整的模型参数吗?
这三个问题的前提不是天然成立的——每一条都来自上一个 Stage 的设计选择。这篇按顺序展开。
先把账对齐#
全文使用同一套实验设定,和7B 显存账本一致:
- 模型参数量:7B
- GPU 数量:4
- BF16 Parameters:2 bytes/param
- BF16 Gradients:2 bytes/param
- FP32 Master Weights:4 bytes/param
- AdamW First Moment \(m\):4 bytes/param
- AdamW Second Moment \(v\):4 bytes/param
其中 FP32 Master Weights 归入 Optimizer States(Mixed Precision 那篇解释了为什么 Master Weights 存在),所以每个参数对应的 Optimizer States 占 \(4 + 4 + 4 = 12\) bytes。

| 类型 | bytes/param | 7B 占用 |
|---|---|---|
| Parameters (BF16) | 2 | 14 GB |
| Gradients (BF16) | 2 | 14 GB |
| Optimizer States | 12 | 84 GB |
| 合计 | 16 | 112 GB |
这里需要说明的是:这是明确指定的简化 BF16 mixed precision + AdamW 配置。不同的训练框架对梯度精度和 Master Weights 的处理不尽相同,但 16 bytes/param 是 ZeRO 论文使用的典型设定,方便比较。
全文用十进制 GB(\(1\ \text{GB} = 10^9\ \text{bytes}\))表示 Model States 的理论账本。涉及实际 GPU 显存容量时使用 GiB(\(1\ \text{GiB} = 2^{30}\ \text{bytes}\))。
DDP:每张 GPU 都在做一样的事#
DDP Bucketing 那篇详细讲了 DDP 的通信优化,这里不重复。只提和 ZeRO 直接相关的一个事实。
DDP 的一次训练迭代:
- 每张 GPU 持有相同的模型参数。
- 不同 GPU 拿到不同的 mini-batch 做 forward。
- Backward 计算本地梯度。
- AllReduce 使所有 GPU 拿到相同的平均梯度。
- 每张 GPU 用相同的 Optimizer States 独立执行完整的参数更新。

第 5 步结束后,4 张 GPU 的模型参数仍然完全一致——因为旧参数一样、平均梯度一样、Optimizer States 一样、更新规则一样。
让我停下来想了一会儿的是这件事:第 5 步中 4 张 GPU 做的事情是完全相同的。不是"大体相同"——是数学上严格相同。每张 GPU 用相同的参数 \(\theta_t\)、相同的平均梯度 \(\bar{g}_t\)、相同的一阶矩 \(m_t\)、相同的二阶矩 \(v_t\),执行相同的 AdamW 更新公式。4 张 GPU 的计算完全冗余。
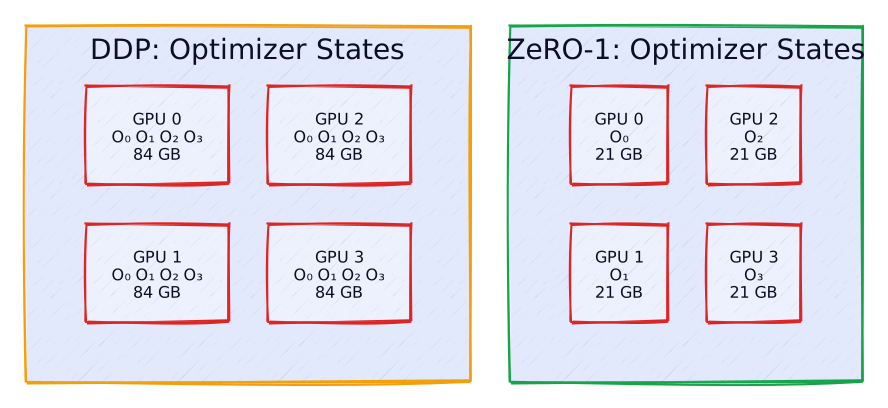
更关键的是,这意味着 4 份 Optimizer States 也是完全一样的。84 GB 的 Optimizer States 重复存了 4 份,集群里共 336 GB——但信息量只有 84 GB。
ZeRO-1:Optimizer States 为什么可以分片#
先用最简单的例子理解思路。
两张 GPU,模型只有两个参数 \(W = [W_0, W_1]\)。
在 DDP 中:
- GPU 0 保存 \(O_0, O_1\)(两个参数各自的 Optimizer States),更新 \(W_0, W_1\)。
- GPU 1 保存 \(O_0, O_1\),同样更新 \(W_0, W_1\)。
两份完全一样的工作。
ZeRO-1 的思路很直接:既然更新结果一样,每张 GPU 只负责更新一部分参数就够了。
- GPU 0 只保存 \(O_0\),只负责更新 \(W_0\)。
- GPU 1 只保存 \(O_1\),只负责更新 \(W_1\)。
这个分工成立的前提是:AdamW 对不同参数的更新是独立的。 更新 \(W_0\) 只需要 \(W_0\) 自己的梯度和 Optimizer States(\(m_0, v_0\)),完全不需要 \(W_1\) 的动量信息。反过来也一样。
但这引出了一个问题。
假设更新前 \(W = [10, 20]\)。GPU 0 把 \(W_0\) 更新到 9,GPU 1 把 \(W_1\) 更新到 18。此时:
- GPU 0 本地的参数:\([9, 20]\)(\(W_1\) 没有被更新)
- GPU 1 本地的参数:\([10, 18]\)(\(W_0\) 没有被更新)
两张 GPU 的模型参数不一致了。如果直接开始下一轮 forward,它们会算出不同的结果,模型就分叉了。
所以 ZeRO-1 在 optimizer step 之后需要一步 AllGather:每张 GPU 把自己更新好的参数分片发给所有人,拼成完整的新模型 \(W' = [9, 18]\)。
这里有一件事值得记住。DDP 不需要在 optimizer step 后额外同步参数,是因为每张 GPU 都执行了相同的完整更新——参数天然一致。ZeRO-1 改变了这个前提:每张 GPU 只更新一部分参数,所以更新后必须通过 AllGather 重新同步。
回到 7B 模型。ZeRO-1 把 84 GB 的 Optimizer States 平分给 4 张 GPU:
$$ M_{\text{ZeRO-1}} = 14 + 14 + \frac{84}{4} = 49\ \text{GB} $$从 112 GB 降到 49 GB。Optimizer States 是 Model States 中占比最大的部分(84/112 = 75%),分片掉它的效果非常直接。
ZeRO-2:梯度为什么也可以分片#
ZeRO-1 之后,每张 GPU 只负责更新自己分到的参数。比如 GPU 0 只更新 \(W_0\)。
那一个自然的问题就是:GPU 0 既然只需要 \(W_0\) 的平均梯度来更新 \(W_0\),为什么还要保存 \(W_1, W_2, W_3\) 的平均梯度?
我一开始想的时候在这里停顿了一下,因为有个容易混淆的地方需要先区分清楚:
- 每张 GPU 都执行完整模型的 backward。 要计算任意一个参数的梯度,activation gradients 必须从 loss 沿计算图一路传播到该参数的位置——这意味着完整的 backward pass 会为所有参数产生梯度,不能只算"自己负责的那部分"。
- 每张 GPU 计算的本地梯度来自不同 mini-batch。 所以不同 GPU 对同一个参数的梯度数值不一样。
- 归约后的平均梯度不必在每张 GPU 上完整保留。 GPU 0 只更新 \(W_0\),那它只需要 \(\bar{g}_0\) 就够了。
第 1 点和第 3 点不矛盾。每张 GPU 确实要完整地跑一遍 backward——计算量没有变。但计算完之后,归约结果可以只保留自己需要的那一片。
这恰好是 ReduceScatter 做的事情。通信原语那篇用过一个具体数值的例子:
两张 GPU,各自的本地梯度:\(G^{(0)} = [2, 6]\),\(G^{(1)} = [4, 10]\)。
AllReduce 的结果——两张 GPU 都拿到完整平均梯度 \([3, 8]\)。
ReduceScatter 的结果——GPU 0 拿到 \([3]\),GPU 1 拿到 \([8]\)。
ReduceScatter 同时完成了跨 GPU 梯度归约和结果分片。 归约的数学运算是一样的(求和或求平均),区别只在于最终每张 GPU 持有什么。
说明一下:这里用平均梯度方便理解。实际实现中 ReduceScatter 通常执行求和操作,平均所需的缩放由框架在其他环节完成。
ZeRO-2 的完整流程:
- Forward。
- Backward 产生本地梯度(完整模型的梯度,覆盖所有参数)。
- ReduceScatter 梯度(每张 GPU 拿到自己负责的那一片平均梯度)。
- 每张 GPU 用分片梯度和分片 Optimizer States 更新对应的参数。
- AllGather 更新后的参数分片,恢复完整模型。
显存推导:
$$ M_{\text{ZeRO-2}} = 14 + \frac{14}{4} + \frac{84}{4} = 14 + 3.5 + 21 = 38.5\ \text{GB} $$
需要注意的是,ZeRO-2 中 Parameters 仍然是完整的 14 GB。参数没有分片——分片的只是归约后的梯度和 Optimizer States。
还有一个容易忽略的细节:ZeRO-2 的 backward 仍然在计算完整模型的梯度。activation gradients 的传播覆盖了整个计算图,所以每张 GPU 会为所有参数产生本地梯度,而不是只算"自己负责的参数"的梯度。但梯度可以随 bucket 逐步归约和释放:一个 bucket 的梯度 ReduceScatter 完成后,不属于自己的分片可以立即丢掉,不需要整份本地梯度同时常驻显存。
为什么 ZeRO-2 的通信量和 DDP 接近#
这个问题我在看通信原语的时候想了一会儿,现在用 7B 的数字正式过一遍。
通信原语那篇已经说明了 Ring AllReduce 可以分解为两个阶段:
$$ \text{AllReduce} = \text{ReduceScatter} + \text{AllGather} $$DDP 对梯度做 AllReduce,拆开看:
- ReduceScatter(Gradients):每张 GPU 拿到归约梯度的一个分片
- AllGather(Gradients):每张 GPU 把分片广播出去,所有 GPU 恢复完整归约梯度
ZeRO-2 做的事情:
- ReduceScatter(Gradients):和 DDP 一样
- 每张 GPU 用分片梯度更新分片参数
- AllGather(Parameters):每张 GPU 把更新后的参数分片广播出去

用 Ring Collective 的公式。对于 \(N\) 个 GPU,完整张量大小为 \(S\),每张 GPU 的累计发送数据量为:
$$ V = \frac{N-1}{N} \times S $$在本例中,BF16 Gradients 和 BF16 Parameters 大小相同,都是 14 GB。4 张 GPU:
| 通信步骤 | DDP | ZeRO-2 |
|---|---|---|
| ReduceScatter | \(\frac{3}{4} \times 14 = 10.5\) GB (Gradients) | \(\frac{3}{4} \times 14 = 10.5\) GB (Gradients) |
| AllGather | \(\frac{3}{4} \times 14 = 10.5\) GB (Gradients) | \(\frac{3}{4} \times 14 = 10.5\) GB (Parameters) |
| 每卡发送总量 | 21 GB | 21 GB |
两者的每卡理论发送数据量相同。
但这个结论需要严格限定条件:
- BF16 Gradients 和 BF16 Parameters 大小一样(都是 2 bytes/param × 7B = 14 GB)。如果梯度和参数使用不同精度(比如 FP32 梯度),数据量就不同。
- 使用理想的 Ring Collective 算法。实际实现可能有不同的通信拓扑和分块策略。
- 只看发送字节量。通信次数、同步延迟、Bucket 粒度、能否与计算 overlap——这些都会影响实际耗时,但不会改变理论字节数。
21 GB 发送数据量相同,不等于两者训练耗时相同。
ZeRO-3:参数为什么也可以分片#
到这里,ZeRO-2 已经把 Gradients 和 Optimizer States 都分片了,每张 GPU 只存 \(\frac{1}{N}\) 的梯度和优化器状态。但 Parameters 还是完整保留——每张 GPU 都持有 14 GB 的模型参数。
一个自然的想法是:forward 和 backward 的计算过程中,不是所有参数同时被需要——在任一时刻,只有正在参与计算的那部分参数必须在显存中。能不能把参数也分片,需要的时候再收集?
这就是 ZeRO-3 的思路。但我第一次看 ZeRO-3 的时候产生了一个误解。
我以为 ZeRO-3 是这样工作的:
- GPU 0 保存 Layer 0 的完整权重
- GPU 1 保存 Layer 1 的完整权重
- GPU 2 保存 Layer 2 的完整权重
- GPU 3 保存 Layer 3 的完整权重
但想了想发现,这更像是 Pipeline Parallelism 的分工方式——不同 GPU 负责不同 Layer 的计算。ZeRO-3 做的事情不一样。
ZeRO-3 中,即使是同一个 Layer 的权重,也被分片存储在多个 GPU 上。
举个例子。假设某一层有 8 个参数 \(W = [w_0, w_1, \ldots, w_7]\),分到 4 张 GPU 上:
- GPU 0 长期存储:\([w_0, w_1]\)
- GPU 1 长期存储:\([w_2, w_3]\)
- GPU 2 长期存储:\([w_4, w_5]\)
- GPU 3 长期存储:\([w_6, w_7]\)
当需要计算这一层时:
- AllGather 该层的参数分片 → 每张 GPU 临时获得完整的 \([w_0, w_1, \ldots, w_7]\)。
- 每张 GPU 用完整参数计算自己 mini-batch 的 forward。
- 计算完成后释放临时收集来的完整参数,只保留自己的分片。
参数分片存储,不意味着模型的计算量被分成了四份。 每张 GPU 仍然用完整的参数做自己 mini-batch 的完整 forward。分片的是存储所有权,不是计算量。
实际的参数分片和 AllGather 粒度由框架组织,不一定严格按每个 Layer 精确四等分。这里用 Layer 做例子是为了直观。
Backward 为什么需要再次 AllGather#
这件事我一开始没注意到。
以一个简化的线性层为例:
$$ Y = XW $$Forward 需要 \(W\) 来算 \(Y\)。但 backward 计算输入梯度时也需要 \(W\):
$$ \frac{\partial L}{\partial X} = \frac{\partial L}{\partial Y} \cdot W^T $$如果 forward 完成后释放了收集来的完整 \(W\),那 backward 到达这一层时,需要再次 AllGather 把 \(W\) 收集回来。

这就产生了一个 Trade-off:
方案 A:Forward 用完就释放完整参数。Backward 再次 AllGather。
- 通信量更大(多一次 AllGather)
- 峰值显存更小(完整参数不长期驻留)
方案 B:Forward 后保留完整参数,直到 Backward 用完。
- 通信量更小(少一次 AllGather)
- 峰值显存更大(完整参数跨越整个 forward-backward 周期常驻)

实际框架(如 DeepSpeed)通常提供 prefetch 和部分缓存的策略,而不是简单二选一。但核心 Trade-off 就是这两个方向。这篇不展开具体实现——理解"forward 和 backward 可能各需要一次 AllGather"这件事,对后面分析通信量就够了。
28 GB 是怎么来的#
ZeRO-3 把所有三部分都分片:
$$ M_P = \frac{14}{4} = 3.5\ \text{GB} $$$$ M_G = \frac{14}{4} = 3.5\ \text{GB} $$$$ M_O = \frac{84}{4} = 21\ \text{GB} $$$$ M_{\text{ZeRO-3}} = 3.5 + 3.5 + 21 = 28\ \text{GB} $$四种方案放在一起:
| 方案 | Parameters | Gradients | Optimizer States | 总计 |
|---|---|---|---|---|
| DDP | 14 | 14 | 84 | 112 GB |
| ZeRO-1 | 14 | 14 | 21 | 49 GB |
| ZeRO-2 | 14 | 3.5 | 21 | 38.5 GB |
| ZeRO-3 | 3.5 | 3.5 | 21 | 28 GB |
从 112 GB 到 28 GB,缩小到原来的四分之一。
但必须说清楚:28 GB 是理论 Model States 的分片账本,不是实际训练的峰值 GPU 显存。 实际峰值显存还包括:
- Activations(可以通过 Checkpointing 压缩,但不为零)
- AllGather 临时收集的完整参数(ZeRO-3 forward/backward 时的临时缓冲)
- 通信 Buffers
- CUDA Runtime 和 PyTorch 内存分配器开销
把 28 GB 说成"训练只需要 28 GB GPU 显存"是不准确的。
ZeRO-3 的通信量为什么更多#
用一个简化的模型算一下。假设:
- Forward 时收集一次完整模型参数(AllGather)
- Backward 时再收集一次完整模型参数(AllGather)
- Backward 后 ReduceScatter 一次完整模型梯度
- 不做参数缓存复用
每张 GPU 的累计发送数据量:
$$ V_{\text{ZeRO-3}} = 3 \times \frac{N-1}{N} \times S $$其中 \(S\) 是完整参数/梯度大小(14 GB),\(N = 4\):
$$ V_{\text{ZeRO-3}} = 3 \times \frac{3}{4} \times 14 = 31.5\ \text{GB} $$对比 ZeRO-2 的 21 GB,ZeRO-3 的发送字节量约为 1.5 倍。
但数据量增多只是一半的故事。更关键的变化是通信和计算之间的依赖关系。
ZeRO-2 的通信(梯度 ReduceScatter 和参数 AllGather)主要发生在 backward 结束之后和下一轮 forward 开始之前。DDP Bucketing 那篇详细讲过,梯度通信可以和 backward 计算 overlap。
ZeRO-3 不同。forward 计算某一层之前,必须先等那一层的参数 AllGather 完成。backward 也一样。通信出现在了计算的关键路径上——必须等参数到达才能开始算。
ZeRO-3 不只是增加了通信量,还改变了通信与计算之间的依赖关系。 实际框架可以通过 prefetch(在计算当前层时预取下一层的参数)来缓解这个问题,但计算对通信的硬依赖是 ZeRO-3 的固有特征。
不是 Stage 越高越好#
假设一个场景:4 张 80 GiB GPU 训练 7B 模型。
| 配置 | 实际峰值显存 | 吞吐量 |
|---|---|---|
| ZeRO-2 | 58 GiB | 1000 samples/s |
| ZeRO-3 | 45 GiB | 850 samples/s |
(这是假设的教学数字,不是某个特定硬件上的实测结果。)
ZeRO-2 的峰值显存 58 GiB,没有 OOM。ZeRO-3 进一步降到 45 GiB,节省了 13 GiB——但吞吐量从 1000 降到 850 samples/s,慢了 15%。
空闲显存不能自动转化为更快的计算。额外通信带来的延迟是实实在在的开销。如果 ZeRO-2 已经能放下模型,那多出来的通信就是净损失。
但 ZeRO-3 并非没有用武之地:
- 模型大到 ZeRO-2 放不下(Parameters 14 GB + Activations 开销使单卡超过 80 GiB)
- 显存节省使得更大的 micro-batch 或更长的 sequence length 成为可能,从而提高计算利用率
- 某些模型规模下,ZeRO-3 + 更大 batch 的吞吐量可能反超 ZeRO-2 + 小 batch
结论不是 ZeRO-2 永远比 ZeRO-3 好。选择 Stage 的标准是完整工作负载下的显存和吞吐量,而不是"Stage 越高一定越优"。
写在最后#
把这条线走一遍之后,有三件事让我觉得比较值得记住。
计算在哪里执行,与训练状态在哪里长期存储,不必是同一个问题。 ZeRO-3 的每张 GPU 仍然做完整模型的 forward 和 backward,但参数、梯度和 Optimizer States 只存自己的 \(\frac{1}{N}\)。需要时临时收集,用完释放。这个"按需聚合、用后释放"的模式是 ZeRO 最核心的想法。
ZeRO 是渐进消除 Model States 的冗余存储,而不是通过减少每张 GPU 的计算量来节省显存。 三个 Stage 依次分片 Optimizer States、Gradients、Parameters,但每张 GPU 的 forward/backward 计算量并没有减少。省的是存储,不是计算。
显存、通信和吞吐量之间存在 Trade-off。 Stage 越高,单卡 Model States 越小,但通信量越大、通信与计算的耦合越紧。Stage 2 理论通信量可以和 DDP 持平;Stage 3 约为 1.5 倍,且通信更容易进入关键路径。在具体的硬件和模型规模下,哪个 Stage 综合最优需要实际测量。
回看这个系列的几篇文章,它们其实在讨论同一个问题的不同解法:
- Activation Checkpointing:以重计算换 Activation 显存
- CPU Offloading:以跨设备数据搬运换 GPU 显存
- ZeRO:以跨 GPU 状态分片和通信换 Model States 显存
三种思路都不会让数据凭空消失——它们改变的是数据在时间和空间上的分布方式。
参考资料#
- 7B 模型只有 14 GB 权重,一张 80 GB GPU 为什么仍可能 OOM?
- GPU 显存不够怎么办?Checkpointing 与 Offloading 的工程权衡
- 深入理解 PyTorch DDP:为什么更少的通信,不一定意味着更快的训练?
- 从 AllReduce 到 Ring:分布式训练中的通信原语
- 从 AMP 到 Mixed Precision:训练和推理为什么不使用同一种精度
- Rajbhandari et al. ZeRO: Memory Optimizations Toward Training Trillion Parameter Models. SC 2020.
- DeepSpeed ZeRO Tutorial
- MIT 6.S191: Introduction to Deep Learning — Lecture 9: Secrets to Massively Parallel Training. https://introtodeeplearning.com/