
起因#
上一篇聊随机标签实验的时候,我把注意力放在了模型容量和假设空间上:一个参数量巨大、完全有能力死记硬背随机噪声的神经网络,为什么在面对真实规律的数据时,依然能找到泛化良好的解。
当时顺着那个思路想下去,脑子里其实默认了一个挺自然的前提:只要训练误差很低,同时在独立留出的测试集上也拿到了极高的准确率(比如 98%),那这个模型的泛化能力就得到了充分证明,可以放心交付了。
但在实际工作中,以及最近继续看 MIT 6.S191(2026 年 Lecture 6: New Frontiers)的内容时,一个更现实也更棘手的问题浮了上来:
如果一个模型在离线测试集上的表现确实无可挑剔,为什么一旦部署到真实的生产环境,依然可能遭遇断崖式的性能滑坡?
从"能拟合训练集且在测试集上泛化",到"在未来的生产系统中长期可靠",这中间究竟漏掉了什么假设?
这篇文章想把我对这个问题的思考过程和认知转变记录下来。
测试集准确率 98%,究竟证明了什么?#
先看一个在工程开发中很常见、甚至被视为标准的场景。
我们准备了 100 万张标注图片作为训练集,另外严格隔离出 10 万张图片作为测试集。经过数天的训练与调优,模型在训练集上的准确率达到了 99%,在测试集上的准确率达到了 98%。
从常规的机器学习视角来看,这几乎是一个教科书式的理想模型:训练集没有欠拟合,测试集与训练集的差距仅有 1 个百分点,显然没有严重的过拟合。
按照通常的直觉,我们很容易顺理成章地下结论:这个模型上线之后,准确率也应该稳定在 98% 左右。
但事实往往会泼冷水。在线上运行一段时间后,业务监控里的真实表现可能会一路跌到 90%、80%,甚至更低。
模型还是那个模型,权重文件的 MD5 没有变,推理引擎的代码一行没改,为什么测试集的表现无法平移到生产环境?
答案其实藏在测试集最初被构造出来时所依赖的前提假设里。
被忽略的 IID 假设#
我们在教科书里经常看到一个缩写:IID(Independent and Identically Distributed,独立同分布)。
这个词由两部分组成:
- Independent(独立):每个样本的抽取与其他样本互不影响。
- Identically Distributed(同分布):所有样本都采样自同一个潜在的底层概率分布。
在实际操作中,我们通常采用随机划分的方式把原始数据集切分成训练集和测试集。很多人会下意识地觉得,只要划分是完全随机的,样本自然就是独立同分布的。
但其实完全不是这样。
举个很直观的例子:假设我们在处理一段连续监控视频中的目标检测。如果我们把视频里的所有连续帧打散,随机抽取 80% 放入训练集,剩余 20% 放入测试集。虽然划分算法是随机的,但第 100 帧和第 101 帧在视觉内容、光照条件、背景物体上高度重叠。测试集里的样本与训练集里的样本存在强烈的相关性,它们在统计上根本谈不上独立。
更根本的问题在于"同分布"。
哪怕我们的数据采集非常规范,样本之间足够独立,随机划分也只能保证一件事:测试集与训练集来自同一个历史采样池。
用概率符号来表达:
- 训练集数据服从历史联合分布:\( P_{\text{train}}(X, Y) = P_{\text{history}}(X, Y) \)
- 测试集数据同样服从该分布:\( P_{\text{test}}(X, Y) = P_{\text{history}}(X, Y) \)
- 但生产环境中实时流入的数据,服从的是当前演化后的分布:\( P_{\text{prod}}(X, Y) \)
测试集之所以能给出 98% 的高分,是因为它和训练集浸润在同一个 \( P_{\text{history}} \) 之中。它能够严格评估模型把在训练集上学到的规律推广到"同一分布下未见样本"的能力。
但生产环境的分布 \( P_{\text{prod}} \) 并没有参与当初的抽样。测试集从来没有预知未来的特异功能。
测试集并不天然代表真实世界#
想通这一点之后,我对测试集的态度发生了一个转变。
以前我会觉得测试集比训练集更客观、更纯粹,因而天然更贴近"真实世界"。但仔细推敲就会发现,测试集和训练集在数据来源上没有本质区别,它们都是在过去某个特定时间窗口、特定设备环境、特定用户群体下采集切片出来的产物。
它们唯一的区别,仅仅在于是否参与了梯度的计算与反向传播。
有人可能会问:如果我在测试集上采集了极其海量的样本,比如测了 100 万个点,置信区间收窄到极小的范围,能不能对抗生产环境的衰减?
可以粗略看一眼统计直觉:如果在 10 万个独立同分布的测试样本上测得准确率为 98%,常规的 95% 置信区间大约在 \([97.91\%, 98.09\%]\)。这个极窄的区间确实说明了一件事:在当前的测试分布下,模型的准确率几乎确定就是 98%,抽样估计的方差极小。
然而,这种高精度的保证是有条件的。它保证的是模型对 \( P_{\text{test}} \) 这一特定分布的期望误差。如果线上世界的 \( P_{\text{prod}} \) 和 \( P_{\text{test}} \) 发生了偏移,那么哪怕我们在离线测试集上把数字估计到了小数点后四位,对生产环境的准确率依然没有直接约束力。
测试集能够证明模型在已划定分布内的泛化能力,但无法无条件保证模型在未来未知环境中的泛化表现。
数据分布变化意味着什么?#
既然问题出在 \( P_{\text{test}} \) 与 \( P_{\text{prod}} \) 的不一致上,那么这种分布变化(Distribution Shift)究竟是如何具体影响模型表现的?
很多初学者(包括我早期的直觉)容易把分布变化想象成一种灾难性的突变。但实际上,它往往是以非常隐蔽、看似合理的方式发生的。
白天与夜间的猫狗识别#
看一个简化的二分类场景。
假设我们训练了一个识别猫和狗的图像分类模型。受限于摄像头在暗光下的成像质量,模型在不同光照条件下的分类能力存在固有差异:
- 在光照良好的白天图片上,模型准确率为 99%;
- 在光线昏暗、噪点较多的夜间图片上,模型准确率为 89%。
在最初构建测试集时,白天的样本占了 90%,夜间的样本只占 10%。
那么测试集上的整体准确率就是两者的加权平均:
$$ \text{Acc}_{\text{test}} = 0.90 \times 99\% + 0.10 \times 89\% = 89.1\% + 8.9\% = 98.0\% $$测试报告上的数字非常漂亮:98%。
随后模型被部署到真实的安防或者宠物监测系统中。由于用户更倾向于在下班回家后的夜间查看设备,线上实际捕获的请求分布变成了:白天样本仅占 30%,夜间样本占到了 70%。
此时线上生产环境的整体准确率变成了:
$$ \text{Acc}_{\text{prod}} = 0.30 \times 99\% + 0.70 \times 89\% = 29.7\% + 62.3\% = 92.0\% $$从 98% 直接掉到了 92%。
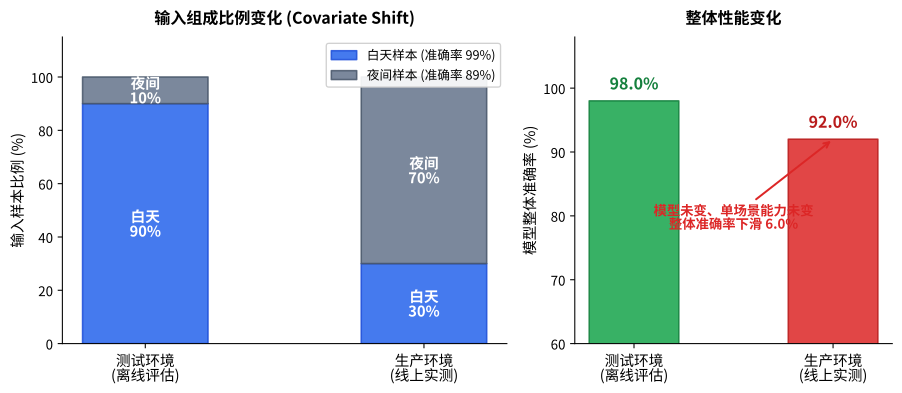
这个例子最值得琢磨的地方在于:
- 模型权重完全没有被破坏;
- 模型处理白天图片的准确率依然是 99%,处理夜间图片的准确率依然是 89%;
- 给定任意一张图片 \( X \),它究竟是猫还是狗的物理规律 \( P(Y|X) \) 也没有任何变化。
仅仅是因为输入特征中不同场景出现的相对频率 \( P(X) \) 发生了变动,整体系统的有效性就出现了明显退化。在这个案例中,夜间这种模型相对薄弱的区域,在线上被显著放大了。
分布偏移一定导致模型性能下降吗?#
顺着上面的逻辑,我当时产生过一个反向的思考:只要分布发生变化,模型效果就一定会下滑吗?
答案其实是否定的。
假设我们通过架构升级或算子优化,把夜间图片的识别准确率也提到了 98%,即白天和夜间模型的准确率全部是 98%。此时,哪怕白天与夜间的比例从 9:1 变成 1:9,加权后的整体准确率依然稳稳停留在 98%。
甚至,如果线上白天图片的比例从 90% 提升到了 99%,整体准确率还会逆势上升到 98.9%。
所以,Distribution Shift 本身并不必然导致性能衰减。
真正决定模型生死的是:发生偏移后的数据,是否更大规模地涌向了模型尚未掌握、或者原本就表现脆弱的输入子空间。
Covariate Shift 与 Label Shift#
在机器学习文献中,分布偏移通常会被细分。我在刚接触这些概念时,曾觉得学术界区分它们有点繁琐,直觉上不都是样本比例变了吗?
后来发现,区分它们的核心在于搞清楚在变化发生时,系统里究竟还有哪个条件概率保持着稳定。
用贝叶斯公式展开联合概率:
$$ P(X, Y) = P(X) P(Y|X) = P(Y) P(X|Y) $$通常最常见的两类偏移可以整理为一张简洁的对照表:
| 偏移类型 | 发生变化的分布 | 保持不变的条件关系 | 直观物理含义 |
|---|---|---|---|
| Covariate Shift(协变量偏移) | \( P(X) \) 变化 | \( P(Y \mid X) \) 不变 | 输入的背景、光照或人群比例变了,但给定输入后的真实分类规律没变 |
| Label Shift(标签偏移) | \( P(Y) \) 变化 | \( P(X \mid Y) \) 不变 | 目标类别的先验占比变了(如流感爆发季患病率上升),但特定类别对应的特征表现没变 |
上面的猫狗识别案例,就是一个标准的 Covariate Shift:输入图像的分布 \( P(X) \) 发生了昼夜比例漂移,但给定一张具体图片后判定猫狗的条件概率 \( P(Y|X) \) 依然是稳定的。
Concept Drift:输入分布稳定,规律却可能失效#
如果说 Covariate Shift 只是输入比例的再分配,那么另一种偏移形式则要隐蔽和致命得多:Concept Drift(概念漂移)。
假设我们在构建一个量化金融或商品价格的预测模型:
- 输入特征 \( X \):今天某资产价格是否上涨(1 代表上涨,0 代表下跌);
- 预测目标 \( Y \):明天该资产价格是否上涨。
在历史回测与测试区间内,市场处于某种特定趋势行情中,统计显示:
$$ P_{\text{test}}(Y=1 \mid X=1) = 0.90 $$只要今天上涨,明天继续上涨的概率高达 90%。模型很轻松地学到了这个规律,测试准确率极高。
然而模型上线后,宏观经济周期转变,或者市场交易机制和博弈对手方发生了重构。在线上生产环境中:
$$ P_{\text{prod}}(Y=1 \mid X=1) = 0.30 $$此时最诡异的事情发生了:在线上监控系统里,今天上涨的样本比例 \( P_{\text{prod}}(X) \) 可能和测试集分毫不差,所有的单特征直方图和均值方差监控全部呈现绿色正常状态。
但在底层,输入 \( X \) 到真实标签 \( Y \) 的映射规律已经彻底变了:
$$ P_{\text{test}}(X) = P_{\text{prod}}(X) \quad \text{但} \quad P_{\text{test}}(Y \mid X) \neq P_{\text{prod}}(Y \mid X) $$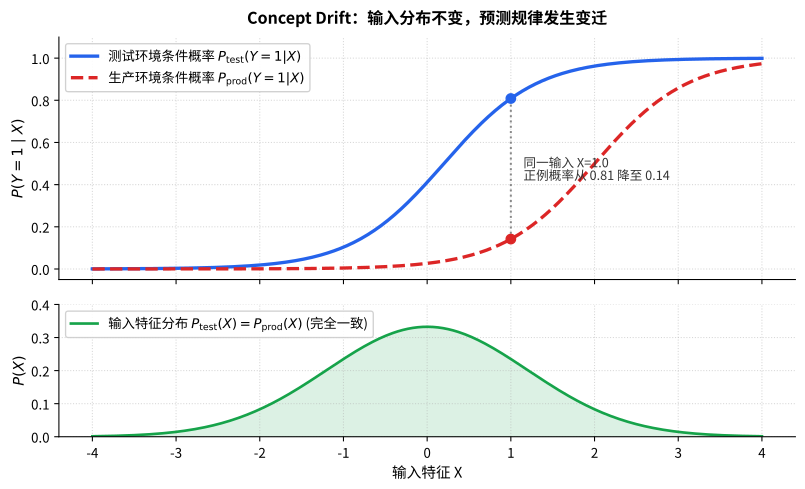
模型依然在按照旧环境下的权重把 \( X=1 \) 预测为正例,但在新环境下,这个输入产生正例的真实概率已经断崖式跌到了 0.3。
(需要说明的是,这里的股票涨跌只是一种为了剥离干扰、展示概率漂移的简化教学设定,现实金融市场绝不会存在如此简单的常数条件概率。)
一个疑问:Concept Drift 是否只是因为特征不充分?#
在反复琢磨 Concept Drift 的时候,我脑子里曾经冒出过一个疑问:
“我们之所以会观察到 \( P(Y|X) \) 发生变化,是不是纯粹因为我们给模型的特征不够充分?”
换句话说,世界底层的因果规律也许并没有变,真实的物理系统可能是由状态 \( (X, Z) \) 共同决定的:
$$ Y = f(X, Z) $$其中 \( X \) 是我们喂给模型的特征,而 \( Z \) 是一个隐藏的环境变量(例如宏观利率、平台交互界面的改版版本、季节气候等)。
如果环境变量 \( Z \) 发生了跃迁,那么从只看 \( X \) 的模型视角望过去,边缘概率 \( P(Y|X) \) 确实会像魔法一样发生漂移。
比如在电商平台场景中,用户的基础画像和浏览特征 \( X \) 没有任何改变,但平台悄悄改版了购物车结算界面的交互链路 \( Z \)。如果模型没有输入结算流程版本号,我们就会看到在用户特征完全相同的条件下,下单转化概率大幅波动,看起来就像发生了 Concept Drift。
这个疑问让我停下来想了很久。
从因果和系统还原的角度看,把未观测变量补充进特征集,确实能够将一部分"神秘的规律漂移"还原为显式的条件概率关系。
但关键的转折点在于:即使工程师意识到存在环境特征 \( Z \),并且在下一个版本把 \( Z \) 作为输入喂给了模型,我们依然无法确保模型能够正确预测未知的未来。
因为当全新的业务形态、未曾经历过的极端市场行情到来时,新的特征取值 \( Z_{\text{new}} \) 在历史训练集里根本没有任何样本支撑。
把环境变量补全,只是把“输入分布不变但关系漂移”的隐式困境,转化成了一个更加赤裸裸的几何困境:模型现在必须在它从未涉足过的特征空间区域进行预测。
这就直接撞上了深度学习中最为核心的难题——外推(Extrapolation)。
外推:为什么未知区域的预测不可靠?#
在深度学习的日常讨论中,“泛化”这个词经常被笼统地使用。但仔细拆解,模型的推广能力其实有两种完全不同的几何形态:插值(Interpolation)与外推(Extrapolation)。
插值与外推的几何直觉#
用一个最直白的一维函数拟合实验就能讲清两者的分野。
假设物理世界产生了一组离散的训练数据点:
$$ (1, 2), \; (2, 4), \; (3, 6), \; (4, 8), \; (5, 10) $$所有样本都落在区间 \( [1, 5] \) 内。模型在训练集上学到了一个简单的线性回归解:
$$ f(x) = 2x $$现在有两个预测任务:
- 给定 \( x = 2.5 \),要求模型输出预测值。
- 给定 \( x = 20 \),要求模型输出预测值。
对于 \( x = 2.5 \),它被已有的训练样本 \( x=2 \) 和 \( x=3 \) 紧紧包围在内部。模型在这个点上的预测被称为插值。由于紧邻的局部空间有充分的锚点约束,连续平滑的神经网络通常能够给出非常可信的内插输出(\( 2 \times 2.5 = 5.0 \))。
但对于 \( x = 20 \),它远远超出了历史采样区间 \( [1, 5] \) 的边界。在这个区域,模型没有任何历史样本作为支撑,这种预测被称为外推。
为什么外推在数学上无法提供确定性保证?#
在很多科普讨论中,解释外推失败的原因往往只有一句轻飘飘的“因为模型没见过”。但从函数拟合的本质来看,这背后的数学事实要严酷得多。
假设有两个完全不同的候选模型:
- 模型 A: $$ f_A(x) = 2x $$
- 模型 B: $$ f_B(x) = \begin{cases} 2x, & x \le 5 \\ 2x + (x-5)^2, & x \gt 5 \end{cases} $$
现在我们把它们放到训练集 \( x \in [1, 5] \) 上进行检验: 在所有训练点上,\( f_A(x) \) 和 \( f_B(x) \) 的输出完全一致,训练误差全部精确为零。
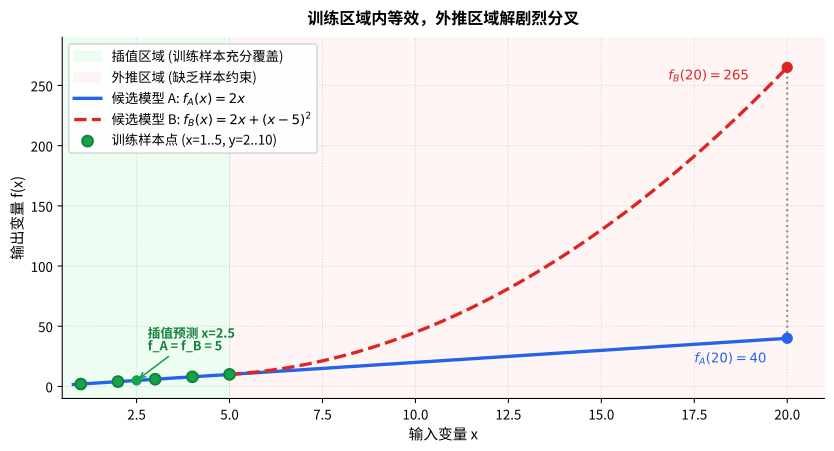
在训练数据覆盖的区间内,这两个模型是完全等价的。基于经验风险最小化(ERM)的训练算法,根本没有任何数学根据来判定哪一个模型更好。
然而一旦踏入外推区域,比如预测 \( x = 20 \):
$$ f_A(20) = 40 $$$$ f_B(20) = 40 + (20-5)^2 = 40 + 225 = 265 $$两个在训练集上表现完全相同的模型,在 \( x=20 \) 处的输出分歧达到了 6 倍以上。
这个极简案例揭示了外推的核心本质:有限的训练数据只能在它充分覆盖的局部几何区域内约束函数形态;在缺乏数据覆盖的未见区域,假设空间中存在无穷多个在训练集上表现完美、但在外推点走向截然相反的函数解。
神经网络的前向推理代码面对 \( x=20 \) 当然可以毫不犹豫地完成矩阵乘法并吐出一个浮点数,但这个输出数字的有效性,并没有得到训练数据的物理约束。
需要澄清的是:外推并不意味着一定会预测错误。如果真实世界的潜在物理定律碰巧是一条贯穿始终的严格直线,那么模型 A 在 \( x=20 \) 处的外推就会神奇地命中真实值。但这属于归纳偏置恰好契合真实世界规律的幸运巧合,而不是训练数据本身给出的可信度保证。
高维特征空间中的覆盖盲区#
在一维空间讨论外推,容易让人产生另一个根深蒂固的误解:
“外推是不是就意味着输入变量超过了训练集的最大值,或者低于最小值?”
很多做特征工程的同学喜欢给每个特征做数值范围检查(Range Check):如果历史特征 \( x_i \in [0, 1] \),只要线上新样本的 \( x_i \) 也在 \( [0, 1] \) 之间,就判定为“特征正常”。
但在高维空间中,这种基于一维边缘投影的直觉是完全失效的。
看一个二维特征空间的例子。
假设训练集中有两个特征 \( X_1 \) 和 \( X_2 \),两个特征的取值范围均在 \( [0, 1] \) 之间。而且在业务历史中,这两个特征具有高度的正相关性,所有样本点几乎全部挤在主对角线附近:
$$ (0.0, 0.0), \; (0.2, 0.2), \; (0.5, 0.5), \; (0.8, 0.8), \; (1.0, 1.0) $$现在线上流入了一个新样本:
$$ (X_1 = 0.9, \; X_2 = 0.1) $$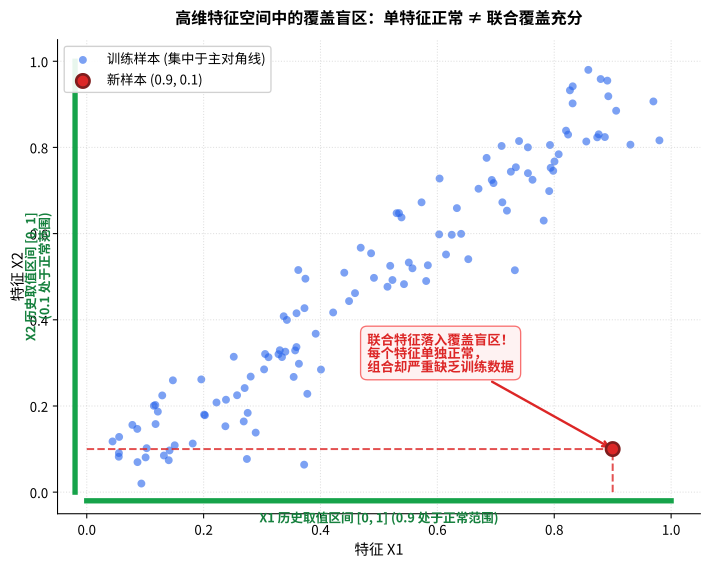
如果我们逐个特征检查:
- \( X_1 = 0.9 \),完全处于历史区间 \( [0, 1] \) 内,正常;
- \( X_2 = 0.1 \),完全处于历史区间 \( [0, 1] \) 内,正常。
单变量监控全部放行。然而只要把视线放回二维平面就会发现:这个点落在一个远离所有训练样本密集区的空白荒原上。
在实际的现代深度学习任务中,输入特征往往是几百维甚至成千上万维的向量(如图像像素、文本嵌入)。在高维空间中,这种“维数灾难”会变得极端恐怖:高维球体的体积绝大部分集中在外壳上,数据的分布极其稀疏。
这意味着:即便每一个单独维度的取值看起来都在历史经验范围之内,高维联合特征的特定组合也极有可能落入训练数据从未涉足的无人区。
单个特征不超限,绝对不代表联合数据覆盖充分。
Distribution Shift 与 Extrapolation 的边界#
理清这两个概念后,可以用更精准的心智模型对它们进行切分:
- Distribution Shift 讨论的是宏观层面上,数据生成概率密度的改变(\( P_{\text{train}} \to P_{\text{prod}} \) 的变动)。
- Extrapolation 讨论的是微观几何层面上,具体预测点相对于训练数据实际覆盖流形(Support)的距离与包含关系。
它们两者并不是非此即彼的对立关系:
- 我们可以面临 Distribution Shift 但不需要显著外推:例如前面的白天/夜间猫狗分类,训练集里其实已经充分包含了夜间样本,分布改变只是把权重往夜间倾斜,模型在局部依然是在已有经验的区域工作。
- 我们也可以在整体宏观分布没有发生全局漂移的前提下,因为长尾罕见事件的发生,迫使模型在局部执行外推预测。
当模型不知道答案时,为什么还会非常自信?#
外推为我们指出了模型可能面临的几何荒原。紧接着在 MIT 6.S191 Lecture 6 中,课程抛出了一个非常震撼、同时也非常切中工程痛点的问题:
How do we know when our network doesn’t know? (我们如何知道模型什么时候其实不知道答案?)
直觉上,工程师往往会寄希望于模型输出的概率值:如果遇到没见过的输入或者外推样本,模型输出一个接近均匀分布的概率(比如二分类给出 0.51 vs 0.49),那至少系统可以借由低置信度将该样本拦截、打回人工审核。
但现实却残酷得多:当模型面对完全陌生的输入时,它不仅可能预测错误,而且往往会给出极度自信的高概率。
闭集分类器的结构性假象#
看一个直观的反直觉案例。
我们训练了一个图像分类卷积网络,任务非常简单:区分猫和狗。网络的输出层由两个神经元组成,经过 Softmax 激活函数输出两个类别的概率值。训练完成后,猫狗分类的测试集准确率高达 99%。
现在,我们把一张从未在训练集中出现过的全新物种图片(比如一只澳大利亚的鸭嘴兽,或者一张纯随机的高斯噪声图片)送入模型。
由于模型内部的输出节点只有两个,前向计算在未校准的线性层末端算出了两组未经约束的得分(Logits),比如:
$$ z_{\text{cat}} = 8.5, \quad z_{\text{dog}} = 3.9 $$紧接着,Softmax 函数执行了它的标准运算:
$$ P(\text{cat}) = \frac{e^{8.5}}{e^{8.5} + e^{3.9}} \approx 0.989 \approx 0.99 $$$$ P(\text{dog}) = \frac{e^{3.9}}{e^{8.5} + e^{3.9}} \approx 0.011 \approx 0.01 $$屏幕上赫然显示:模型以 99% 的置信度判定该图片是一只猫。
为什么会出现盲目自信?#
这个现象初看极其荒谬,但在数学和架构上却完全合乎逻辑。
普通的分类模型建立在**闭集假设(Closed-set Assumption)**之上:网络在设计之初就默认输入世界非黑即白,所有可能的样本都必然属于预先定义好的 \( K \) 个互斥类别之一。
Softmax 的数学本质是一个强制归一化操作:
$$ \text{Softmax}(z)_i = \frac{e^{z_i}}{\sum_{j=1}^K e^{z_j}} $$它不管输入的物理语义到底是什么,只负责把传入的相对差值通过指数放大并压缩到和为 1 的单位超平面上。哪怕两个 Logits 都来自于输入特征在错误分类超平面上的剧烈投影,只要某一个类别的原始数值稍微占优,经过指数放大后就会被包装成看似确凿无疑的 99% 概率。
因此必须把一个概念彻底厘清:Softmax 输出的数值只是模型在预设候选集内的内部归一化得分,它绝不自动等价于经过校准的真实物理置信度。
(当然,并非所有未知输入都会碰巧输出 0.99 的极端值;但高置信度的错误预测在神经网络中是普遍且系统性存在的,单独依赖 Softmax 分数绝对无法作为评估样本可靠性的充要凭证。)
外推与不确定性的交织#
把这两章的内容串起来,就看到了一个令工程师深感不安的完整链条:
- 外推现象告诉我们:在训练样本缺乏覆盖的盲区,模型的预测输出完全脱离了数据的有效约束;
- 不确定性(Uncertainty)困境进一步揭示:哪怕模型已经深陷外推荒原,它自身缺乏任何内置的感知机制来表达“这个区域我从未见过”。
它依然会输出一个确定性的预测,并且用极高的输出概率给系统制造一种一切安好的虚假安全感。
在学术界和高可靠工业场景(如自动驾驶、医疗诊断)中,研究者们会投入大量精力去探索不确定性估计与分布外检测(OOD Detection)——比如利用贝叶斯神经网络(Bayesian Neural Networks)建模权重分布、通过蒙特卡洛 Dropout(MC Dropout)在推理时多轮采样评估方差、使用深度集成(Deep Ensembles)通过多模型分歧度感知未知输入,或者引入概率校准(Calibration)算法。
但在通用场景中,绝大多数在生产线上奔跑的模型,依然只具备最朴素的确定性输出结构。
来自真实 ML Infra 的工程呼应#
结合我自己在 ML Infra 领域的实际工作经历,这种统计学上的分布偏移与外推困境,在工程底座上有着非常直观的物理投射。
作为负责模型训练平台、推理加速引擎和自动化上线部署的工程师,我最初的工作焦点大多停留在纯系统指标上:P99 延迟有没有超过 10ms、GPU 显存有没有暴涨、推理吞吐有没有打满、模型权重热加载有没有丢请求。
在系统层面,一切都可以运转得极其完美。但系统运维的健康,并不能代表模型预测力的健康。
在量化金融或者高频预测的业务场景中,我们曾在线上推行过一套模型实际预测力的监控方案。其中一个最为核心的度量工具,就是 IC 监控(Information Coefficient,信息系数):
$$ \text{IC} = \text{Corr}(\text{Prediction}, \; \text{Ground Truth Label}) $$也就是持续计算模型在某一时段内输出的预测值,与事后真实产生的实际标签之间的相关系数。
这个工程经验让我对前文讲到的理论形成了三层极为清晰的递进认知:
第一层:输入特征分布监控#
我们在特征管道和推理网关处,对流入的特征 \( X \) 实施统计度量:监控各维度的均值、方差、缺失率、分位数漂移(如 PSI 检验)。
这一层的目标是捕获最显式的 Covariate Shift。如果某项基础特征在生产环境中突然超出历史极值,监控系统能够快速拉响警报。
但它的局限就在于第三章讨论过的覆盖空洞:所有单一特征的边缘分布全部绿灯,根本无法证明由它们联合构成的高维样本没有落入外推荒原。
第二层:模型输出分布监控#
在推理引擎的出口,我们监控模型输出的 Logits 或者预测分数的分布形态:分位数、熵值、均值。
如果模型突然把大量样本预测为某一个单向极端值,输出分布监控能够捕捉到异常。
但它的局限在于第四章剖析过的闭集盲目自信:即便面对完全失真的未知输入,Softmax 也可能交出形态极其正常、峰值依然饱满的高概率分布。
第三层:实际预测力监控#
真正能够宣告模型是否依然存活的,只有第三层:当真实的生产环境反馈(真实标签 \( Y \))经过一定延迟到达系统后,将其与当时的预测进行配对,计算真实的 IC 相关系数。
在真实的监控大盘上,我曾多次亲眼目睹过这样一种场景:
- 推理服务毫无报错,QPS 稳定,延迟极低;
- 输入特征的边缘分布统计图与离线训练集完美契合;
- 模型输出的分数直方图与测试集无缝重叠;
- 但计算出来的 IC 曲线,却直接从 +0.15 跌穿零轴,滑落到负值。
前两层监控完全失灵,因为发生的是最纯粹的底层关系演化(Concept Drift)或者不可见的流形外推。
需要严谨说明的是:IC 本质上衡量的是排序与统计相关性,IC 值的下滑可以由多种市场微观结构变化引发,并不纯粹等同于标准的 Concept Drift;反过来,IC 短期稳定也不代表模型完全免疫于长尾样本的外推风险。
但这套工程实践给我的最大启发在于:一个在软硬件层面稳定运行的模型,和一个在统计泛化层面有效预测的模型,完全是两个不同维度的概念。
离线测试集给了我们前者上线跑通的入场券,但只有生产环境源源不断到达的真实世界反馈,才能检验后者是否依然活着。
写在最后#
回到最初的那个反直觉问题:
训练集 99%,测试集 98%,究竟证明了什么?
站在理解了分布偏移、外推与不确定性的当下,我们可以用三个层次来收拢这个认知:
第一层,测试集衡量的是模型在特定历史抽样分布下的局部泛化能力。 随机切分的测试集能够有效检验模型是否死记硬背了训练样本,但它所验证的只是内嵌在 \( P_{\text{history}} \) 框架之内的泛化。它从数学上无法自动抵御现实世界不可避免的分布演化。
第二层,输入分布的静态稳定,无法保证预测规律的恒常不变。 哪怕特征在直方图上完全重现历史形态,给定特征后真实标签的条件概率 \( P(Y|X) \) 依然可能因为环境的重构而发生漂移。模型学到的大多是特定历史时空下的统计关联,而非不可撼动的底层物理定律。
第三层,神经网络强大的参数拟合容量,并不等价于可靠的外推能力。 在训练数据覆盖的几何流形之外,存在着无穷多在训练集上等价、但在未知点剧烈分叉的解。更严峻的是,模型缺乏表达自我认知的机制,在面对未知时依然倾向于输出虚妄的高确定性。
测试集能够精确告诉我们,模型在过去被观测到的世界里曾经表现得多么出色;
但它永远无法替未来的世界开出一张无条件的兑现支票。
参考资料#
- MIT 6.S191: Introduction to Deep Learning (Lecture 6: New Frontiers) — http://introtodeeplearning.com/
- Zhang, C., Bengio, S., Hardt, M., Recht, B., & Vinyals, O. Understanding Deep Learning Requires Rethinking Generalization, ICLR 2017 — https://arxiv.org/abs/1611.03530
- Quinonero-Candela, J., Sugiyama, M., Schwaighofer, A., & Lawrence, N. D. Dataset Shift in Machine Learning, The MIT Press, 2009
- Hendrycks, D., & Gimpel, K. A Baseline for Detecting Misclassified and Out-of-Distribution Examples in Neural Networks, ICLR 2017 — https://arxiv.org/abs/1610.02136