
起因#
看 6.S191 的课程内容时,讲到 generalization 相关的话题,提到了一篇 2017 年的论文。
说实话,我以前对"泛化"这件事没有太深入地想过。教科书上的经典说法——模型越复杂越容易过拟合,要用正则化控制复杂度——我一直就这么接受下来了。L1、L2、Dropout 这些方法背后的直觉也说得通:限制模型的有效复杂度,不让它过度拟合训练数据中的噪声。没觉得有什么问题。
但 6.S191 提到的这个实验结果,让我意识到这套传统说法可能不够用。
2017 年之前的主流理解#
在说那个实验之前,先整理一下 2017 年之前关于泛化的主流直觉,后面才好说清楚它哪里不够用。
几个概念用一句话过一下:
- Model Capacity(模型容量):模型能表示多复杂的函数。一个线性模型只能表示直线,一个深层神经网络能表示极其复杂的非线性映射。
- Memorization(记忆):模型把训练样本的具体细节——包括噪声——逐个记住,而不是从中提取可推广的规律。
- Generalization(泛化):模型在未见过的新数据上表现好不好。
传统统计学习理论的一个核心思路可以概括成一个跷跷板:模型的记忆能力和泛化能力,此消彼长。 模型容量小,记忆能力弱,可能欠拟合,但不太容易把噪声当规律。模型容量大,记忆能力强,可以拟合复杂关系,但也更容易把没有规律的噪声硬记下来。
经典机器学习课本上画过一张图,大意是这样的:
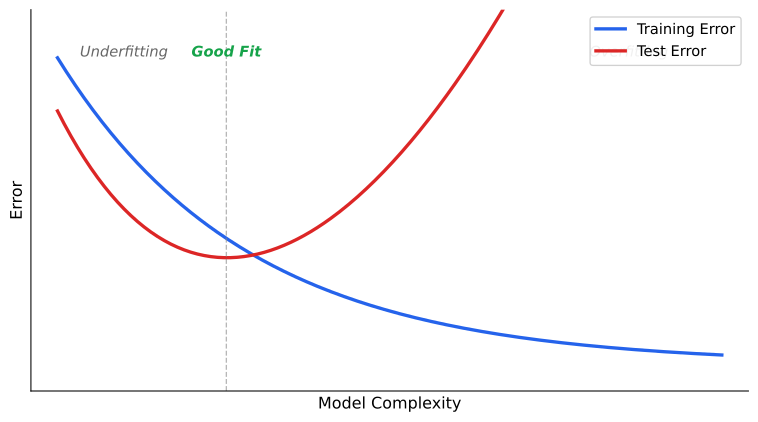
横轴是模型复杂度,纵轴是误差。Training Error 随着复杂度增加一路下降——模型越复杂,拟合训练集越容易。Test Error 先降后升,形成一个 U 型——存在一个最优复杂度,过了之后就开始过拟合。
这张图背后隐含的 Bias-Variance Tradeoff 说的是:太简单的模型有很大的 bias(系统性偏差),太复杂的模型有很大的 variance(对训练数据波动敏感),两者之间有一个平衡点。
需要说明:这张图是一种经典示意,不是所有现代深度网络的训练过程都严格遵循这个形状。 后面会看到,现代神经网络的行为和这张图的预测之间存在明显偏差。
这套框架在很长时间里都是理解泛化的主流直觉:模型容量越大,记忆能力越强,过拟合的风险就越大。限制模型复杂度——无论是显式正则化还是早停——是保障泛化能力的基本手段。我以前也一直这么理解,没觉得有什么需要质疑的地方。
2017 年的随机标签实验#
2017 年 ICLR 有一篇论文:Understanding Deep Learning Requires Rethinking Generalization(Zhang, Bengio, Hardt, Recht, Vinyals)。
研究者想验证一个非常基础的问题:现代神经网络到底有没有能力记住完全随机的训练标签?
他们用的数据集是 CIFAR-10:50,000 张训练图片,10,000 张测试图片,共 10 个分类类别(飞机、汽车、鸟、猫、鹿、狗、蛙、马、船、卡车)。
实验设计很直接。两组对照:
实验 A:真实标签。 用原始 CIFAR-10 的真实标签训练 Inception 网络。
实验 B:随机标签。 保持图像不变,保持网络架构和训练设置不变,但在训练开始之前,把每张训练图片的标签随机替换成 10 个类别中的一个。
这里有两个容易搞混的地方,先澄清。
第一,随机标签是在训练开始前一次性指定的,之后保持固定。不是每个 epoch 重新随机一遍。所以网络面对的是一组确定的、但图像和标签之间完全没有可泛化规律的训练数据。
第二,实验 A 和实验 B 用的是同一种网络架构,但分别进行了独立的训练。不是说在随机标签上训练好的模型拿去测真实数据还能得到 85% 的准确率——那完全是另一回事。
论文 Table 1 报告了 Inception 在 CIFAR-10 上、无数据增强(no random crop)、无 weight decay 的结果:
| 数据 | Train Accuracy | Test Accuracy |
|---|---|---|
| True Labels | 100.0% | 85.75% |
| Random Labels | 100.0% | 9.78% |
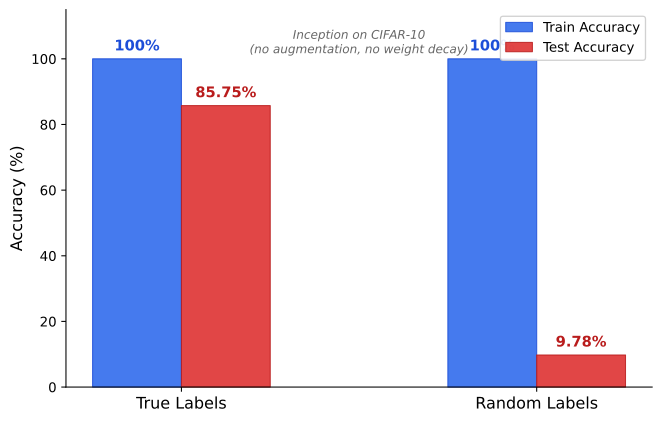
逐个看这几个数字。
真实标签,Train 100%。 网络完全拟合了训练集。50,000 张图片,每一张都分对了。
真实标签,Test 85.75%。 在从未见过的 10,000 张测试图片上达到了 85.75% 的准确率。说明网络不仅记住了训练数据,还学到了某些可以推广到新图片上的分类规律。
随机标签,Train 100%。 这是让我卡住的数字。每张图片的标签是随机分配的——一张猫的图片可能被标注为飞机,一张汽车可能被标注为蛙。图像和标签之间完全没有系统性的对应关系。但网络仍然能把 50,000 个这样的随机对应关系全部记住,训练准确率达到 100%。
随机标签,Test 9.78%。 接近 10 个类别的随机猜测水平(\(1/10 = 10\%\))。这很合理:随机标签不包含任何可泛化的规律,网络学到的只是 50,000 个"输入 → 输出"的硬编码映射,在新的测试图片上完全不起作用。
我第一次看到这组数据时的反应是:能完整记住 50,000 个随机标签,这不恰恰说明这个模型过拟合到了极致吗?按照传统的跷跷板直觉,这应该是一个完美的例证——超大容量 → 死记硬背 → 泛化崩溃。
但问题在第二行:同一种网络架构在真实标签上,泛化表现并不差。
逐渐增加随机标签比例#
论文不只做了 0%(全部真实标签)和 100%(全部随机标签)两个极端。他们还做了中间状态:独立地以概率 \(p\) 将每张图片的标签替换为随机类别,\(p\) 从 0 到 1 连续变化。
论文 Figure 1 展示了几个关键发现:
所有随机化比例下,网络都能拟合训练集。 无论 \(p\) 是 0.2、0.5 还是 1.0,训练准确率最终都能达到 100%(或接近 100%)。
随机标签比例越高,训练收敛越慢。 这和直觉吻合:完全随机的标签需要网络学习更多毫无规律可言的对应关系,需要更多训练步数才能记住。
随机标签比例越高,测试表现越差。 测试误差随着 \(p\) 从 0 到 1 平滑地增长,在 \(p=1\) 时收敛到 90%——也就是 CIFAR-10 的随机猜测水平。
训练误差始终为零,但泛化误差可以从很低到最大值连续变化。
这组实验的含义是:当数据中同时包含真实规律和人工噪声时,网络可以同时做到两件事——从真实部分中提取可泛化的规律,同时用记忆的方式硬拟合噪声部分。
论文还做了一组更极端的实验:不仅替换标签,连输入图像本身也替换成随机像素。结果是,网络仍然能拟合。这说明自然图像的语义结构不是网络能记住随机标签的必要条件——即使输入完全没有空间结构,网络也有能力建立从输入到任意输出的映射。
能记住,为什么还能泛化#
到这里我卡住了一阵。
按照传统的跷跷板框架,一个能完整记住 50,000 个随机标签的模型,记忆能力已经强到了极致。它应该是过拟合最严重的那种模型。
但实验 A 告诉我:同一种网络架构,在真实标签上训练时,泛化表现完全正常。
我当时的困惑是:这两件事怎么能同时成立?一个模型如果有能力把随机噪声完整记下来,它面对真实数据的时候,难道不应该也倾向于死记硬背而不是学规律吗?
后来我意识到,困惑来自于我把两个不同的概念混在了一起。
Capacity 不等于 Learned Function#
传统框架下的推理方式是:模型容量大 → 能记住随机标签 → 过拟合风险高 → 泛化差。
但这个推理链在第三步断了。“能记住随机标签"描述的是模型的 capacity——它能够表示的函数集合有多大。这个集合足够大,大到包含了"把 50,000 个随机输入-输出对死记硬背"这样的函数。
但 capacity 只是说明了可能性。模型最终学到的是哪个函数,还取决于另外三个因素:训练数据、网络架构和优化过程。
换一种说法。假设模型的假设空间(hypothesis space)里有很多个函数都能完美拟合训练集。其中有些函数只是把训练数据死记硬背了,在新数据上表现很差;另一些函数则捕捉了数据中的真实规律,在新数据上也能表现不错。
模型有能力记住随机数据,不代表它面对真实数据时只能选择死记硬背。
这张图帮我理清了三个层次:
- Capacity:模型能表示什么函数。假设空间有多大。
- Learned Function:训练实际得到了什么函数。这受训练数据的分布、网络架构的归纳偏置、优化算法的行为共同影响。
- Generalization:学到的这个函数在新数据上表现如何。
随机标签实验最关键的发现不是"神经网络能记住东西”——这件事本身可能并不让人意外。关键在于:同一种架构的模型,给它随机数据它就记住随机数据,给它有规律的数据它就能学到规律。训练数据的结构改变了训练结果,而不仅仅是模型容量决定了一切。
三个需要区分开的事实#
想通上面那件事之后,我发现传统的跷跷板框架其实隐含地等同了几个不同的东西。拆开来看:
模型能拟合复杂函数(高 capacity),不代表训练后一定无法泛化。 Inception 有能力记住随机标签,但在真实标签上训练时,它学到了一个泛化得不错的函数。capacity 决定了上限,但没有决定实际去到哪里。
记住随机标签的能力和在真实数据上泛化,可以同时成立。 这不是零和关系。同一种架构具备记忆能力,同时也具备泛化能力。关键在于数据和训练过程引导它走向了哪种解。
训练误差不能用来判断模型学到了什么。 真实标签和随机标签都可以达到 100% 的训练准确率,但测试表现可以相差 70 多个百分点。零训练误差不等于学到了真实规律。
这不意味着什么#
在继续之前,有几个容易滑向的过度结论需要挡住。
随机标签实验不是在说:记忆能力越强,泛化能力就越好。它也不是在说大模型总能泛化,或者容量和泛化完全无关。
实验说明的是一个更精确的命题:仅凭模型容量或者模型是否有能力记住训练数据,无法充分解释现代深度神经网络的泛化行为。
容量是泛化的必要条件之一(模型至少要有能力表示那个泛化好的函数),但它远远不是充分条件。
那正则化是不是白做了#
想到这里我很自然地联想到一个问题:如果记忆能力强不一定导致泛化差,那 L1、L2 正则化和 Dropout 限制模型复杂度的思路还成立吗?
回到论文的 Table 1。Inception 在 CIFAR-10 上的真实标签测试准确率:
| Random Crop | Weight Decay | Test Accuracy |
|---|---|---|
| Yes | Yes | 89.05% |
| Yes | No | 89.31% |
| No | Yes | 86.03% |
| No | No | 85.75% |
即使把 data augmentation 和 weight decay 全部去掉,测试准确率仍然有 85.75%。加上这些正则化手段后提升到 89.05%——差距大概 3 个百分点。
论文的结论是:显式正则化可以提升泛化表现,但它不是良好泛化的必要条件。 即使没有任何显式正则化,网络在真实数据上的泛化表现依然相当好。
这里有一个需要严格区分的地方。论文检验的"显式正则化"(explicit regularization)包括 weight decay、dropout 和 data augmentation。但训练过程中可能存在"隐式正则化"(implicit regularization)——比如 SGD 本身对解的偏好、batch normalization 的效应、网络架构的结构约束。论文去掉了显式正则化,但没有去掉所有可能的隐式正则化。
所以结论不是"正则化没用"。正则化作为工程手段完全合理——它确实能提升泛化表现。但它不是解释神经网络为什么能泛化的充分答案。不是因为我们加了 weight decay,神经网络才能泛化;即使不加,它也能泛化。 这意味着还有其他因素在起作用。
真正有趣的问题#
那这些"其他因素"是什么?
既然一个神经网络有能力拟合任意标签——给它随机标签它能记住,给它真实标签它能泛化——那当训练数据存在真实规律时,是什么引导训练过程走向了一个能够泛化的函数,而不是另一个只会死记硬背的函数?
有两个方向一直在被研究。
归纳偏置(Inductive Bias)。 不同的网络架构对不同类型的函数有先天的偏好。CNN 的卷积核只看局部区域、多个位置共享同一组权重——这些设计使得它天然偏好具有局部性和平移不变性的函数,而图像数据恰好具有这类结构。CNN 并不是对所有能拟合训练集的函数一视同仁,它的结构让某些函数比其他函数更容易被学到。
隐式正则化(Implicit Regularization)。 即使不显式加正则项,优化算法本身也可能对解产生偏好。以最简单的线性回归为例:如果存在无穷多组权重都能让训练误差为零,SGD 从零初始化开始迭代,最终会收敛到范数最小的那个解。范数最小的解在很多情况下恰好泛化得更好。对于深层非线性网络,情况远比线性模型复杂,但直觉上类似——优化过程不是在所有能拟合训练集的函数中随机挑一个,而是有偏好地走向某些解。
2017 年这篇论文主要是提出了挑战:传统的泛化理论(基于模型容量的上界,如 VC dimension、Rademacher complexity)无法区分在真实标签上泛化好的网络和在随机标签上泛化差的网络——因为两者的模型容量完全相同。
论文没有给出"为什么神经网络能泛化"的完整答案。这个问题到今天仍然是深度学习理论中最核心的开放问题之一。
写在最后#
回到最初的问题。
2017 年之前的主流理解是:模型有能力记住训练数据 → 它就容易过拟合 → 所以要限制模型容量。我以前也没仔细想过这套说法有什么问题。
随机标签实验让我意识到这条推理链缺了关键的一环。一个模型有能力记住所有数据,不代表它在面对真实数据时会选择死记硬背。具备记忆能力和实际上通过记忆完成预测,是两件不同的事情。
真正有趣的问题不再是"模型有没有能力记住训练数据"——答案是有,而且远比我们以为的容易。
问题变成了:在所有能够拟合训练数据的函数中,训练过程为什么会得到一个能够泛化的函数?
参考资料#
- Chiyuan Zhang, Samy Bengio, Moritz Hardt, Benjamin Recht, Oriol Vinyals, Understanding Deep Learning Requires Rethinking Generalization, ICLR 2017 — https://arxiv.org/abs/1611.03530