起因#
最近开始看 MIT 6.S191 的 Lecture 5——Deep Reinforcement Learning。
过去几个月写了不少笔记,从 RNN 到 Transformer,从 VAE 到 GAN,基本都属于 supervised 或 self-supervised 的范畴。之前梳理训练信号来源的那篇,整理了四种学习范式——supervised、unsupervised、semi-supervised、self-supervised——的核心区别在于训练信号是谁提供的。
那篇的最后,我的结论是:模型训练时,究竟从哪里得到"应该往哪个方向优化"的信号? 这个问题比"有没有 label"更有解释力。
进入强化学习之后,我碰到了一个更麻烦的情况。
Supervised learning 的训练信号来自外部标注的 target。Self-supervised learning 虽然没有人工标注,但能从数据自身构造出 target。它们的训练循环都是:有 input,有 target(不管来源),有 loss,有 gradient,有 update。
但强化学习的场景里,根本没有人告诉模型"在当前状态下,正确的动作是什么"。
那它到底怎么训练?
这个问题困扰了我一段时间。这篇是我试图把它想通的记录。
预测不等于决策#
先从一个我比较熟悉的场景说起。
假设有一个金融预测模型。输入是当前的市场特征 \(x_t\),输出是对未来收益率的预测 \(\hat{r}_{t+1}\):
$$ x_t \xrightarrow{f_\theta} \hat{r}_{t+1} $$如果未来收益率的真实值 \(r_{t+1}\) 在训练时可以拿到(比如用历史数据回测),这就是一个标准的 supervised learning 任务。有 input,有 target,有 loss,能训练。
但真实的交易系统远不止预测收益率。
它还需要回答:要不要买?买多少?当前已经持有多少仓位?交易成本是多少?如果现在买入,之后的风险暴露会怎么变?之前整理量化交易系统的那篇拆过这个问题——预测模型只是整个系统的一个环节,从 Alpha 到执行之间还有风险模型、成本模型和组合构建。
也就是说,能预测明天涨跌,不等于能自动做出完整的交易决策。
换一个更直观的例子。
假设你在玩一个网格寻路游戏。Agent 在一个 5×5 的网格里,需要从起点走到终点。每一步可以选择上、下、左、右。地图上有陷阱,踩到就扣分;有障碍物,不能穿过。
如果这是一个分类问题,每个格子都有一个标准答案:“在这个位置应该向右走”。模型看标签学就行了。
但在实际的寻路过程中,没有人给每一步贴标签。而且,当前走哪一步不是孤立的——向右走一步之后,你所处的位置变了,后续能走的路也全变了。一个动作的好坏,取决于它带来的后续局面。
预测(Prediction)是一次性的判断:输入一组特征,给出一个预测值。决策(Decision)是连续的选择:当前动作会改变未来局面,进而影响后续所有决策。
有些问题只需要学会预测就够了。有些问题需要学习一整套连续的行动策略。强化学习处理的是后者。
一个网格世界#
为了让后面的概念有一个具体的载体,我先定义一个非常简单的例子,后续所有讨论都围绕它展开。
5×5 的网格世界:
- S(左下角):Agent 的起点。
- G(右上角):终点,到达后获得 +10 奖励。
- X(中间):陷阱,踩入扣 -10 奖励。
- ##:障碍物,不可进入。
- 每移动一步,扣 -1(鼓励尽快到达终点)。
- 动作空间:上、下、左、右。碰到边界或障碍物则停留原地(仍然扣 -1)。
- Agent 到达 G 或踩入 X 后本轮结束。
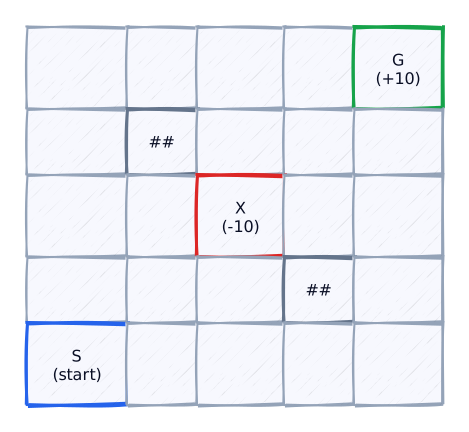
这个环境很小,但已经足够展示后面要讨论的所有核心概念。
Agent 和 Environment 的反馈循环#
有了具体的环境,可以正式说说 Reinforcement Learning(强化学习)到底在做什么了。
一句话:强化学习研究的是,一个智能体如何通过与环境不断交互,学习到能够最大化长期累计奖励的决策策略。
这个定义里的几个关键角色:
- Agent(智能体):做出决策的主体。在网格世界里就是那个走格子的家伙。
- Environment(环境):Agent 存在并与之交互的外部世界。在网格世界里就是整个地图——包括格子布局、陷阱位置、奖励规则。
- State(状态),记作 \(s_t\):某一时刻环境的完整描述。在网格世界里就是 Agent 当前所在的格子坐标。
- Action(动作),记作 \(a_t\):Agent 在当前状态下选择的行为。上、下、左、右中的一个。
- Reward(奖励),记作 \(r_{t+1}\):Agent 执行动作 \(a_t\) 之后,环境返回的一个标量反馈。
交互的时序是这样的:
- Agent 观察当前状态 \(s_t\)。
- Agent 根据某种策略选择动作 \(a_t\)。
- Environment 响应这个动作,产生下一个状态 \(s_{t+1}\)。
- Agent 收到奖励 \(r_{t+1}\)。
- 进入下一轮:Agent 观察 \(s_{t+1}\),选择 \(a_{t+1}\),如此循环。
整篇文章统一一个记号约定:执行 \(a_t\) 后收到的奖励写作 \(r_{t+1}\),下标比动作多 1。不同教材有不同写法,这里选这种是因为它更清楚地表达了"奖励是动作的结果"这一因果关系。
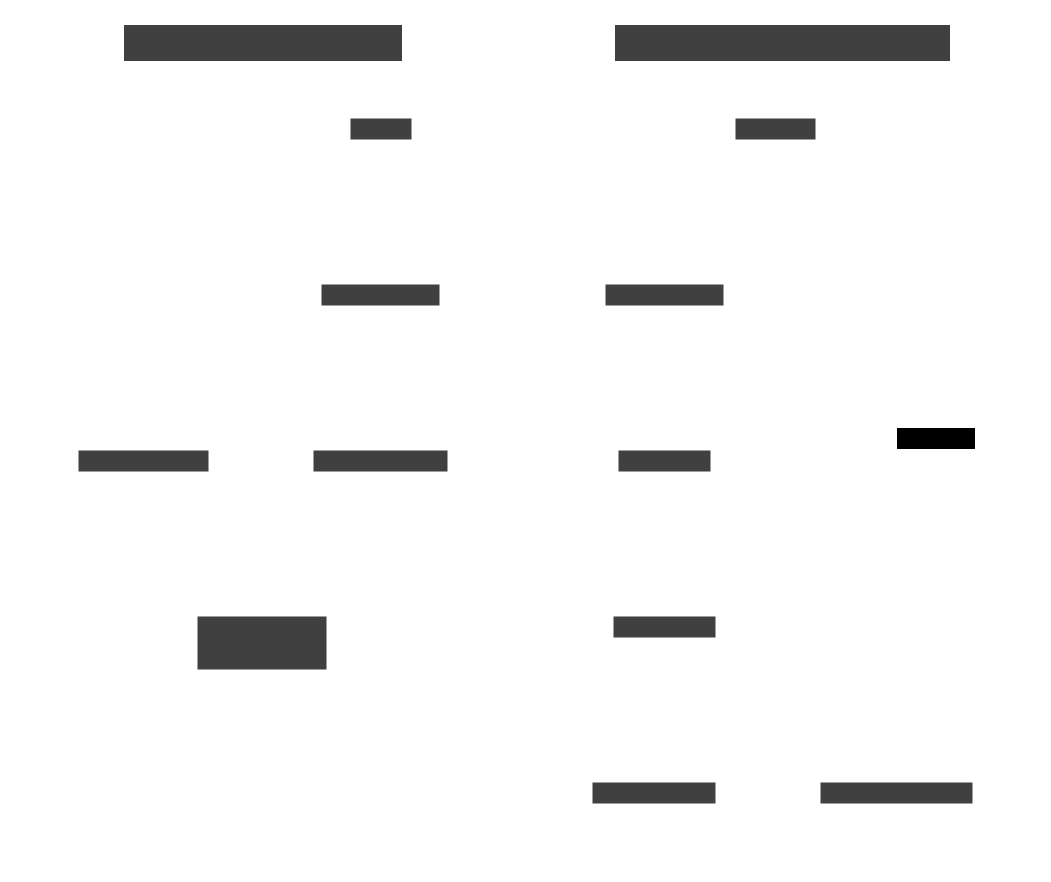
对比上图:监督学习的链路是 input → model → prediction → loss(与外部 label 比较) → gradient → update。强化学习的链路是一个循环——Agent 行动,环境反馈,Agent 再行动。没有一个外部提供的"正确答案"在旁边等着做比较。
需要补充一点:State 和 Observation(观测)严格来说不总是相同的。在很多实际问题中,Agent 看到的只是环境的部分信息,不是完整状态。这篇为了教学方便,先假设 Agent 能拿到足够描述当前局面的完整状态信息。
Reward 不是 Label#
到这里可能会有一个疑问:Reward 虽然不是人工标注的 label,但它确实是一个来自环境的信号,告诉 Agent 做得好不好。那 Reward 算不算某种 label?
我一开始也觉得 Reward 和 Label 有点像。后来发现差别很大。
在 supervised learning 里,Label 直接告诉模型"正确答案是什么"。
一张图片 → Label 是"猫"。
模型输出"狗"→ Loss 很大 → 调整参数让输出更接近"猫"。
每个样本都有一个明确的目标。模型只需要让自己的输出逼近这个目标就行。
但在强化学习的网格世界里:
Agent 在某个格子,选择向右走,移动到了新的位置,收到奖励 -1。
这个 -1 告诉 Agent 什么了?它说的是:你移动了一步,付出了一步的代价。
它没有说“在这个位置,正确的动作是向右”。也没有说"向右走比向左走好"。更没有说"你接下来应该怎么走"。
Reward 评价的是结果,不直接指示最优动作。
更麻烦的是 Delayed Reward(延迟奖励)。
回到网格世界。假设 Agent 走了 7 步,最终成功到达终点拿到 +10。前 6 步每步都是 -1,最后一步才拿到大的正奖励。
那么,前面哪一步贡献了最终的成功?
第 1 步选择绕开陷阱、第 3 步选择避开障碍物——这些动作在当时只收到了 -1 的奖励,看起来并不突出。但如果没有这些"看起来不怎么样"的动作,Agent 根本到不了终点。
这就是 Credit Assignment(功劳分配)问题:当最终结果好或坏的时候,究竟应该把功劳或责任归给前面的哪些动作?
Reward 不像 Label 那样给每个样本一个明确的优化目标。它可能在很多步之后才出现,而且不告诉你是前面哪个动作导致了这个结果。
当然,这不是说 RL 的 Reward 总是延迟的或者总是稀疏的。有些环境每一步都给 Reward(比如我们的网格世界每步 -1),有些只在终局给。但即使每步都有 Reward,单步 Reward 仍然不等于"当前动作的正确答案"——因为一个动作的真正价值取决于它引发的后续所有结果,而不只是当前收到的那一个数字。
不能只看眼前的 Reward#
上一节说到,一个动作好不好不能只看当前 Reward。那应该怎么评价?
用网格世界的例子对比两条路径:
路径 A:Agent 走最短路径直奔终点方向,4 步后踩到了陷阱。
| Step | Reward |
|---|---|
| 1 | -1 |
| 2 | -1 |
| 3 | -1 |
| 4 | -10(陷阱) |
| 总计 | -13 |
路径 B:Agent 绕路避开陷阱和障碍物,7 步后到达终点。
| Step | Reward |
|---|---|
| 1~6 | -1 each |
| 7 | +10(终点) |
| 总计 | +4 |
路径 A 前几步的 Reward 和路径 B 一样,都是 -1。如果 Agent 只看眼前的 Reward,这两条路看不出区别——甚至路径 A 因为步数少,早期的累计惩罚更小。
但路径 A 的结局是 -10,总回报 -13。路径 B 虽然多走了几步,总回报却是 +4。
一个动作的价值不能只看它立即产生的 Reward,还要看它引发的整条未来轨迹。
由此引出 Return(回报)。最简单的定义:把一条轨迹上所有 Reward 加起来。
但在更一般的情况下,RL 通常使用折扣累计回报(Discounted Return):
$$ G_t = r_{t+1} + \gamma \, r_{t+2} + \gamma^2 \, r_{t+3} + \cdots = \sum_{k=0}^{\infty} \gamma^k \, r_{t+k+1} $$其中:
- \(G_t\) 是从时刻 \(t\) 开始的累计回报。
- \(r_{t+k+1}\) 是未来第 \(k\) 步收到的 Reward。
- \(\gamma \in [0, 1)\) 是 Discount Factor(折扣因子),控制未来 Reward 相对于当前的权重。
如果 \(\gamma = 1\)(且轨迹长度有限),就退化成简单的总和。\(\gamma\) 越小,Agent 越"短视";\(\gamma\) 越接近 1,Agent 越重视远期奖励。
还有一点容易被忽略:实际 RL 优化的是 Expected Return(期望累计回报),而不是某一次轨迹上恰好得到的回报。因为环境可能有随机性,策略也可能是随机的,同一个起点出发可能产生不同的轨迹。一次走出 +4 的轨迹不代表策略一定好,一次走出 -13 也不代表策略一定差——重要的是期望值。
这一点在后面金融类比中也很重要:一笔交易赚了钱,不等于这个交易决策的期望价值为正。
Discount Factor 和金融里的折现有什么关系#
看到 Discount Factor 的公式时,我脑子里第一个反应是:
这不就是金融里现金流折现的思路吗?
金融里的 Present Value(现值)公式:未来第 \(k\) 期的一笔现金流 \(CF_{t+k}\),按折现率 \(i\) 折算到当前的价值是:
$$ PV = \frac{CF_{t+k}}{(1+i)^k} $$RL 里的折扣回报:未来第 \(k\) 步的 Reward \(r_{t+k+1}\),乘以 \(\gamma^k\):
$$ \gamma^k \cdot r_{t+k+1} $$把两边放在一起,形式上很像。如果令 \(\gamma = \frac{1}{1+i}\),两个公式结构完全一致——都是用指数衰减的权重降低远期收益对当前评价的贡献。
但想了一下,两者的含义不完全一样。
金融中的折现率 \(i\) 通常反映资金的时间价值、机会成本和风险补偿。一块钱今天到手和一年后到手,价值不同,这背后有经济学的解释。
RL 中的 \(\gamma\) 更多是一个建模参数——它定义了 Agent 应该在多大程度上重视远期奖励。\(\gamma\) 接近 0,Agent 几乎只看当前一步;\(\gamma\) 接近 1,Agent 把很远之后的奖励也当回事。
两者的共同点是形式上的:远期的东西权重更低。但把 RL 的 \(\gamma\) 直接解释成市场利率,或者把金融折现率直接等同于 \(\gamma\),都不太准确。
那 \(\gamma\) 的不同取值到底意味着什么?画一张图比较直观。
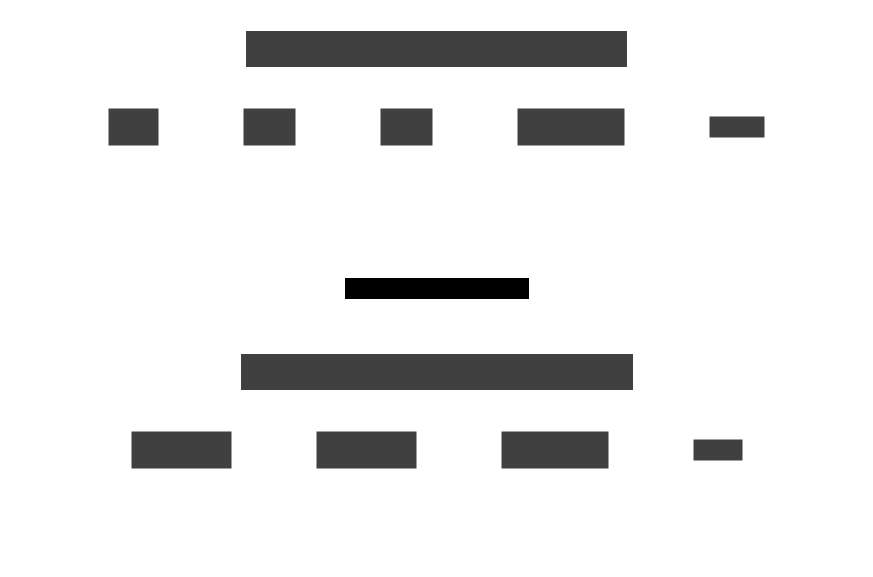
下面是 \(\gamma = 0.9\)、\(\gamma = 0.99\)、\(\gamma = 0.999\) 三种情况下,未来第 \(k\) 步 Reward 的权重 \(\gamma^k\):
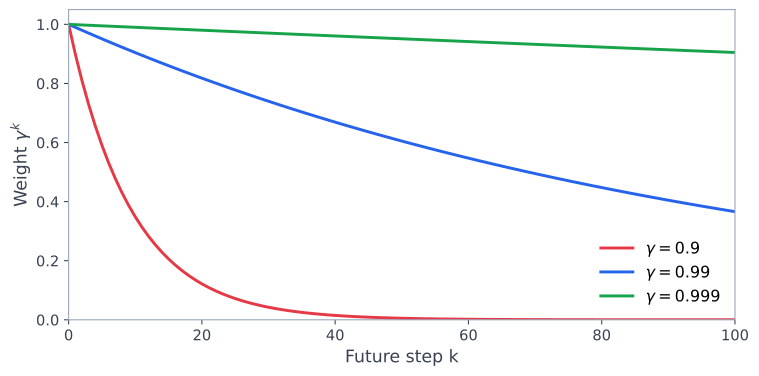
\(\gamma = 0.9\) 的曲线掉得很快——大约 20 步之后,Reward 的权重已经不到初始值的 15%。\(\gamma = 0.99\) 在 100 步时仍然保留约 37% 的权重。\(\gamma = 0.999\) 则几乎在 100 步内保持平坦。
一个常见的直觉估算:有效折扣期限大约是 \(H_{\text{eff}} \approx \frac{1}{1-\gamma}\)。当 \(\gamma = 0.99\) 时,\(H_{\text{eff}} \approx 100\)——意味着 Agent “大致在意"未来 100 步以内的 Reward。
但这只是量级上的直觉。\(H_{\text{eff}}\) 不是说 Agent 精确地规划到第 100 步然后完全忽略第 101 步。它也不保证 Agent 真的能学到有效利用那么远的信息。
几个容易犯的错误认识:
- \(\gamma\) 越接近 1,Agent 一定学到更好的策略?不一定。\(\gamma\) 太大会让优化目标的方差增大,训练可能更不稳定。
- \(\gamma = 1\) 不能用?在有限步数的任务里完全可以用 \(\gamma = 1\),这时 Return 就是 Reward 的简单总和。
- \(\gamma\) 只是在表达"人更喜欢即时满足”?不是。\(\gamma\) 是目标函数的一部分,它参与定义了 Agent 到底在优化什么。
Discount Factor 不是公式中一个可以随意忽略的装饰系数。它直接参与定义了 Agent 应该如何权衡即时奖励与远期奖励——也就是说,\(\gamma\) 的选择,实际上在定义优化目标本身。
Policy:RL 学到的到底是什么#
前面讲了环境、动作、奖励、回报。但 Agent 做决策的那个东西本身是什么?
答案是 Policy(策略)。
Policy 是 Agent 根据当前状态选择动作的规则。
最简单的形式是确定性策略:
$$ a_t = \pi(s_t) $$给一个状态,输出一个确定的动作。比如"在位置 (3,1) 时向右走"。
但更一般的形式是随机策略:
$$ a_t \sim \pi_\theta(\cdot \mid s_t) $$\(\pi_\theta(a \mid s)\) 表示:在状态 \(s\) 下,选择动作 \(a\) 的概率。\(\theta\) 是策略的参数。
举个例子。假设 Agent 在网格的某个位置,策略输出四个动作的概率:
| 动作 | 概率 |
|---|---|
| Up | 0.1 |
| Down | 0.2 |
| Left | 0.1 |
| Right | 0.6 |
然后按这个分布随机采样一个动作执行。
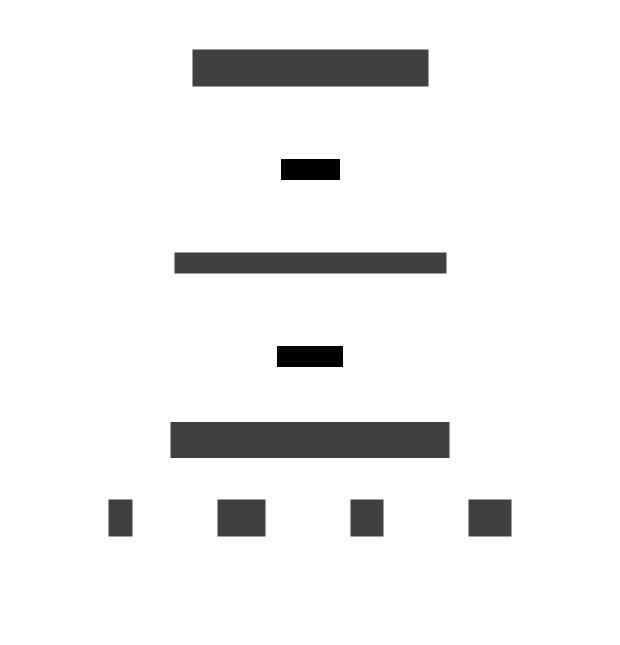
如果 Policy 是一个神经网络,这看起来是不是很眼熟?输入一个 state 的表示,最后一层过 Softmax,输出各个动作的概率——和分类模型的结构几乎一样。
我当时确实冒出过一个疑问:既然 Policy 网络和分类网络长得这么像,那 RL 和 supervised classification 到底差在哪?
差别不在网络结构。差别在训练信号的来源。
分类模型有每个样本的正确 label,通过 cross-entropy loss 直接告诉网络应该输出什么。Policy 网络没有这个东西——没有人告诉它"在这个状态下正确动作是 Right"。它需要通过和环境交互、从 Reward 中间接地发现好的策略。
具体怎么从 Reward 生成可微的训练信号、怎么更新 Policy 的参数——这是后续文章(DQN、Policy Gradient)要回答的问题。这里先不展开。
还需要说明一点:Policy 不一定非要用神经网络表示。它可以是一张查找表(每个状态对应一个动作),可以是一组手写规则,也可以是一个线性模型。强化学习本身不要求 Deep Learning。Deep RL 只是指用深度神经网络来表示 Policy 或其他学习对象。
这一节的核心:RL 的目标是学到一个好的 Policy——一套在不同状态下做出有效决策的规则——而不只是预测未来 Reward 会是多少。
你的行动决定你看到什么#
在 supervised learning 中,训练数据通常是事先固定好的:一个数据集,模型在上面迭代训练。样本的分布不会因为模型的输出而改变。模型预测一张图片是猫还是狗,不会导致下一张图片变成飞机。
但在 RL 中,情况完全不同。
回到网格世界。Agent 站在起点 (4,0)。
如果它选择向右走,下一步到达 (4,1),然后会看到 (4,1) 周围的环境,面对一组新的动作选择。
如果它选择向上走,下一步到达 (3,0),看到的是完全不同的局面。
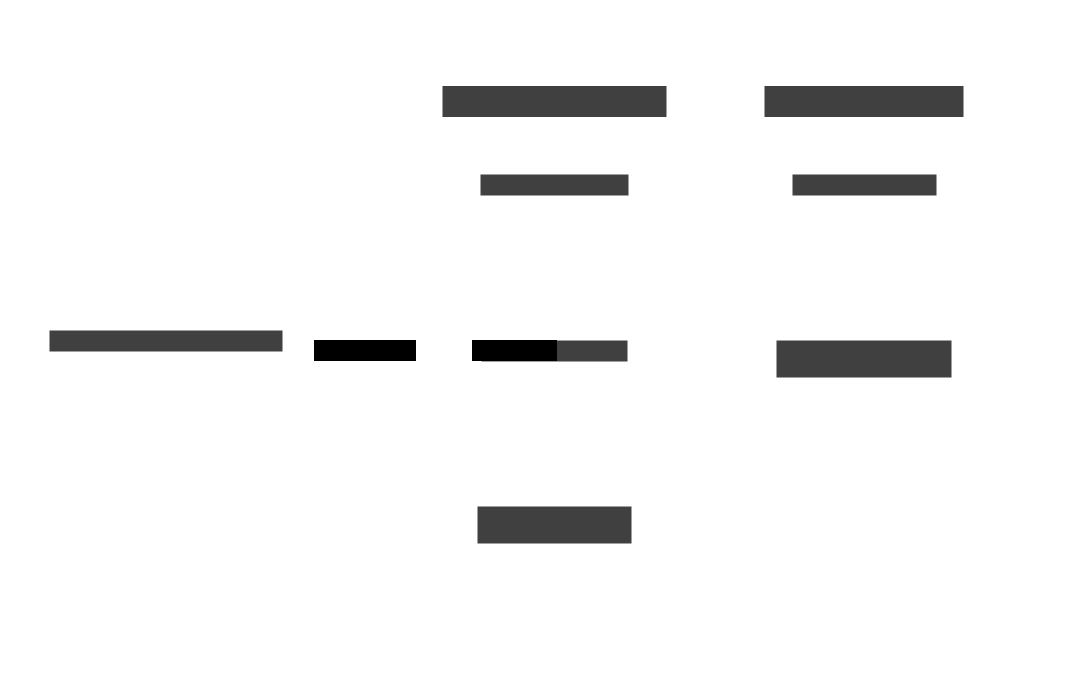
Agent 的动作改变了它下一步所处的状态,从而改变了它后续能观察到的所有经验。
这意味着什么?
Policy 不仅决定 Agent 如何行动,还间接决定了它后续收集到哪些数据。一个保守的策略可能永远只在起点附近转悠,收集到的全是小范围内的经验。一个激进的策略可能很快走到陌生区域,遇到之前没见过的状态。
用更正式的说法:在在线 RL 中,数据的分布依赖于当前的 Policy。Policy 变了,数据分布也跟着变。
这和 supervised learning 有一个根本的结构性差异。Supervised learning 的训练分布一般被假定为固定的。RL 的训练分布和学习过程本身耦合在一起——你学到什么策略,决定了你能看到什么数据,而你看到什么数据,又影响你接下来能学到什么策略。
当然,需要保持准确:
- 不是所有 supervised learning 的数据都永远固定——比如 active learning 也会根据模型状态选择新的样本。
- 也不是所有 RL 都必须实时和环境交互。有一个方向叫 Offline RL(离线强化学习),使用已有的交互数据进行训练,不再收集新数据。但即使在 Offline RL 中,数据分布与收集时使用的策略之间的关系仍然是核心问题。
这里的重点是让自己记住:RL 的数据生成过程和策略之间存在反馈关系。这是 RL 比 supervised learning 更难的一个重要原因。
要不要试一试那个不确定的动作#
数据分布依赖 Policy 这件事,还引出了 RL 里一个绕不过去的矛盾。
假设 Agent 在网格世界里已经探索了一段时间,积累了一些经验:
- 向右走:试过 100 次,平均每次最终回报 +3。
- 向上走:只试过 2 次,两次都碰到了障碍物,回报 -2。
如果 Agent 永远选择目前看起来最好的动作(向右走),它确实能拿到稳定的 +3。但它可能永远不知道:向上走如果绕过障碍物之后,有一条回报 +8 的路径。
只试了 2 次就判定"向上走不行",这个结论可信吗?样本太少,估计的方差很大。也许第 3 次试的时候,会发现向上走其实是更好的选择。
这就是 Exploration vs Exploitation 的核心矛盾:
- Exploitation(利用):选择目前已知的最优动作,最大化当前预期收益。
- Exploration(探索):尝试不确定的动作,获取新信息,可能发现更好的策略。
这不是"随机乱试 vs 正确行动"那么简单。
Exploration 是有代价的——每次选择一个不确定的动作,可能会得到很差的结果。但 Exploitation 也有代价——如果永远不探索,你可能一直卡在一个局部最优的策略上,永远不知道有更好的选择存在。
之前讲到 Policy 可以输出概率分布。一个自然的问题是:随机策略是不是天然就在 Exploration?确实,输出概率分布意味着不会每次都选同一个动作,有一定的探索效果。但有随机性不等于"充分探索"——如果概率分布已经非常集中(比如 95% 的概率选向右),其他动作几乎不会被尝试。
Exploration 和 Exploitation 的权衡没有通用的最优解。不同的算法有不同的策略,比如 ε-greedy(大部分时间选最优,小概率随机)、UCB(根据不确定性调整选择)等。具体方法不是这篇的重点。
这里想记住的是:RL 面对的不只是"如何从已有信息做最优决策",还有一个更深的问题——为了在未来做出更好的决策,Agent 现在是否应该主动承担风险、尝试那些尚不确定的动作?
这是 RL 和 supervised learning 的又一个结构性差异。Supervised learning 的核心一般是利用已有数据学习输入到目标的映射。RL 除了学习之外,还需要面对"如何主动获取有用信息"的问题。
写在最后#
回到最初的问题:没有 Label,模型到底怎么学会决策?
走到这里,至少能给出一个初步的回答了。
RL 的训练信号来自 Reward——环境对 Agent 动作结果的评价。Reward 不直接指示正确动作,但通过累积大量交互经验,Agent 可以逐渐发现哪些 Policy 在长期上获得更高的 Return。
不过,说"逐渐发现"其实回避了最关键的问题。具体怎么发现?
如果一个动作的长期回报要等到几十步甚至更多步之后才能知道,那 Agent 在当前状态下,如何判断不同动作的长期价值?
这个问题的答案是 Value Function 和 Q-Function——把"一个状态(或状态-动作对)的长期期望回报"这件事本身建模为一个可学习的函数。
下一篇就从这里展开:[Q-Function 与 Bellman Equation:如何评价一个动作的长期价值?]
参考资料#
- MIT 6.S191: Introduction to Deep Learning (2026 Edition), Lecture 5: Deep Reinforcement Learning — https://introtodeeplearning.com/
- 训练信号从哪里来:重新理解有监督、无监督、半监督与自监督学习
- 量化交易不是一个模型:从 Alpha 到执行的完整系统框架
- 从 Forward 到 Optimizer:再看一遍 Training Loop