在 2022 年终总结 里,我曾用几句话带过当时做的一个“动态算力”项目。那一年,我和另一位同事从零到一推进了这套系统,陆续落地了腾讯新闻、QQ 音乐、全民 K 歌等多个核心业务,部分场景节省了约 30% 的成本。
当时总结更侧重于“做成了什么”;几年之后的今天再回头看,我更想补的是“为什么这种方法有效,以及其中有哪些可以复用的系统设计思想”。这套推荐链路的负载自适应系统(Adaptive Load Control),其实回答了一个非常普适的工程问题:当机器的物理弹性跟不上流量的变化时,我们还能做点什么?
为什么推荐 serving 很难跟着潮汐流量扩缩容?#
互联网流量有非常明显的潮汐效应:凌晨低峰期,请求稀少,机器大量空闲;而到了晚高峰或突发热点事件时,请求暴增,机器瞬间接近容量极限。
遇到这种问题,最直觉的解决办法当然是 autoscaling。
但推荐模型的 serving 并不是完全无状态的 Web Server。机器扩容以后,还需要经历服务启动、模型加载、模型 warm-up、流量切换等一系列 initialization。
因此,serving capacity 无法以和互联网请求相同的速度进行弹性伸缩。
当时比较保守的资源规划方式是:按一周甚至更长时间里可能出现的峰值流量准备机器。这样能够保证高峰稳定,但绝大多数时间里大量机器处于低利用率状态。
如果短时间内改变不了机器数量,还有没有别的东西可以动态调整?
Quota:一个天然的 workload knob#
重新审视多阶段推荐链路,不管在哪一个阶段,通常都需要决定一件事:有多少 candidate item 进入这个阶段进行排序。
在这个链路里,我们把这个数量称为 quota。
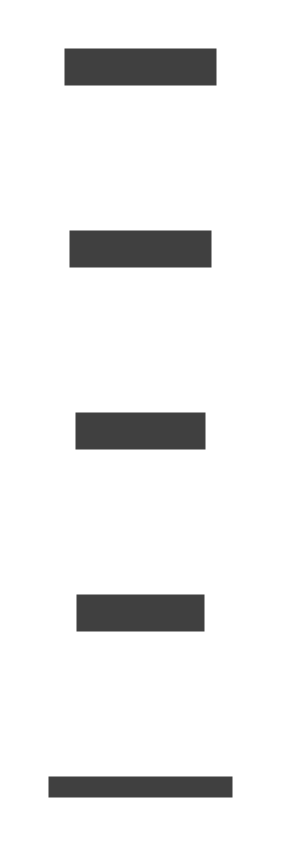
这套负载控制系统本身并不感知它接管的是粗排还是精排(最开始主要接在计算成本较高的精排,后来也有粗排场景接入)。Infra 层只要求业务暴露这样一个可以动态调节的 quota。
quota 越大,更多 item 被排序,计算量增加,通常有机会获得更好的推荐效果。但 recommendation quality 对 quota 存在明显的 diminishing return(边际递减)(真正的效果必须通过业务 A/B Test 确认)。与此同时,计算开销 Compute Cost 是随着 quota 刚性增长的。
这两条关系意味着:quota 把 recommendation quality 和 compute cost 连接了起来。 这是整套系统成立的前提。
与其扩机器,不如让 workload elastic#
传统的扩容思路是:Traffic ↑ -> Compute Demand ↑ -> Capacity 不够 -> Scale Out。
既然 stateful model serving 的扩容反应没有流量变化那么快,我们换了一个方向:
流量飙升时:Traffic ↑ -> 单请求 Available Compute ↓ -> 主动降低 Quota -> 单请求 Compute ↓ -> Service Survives。 低峰期则相反:Traffic ↓ -> Idle Compute ↑ -> 主动提升 Quota -> 利用原本闲置的算力 -> 尝试获得更好的推荐效果。
这是这套系统最核心的 Big Idea:Serving capacity 不够 elastic,就让 workload 本身 elastic。
它不是“动态扩缩容”的另一种实现,恰恰是在 capacity 很难及时扩缩时,通过改变 workload shape 来解决问题。低峰解决的是 resource efficiency / recommendation quality;高峰解决的是 availability / overload protection。所以“削峰填谷”不是一句比喻,而是系统真正做的两件事。
为什么 CPU utilization 不是好的实时控制信号?#
这是本文一个很重要、而且容易写错的地方。
早期直觉很容易是:CPU 高,就降 quota;CPU 低,就升 quota。
但线上最终没有直接使用 CPU utilization 做实时 feedback,原因是:监控指标有明显的延迟。
当时监控平台获取 CPU utilization 的时间粒度太粗,最低也在数秒量级。而线上流量可能出现远短于这个时间尺度的 burst:
1时间 ───────────────────────────────▶
2
3CPU/Traffic
4
5     ███████████
6     ███████████
7____████████████____________________
8       ↑
9    极短的流量毛刺
即使分钟平均 CPU 没有打满,也完全可能因为某个 100ms 左右的瞬时流量尖峰,造成 latency 飙升、timeout、请求失败甚至服务不稳定。
所以并不存在一个全局通用的 CPU < 70% 就一定安全 的结论。安全 CPU 水位与模型、服务实现、请求分布、burst characteristics 以及业务 SLA 都有关系。这个问题由业务自己判断,负载控制系统不试图替业务解决。
从 CPU 转向 quota consumption#
既然 CPU feedback 太慢,我们最终没有等待 CPU 告诉系统“我已经过载了”,而是换成了一个更靠前的指标:quota consumption。
对于一个请求,在真正执行复杂 ranking computation 之前,系统已经知道这次请求会消耗多少 quota。因此,quota 可以作为 compute workload 的 proxy。
这是全文非常重要的第二个 insight:当 resource-side metric 的反馈延迟太高时,可以寻找一个更接近请求入口、能够提前描述资源需求的 workload-side signal。
在这里,CPU utilization 属于 downstream / lagging signal,而 quota consumption 更加接近 workload-side leading signal。我们不要过度声称 quota 可以精确预测 CPU,但在工程上,它是一个足够有用的 proxy。
把 capacity 抽象成 total_quota#
系统需要一个 capacity budget:total_quota。
它表示:在一个时间窗口内,这组 serving machines 大致可以承担多少 quota workload。这个数字并不是由控制系统自动准确算出来的。当时主要根据当前业务、模型、机器规模、历史运行情况以及 CPU 峰值利用率,粗略换算出一个合理的 total_quota。
这一步依然具有业务和模型相关性。Infra 层并不试图回答“这个服务理论上的绝对最大 capacity 是多少”,而是接受业务已经验证过的大致 capacity boundary。这做到了 Business 与 Infra 的解耦。
Redis:实时维护 sliding-window quota_sum#
线上真正需要维护的是:过去一个滑动时间窗口内所有请求 quota 的总和,也就是 quota_sum。
这里使用 Redis 维护全局 sliding window。随着流量和接入业务扩大,这个 sliding-window accounting 本身也遇到了 Redis 性能问题;具体优化过程我当年已经专门写过一篇:Redis 笔记,这里不展开。这其实是很好的历史呼应:2022 年当时只记录了“怎么把 Redis 搞快”,2026 年再回来补完整当年为什么需要这个全局时间窗口。
Feedback Control:PID 控制的是 quota#
整个控制模型被抽象成了一个反馈闭环:
$$ e(t) = total\_quota - quota\_sum(t) $$PID 根据这个 error 输出一个新的 base quota。系统支持配置 Kp / Ki / Kd 参数,但生产实践里绝大多数业务直接使用默认参数,实际线上也没有遇到明显的 PID oscillation 问题。
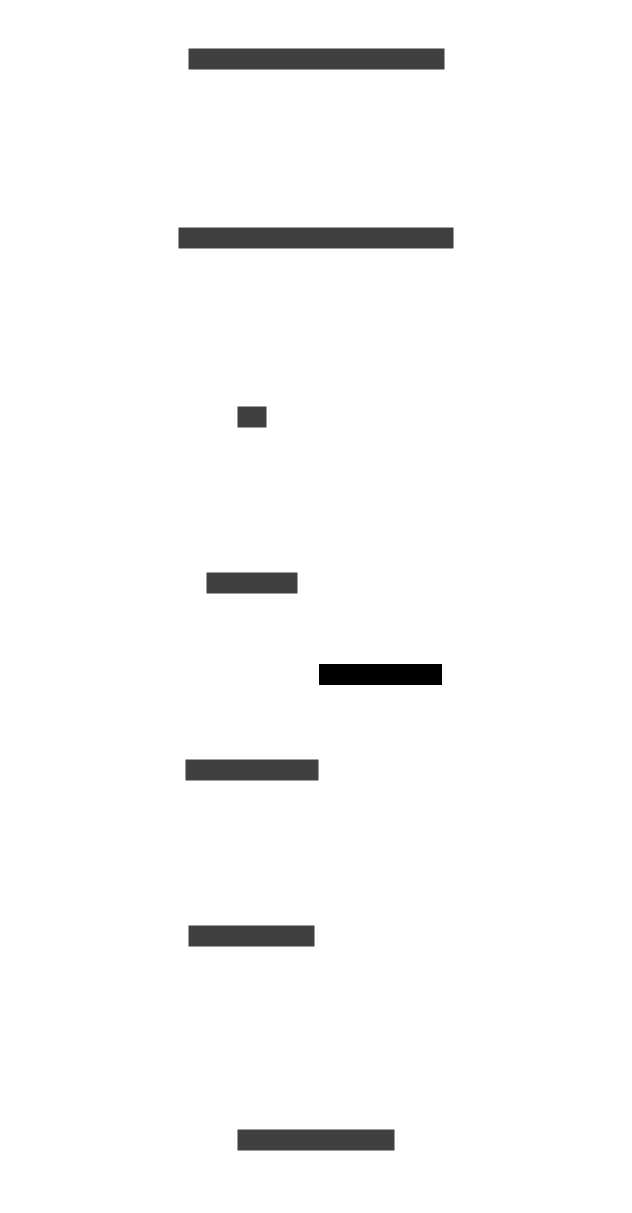
同时,PID 得出的结果始终受到业务定义的安全边界限制:
$$ quota = \operatorname{clamp}(PID(e), q_{min}, q_{max}) $$这其实代表一个很重要的 architecture boundary:Infra 可以动态优化,但不能越过业务允许的 quality / cost boundary。
此外,控制对象不是单个 process,也不是单台机器。实际是:一组承载同一个业务的 serving machines,共享一个 workload budget,由一个逻辑 PID controller 控制。
user_value:请求并不天然平等#
系统后来又引入了 user_value。由业务方传入一个 coefficient(比如 0.5 到 1.5 之间)。Infra 不负责判断谁是高价值用户或会员,业务只传入权重,最终:
这本质上已经不仅是 load shedding,而是 value-aware resource allocation / differentiated QoS。 业务语义(“这个请求有多重要?”)没有泄漏进 Infra(“在有限 compute budget 下应该给它多少资源?”)。
Side-car:负载控制不能成为新的单点#
这套自适应机制以旁路 / side-car 思路接入。关键原则:Adaptive control 是 enhancement,而不是 recommendation serving correctness 的必要条件。
如果 Redis 不可用、controller 挂了,上游业务直接 fallback 到自己配置的 default_quota。
一个为了提升 availability 而存在的系统,不应该自己变成 serving 的强依赖。失败时最坏只是退化回“没有动态算力之前的固定 quota 世界”,而不是把推荐主链路一起带挂。
一次真实的突发流量检验#
2022 年 7 月 8 日安倍晋三遇刺后,新闻流量发生了非常大的突发增长。当时腾讯新闻承受了明显的 traffic spike。
接入动态算力/负载自适应模块的服务,在这次突发流量中保持了稳定;没有接入相同保护机制的一些模块出现了大量请求失败甚至服务被冲垮的情况。
在固定 quota 下,突发流量导致 Total Compute Demand 瞬间远超 Capacity Limit,进而引发 Latency 飙升和 Timeout。而自适应 quota 在 quota_sum 接近 budget 时,主动降低了 base quota,使得 Compute Per Request 下降,服务 quality 有控制地下降,存活了下来。
这印证了全文非常重要的一句话:在极端负载下,可控的 quality degradation,往往比不可控的 availability failure 更好。 (graceful degradation is better than binary failure)
这和本站最近的一篇《训练集群 Quota 反馈回路》思想其实有共通之处:很多 Infra 问题不一定需要先准确预测一个“正确答案”,而是可以建立 observe → feedback → adjust 的闭环,让系统持续根据真实状态调整。
Big Ideas:几年之后再看,这件事真正留下了什么#
这套系统留下的,远不只是“我们在推荐系统里用了 PID”,而是以下几个更普适的系统设计思想:
- Serving capacity 不够 elastic,就让 workload elastic。 不要默认所有弹性都必须来自机器扩缩容。
- Recommendation quota 是 quality 和 compute 之间天然存在的 control knob。 一个好的 Infra control knob 往往不需要完全理解业务,只需要和 workload 存在稳定关系。
- 不要只盯 resource-side metrics;寻找更及时的 workload-side signal。 CPU utilization 是滞后的结果,当监控 feedback latency 太高时,quota consumption 是更合适的控制信号。
- Overload protection 的目标不是保持所有请求的最高质量,而是让 degradation 可控。
- 有限 compute budget 不一定应该平均分配。
user_value把 business value 和 Infra resource allocation 解耦,实现了 differentiated QoS。 - 保护主链路的系统,本身不能成为新的主链路强依赖。