起因#
最近在复习 MIT 6.S191 的 RNN 部分,看到下面这张 slide 时停了一下。
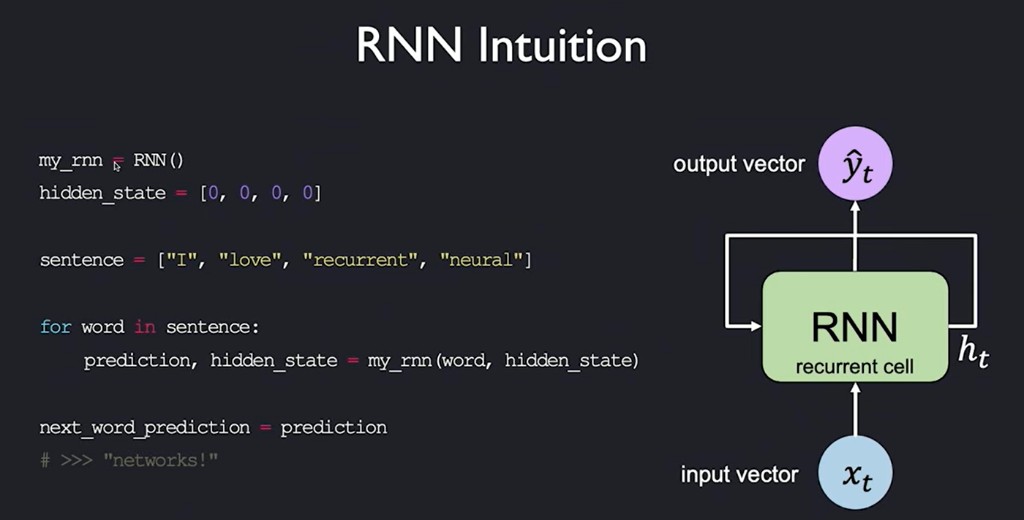
左边代码里这一行:
1prediction, hidden_state = my_rnn(word, hidden_state)右边图里同时画了 \(h_t\) 的回环和 \(\hat{y}_t\) 的向上输出。但 PyTorch API 里的 output 又指每一步的 hidden state,并不直接等于任务的 prediction。
同一个 “output” 在图示和 API 里指向了不同的东西。这篇把 hidden state、框架返回值和 prediction head 分开记一下。
RNN 的核心:State Transition#
先从最本质的一行公式开始。
$$ h_t = f_W(h_{t-1}, x_t) $$一句话说清楚:给定上一步的状态 \(h_{t-1}\) 和当前输入 \(x_t\),算出当前状态 \(h_t\)。
具体到 vanilla RNN,展开就是:
$$ h_t = \tanh(W_{hh} h_{t-1} + W_{xh} x_t + b) $$这个公式定义了一个 state transition function。它接收两个东西——上一步的内部状态和当前时刻的新输入——然后产出一个新的内部状态。
把它沿时间展开:
\(h_t\) 编码了从 \(x_1\) 到 \(x_t\) 的所有历史信息(理论上)。它是 RNN 对"到目前为止发生了什么"的压缩表示。
这个 state transition 就是 RNN 的本体。它和建立在它之上的其他操作属于两个层次,需要分开来看。
“Output” 到底指什么#
“Output” 这个词在 RNN 语境下至少有三种不同的含义,经常被混着用。
数学公式中的 output#
6.S191 下一张 slide 把这件事画得很干净:左边是 cell 的结构,右边把公式按颜色拆开。
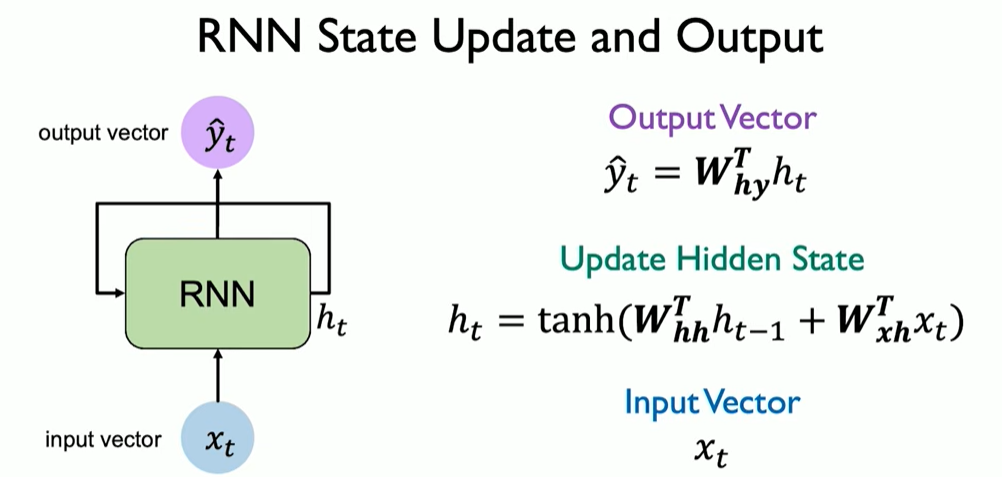
对应到公式:
$$ h_t = \tanh(W_{hh}^T h_{t-1} + W_{xh}^T x_t) $$$$ \hat{y}_t = W_{hy}^T h_t $$第一行是 state transition(Update Hidden State),第二行是从 hidden state 到 output 的映射(Output Vector)。这里的 \(\hat{y}_t\) 才是数学意义上的 “output”——它是 hidden state 经过一个 linear transformation 后的结果。
但问题在于:在 vanilla RNN 中,很多讲解直接省掉第二行,把 \(h_t\) 本身当作 output。也就是说,hidden state = output。
这不是错误——vanilla RNN 确实可以这么理解。但它制造了一个隐含假设:hidden state 和 output 是同一个东西。一旦读者带着这个假设去看其他材料,混淆就开始了。
框架 API 中的 “output”#
看 PyTorch 的 nn.RNN:
1output, h_n = rnn(x, h_0)这里返回了两个东西。自然的理解是:output 是模型的输出,h_n 是最终的 hidden state。
但实际上,output 的 shape 是 [seq_len, batch, hidden_size]——它是 每一个时间步的 hidden state 拼在一起的序列。也就是 \([h_1, h_2, \ldots, h_T]\)。
而 h_n 是最后一个时间步的 hidden state \(h_T\)。
对于单层、单向的 RNN:
1output[-1] == h_n.squeeze(0) # True换句话说,PyTorch 把"所有时间步的 hidden state 序列"叫做 output。它不是 prediction,也不是经过任何 task head 之后的结果。它就是 hidden state。
这个命名选择不能说有错——从 RNN cell 的角度看,每一步的 hidden state 确实是这个 cell 对外暴露的输出。但它很容易让人误以为拿到 output 就已经拿到了模型的预测。
示意图中的混用#
很多教学示意图在 RNN cell 的顶部画一个向上的箭头,标注 “output” 或 “\(\hat{y}_t\)"。有时这个箭头指的是 \(h_t\)(hidden state 本身),有时指的是 \(h_t\) 经过 output layer 之后的 prediction。
更令人困惑的情况是:同一张图里,从 cell 顶部引出两个箭头——一个水平传给下一步(标注 \(h_t\)),一个垂直向上(标注 “output”)——但这两个箭头指的其实是同一个 tensor。
看到 “output” 时,第一反应应该是问:这是 \(h_t\) 还是 \(\hat{y}_t\)?
Prediction 只是 Output Projection#
把前面的混淆理清之后,可以给出一个清晰的划分:
RNN 有两层操作,它们的职责完全不同:
$$ \text{State transition:} \quad (x_t, h_{t-1}) \rightarrow h_t $$$$ \text{Output projection:} \quad h_t \rightarrow \text{task head} \rightarrow \hat{y}_t $$第一层是 RNN 的本体——state transition。它不关心具体任务是什么,只负责维护一个随时间演进的内部状态。
第二层是 output projection——从 hidden state 中提取当前任务需要的信息。这个 task head 可以是一个 linear layer + softmax(语言模型),可以是一个 classifier(情感分类),可以是任何东西。它是任务特定的,不属于 RNN 本身。
RNN 的核心抽象是 state transition。Prediction 只是对 state 的 output projection。
不同的任务共享同一个 state transition 机制,只是 output projection 的方式不同:

语言模型在每个时间步都做 output projection(预测下一个 token)。序列分类只在最后一步做 output projection(把整个序列映射到一个 label)。序列标注则在每步做 output projection,但可能用不同的 task head。
底层的 state transition 是一样的。变化的只是"从 state 里读什么、在哪里读”。
Weight Sharing#
RNN 还有一个容易被忽略的 design choice:同一组参数 \(W\) 在所有时间步复用。
$$ h_t = f_W(h_{t-1}, x_t) $$不是 \(f_{W_1}, f_{W_2}, \ldots, f_{W_T}\)。是同一个 \(f_W\)。
这意味着:无论序列有多长,RNN 用的 transition function 都是同一个。第 1 步和第 1000 步应用的变换规则完全相同。
这不只是"省参数"。它编码了一个归纳偏置:序列中每一步的 transition rule 是相同的。
类比一下 CNN。CNN 的 kernel 在空间维度上共享——同一个 3x3 filter 滑过整张图片的每个位置。这背后的假设是:局部 pattern(比如边缘、纹理)不依赖于它出现在图片的哪个位置。
RNN 的 weight sharing 是同一个思想在时间维度上的版本:序列中的局部 transition rule 不依赖于它发生在序列的哪个位置。
Weight sharing 还带来一个实际后果:RNN 的参数量不随序列长度增长。一个处理长度为 10 的序列和处理长度为 10000 的序列的 RNN,参数完全一样。这让 RNN 能够处理任意长度的输入。
为什么 Vanilla RNN 特别容易让人混淆#
回到最开始的问题:为什么这几个概念这么容易搞混?
一个重要原因是 vanilla RNN 的结构太"简单"了——简单到 hidden state 和 output 之间没有任何区分。
Vanilla RNN 的 hidden state \(h_t\) 直接就是暴露给外部的东西。没有额外的 gate 来控制"哪些信息对外可见"。所以在 vanilla RNN 的语境下,说"hidden state 就是 output"确实没什么问题。
但 LSTM 打破了这个等式。
LSTM 引入了 cell state \(c_t\) 作为真正的内部状态,然后用 output gate 控制 \(c_t\) 中哪些信息暴露出去:
$$ h_t = o_t \odot \tanh(c_t) $$这里 \(o_t\) 是 output gate,\(h_t\) 是 \(c_t\) 经过筛选后的结果。
在 LSTM 中,\(c_t\) 才是完整的内部状态,\(h_t\) 更像是"cell state 的一个 filtered view"。但 PyTorch 的 nn.LSTM 仍然把 \(h_t\) 叫做 “hidden state”,把 \(c_t\) 叫做 “cell state”——这又制造了新一层命名上的不对称。
Vanilla RNN 中 hidden state = output 的等式,是一个特例,不是通用规则。一旦引入 gate 机制(LSTM、GRU),hidden state 和对外暴露的 output 就不再是同一个东西了。
重新看 6.S191 的两张 slide#
现在再回头看开头那两张图,对应关系就清楚了。
第一张 Intuition slide 的代码:
1prediction, hidden_state = my_rnn(word, hidden_state)返回的是两个东西:hidden_state 是 state transition 的结果,prediction 是 output projection 的结果。它们一起出现在同一个函数调用里,但职责完全不同。
第二张 State Update and Output slide 则把公式拆开了:绿色的是 \(h_t = \tanh(\ldots)\),紫色的是 \(\hat{y}_t = W_{hy}^T h_t\)。cell 图上:底部是 \(x_t\),侧面回环是 \(h_t\),顶部出去的是 \(\hat{y}_t\)。
整个 RNN 可以用两行伪代码概括:
1# state transition(RNN 本体)
2h_t = f(h_{t-1}, x_t; W)
3
4# output projection(任务特定)
5y_t = task_head(h_t)
之前那篇 training loop 的笔记讨论了 forward / backward / optimizer 的职责划分。这里是类似的思路:把 RNN 拆成"状态演进"和"状态读取"两个独立的职责,很多混淆就消失了。
总结#
RNN 的本体是 state transition:\((x_t, h_{t-1}) \rightarrow h_t\)。Prediction 只是对 state 的 output projection。
框架 API 中的 “output”(如 PyTorch
nn.RNN的返回值)通常是每步的 hidden state 序列,不是 prediction。看到 “output” 时先问:这是 \(h_t\) 还是 \(\hat{y}_t\)?Weight sharing 不只是参数效率——它让 RNN 能处理任意长度的序列,并且编码了"transition rule 在时间上不变"这个归纳偏置。
参考资料#
- MIT 6.S191: Introduction to Deep Learning — https://introtodeeplearning.com/
- PyTorch nn.RNN 文档 — https://pytorch.org/docs/stable/generated/torch.nn.RNN.html
- 从 Forward 到 Optimizer:再看一遍 Training Loop