上一篇走到了一个结论:去掉 recurrence 之后,Self-Attention 必须重新获得 positional information。position 可以加进 token 的 representation,两者相加不要求后续计算无损还原,只要下游能利用其中的信息就行。
到这里逻辑上说得通。但我接着去看原始 Transformer 的 Positional Encoding 公式时又卡住了——一个 sequence 的位置不就是 0, 1, 2, 3 这样的整数吗?为什么要搞 sin、cos、10000 的某个幂次?而且还用了很多组不同频率的 sin 和 cos?
这个公式看起来像从天上掉下来的。于是我决定把它拆开,搞清楚每一块到底在做什么。
位置本来就是一个整数#
先退一步。Transformer 需要"发现" token 在 sequence 里的位置吗?
不需要。position 一直都在:
1position = 0, 1, 2, 3, ...sequence 有多长、每个 token 排第几,这些在输入的时候就完全确定了。Transformer 不需要做任何推断。
真正的任务是另一件事:怎么把一个 integer position 转换成 neural network 可以使用的 vector representation?
token 那一侧早就有了:token id 查 embedding table,得到一个 \(d_{\text{model}}\) 维的向量。position 这一侧要做类似的事——把一个 integer 变成同样维度的向量,然后和 token embedding 相加。
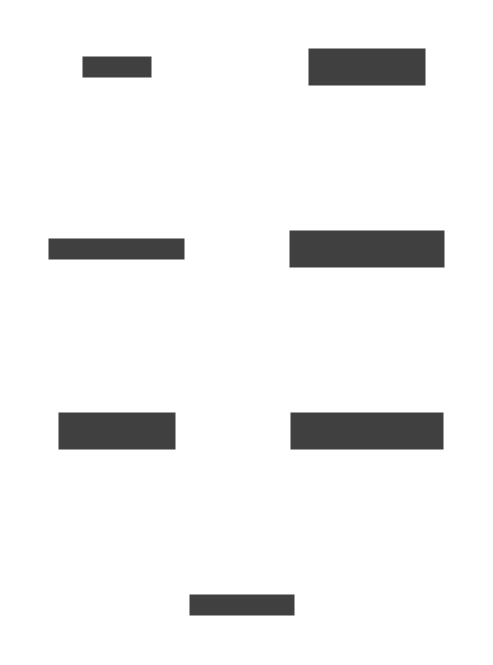
所以 Positional Encoding 不是在发现 position,而是在编码一个已知的 position。它和 token embedding 一样,本质上是 representation design:给一个离散输入选一种向量化的方式。
原始公式#
Attention Is All You Need 给出的 Sinusoidal Positional Encoding 公式是:
$$ PE(pos, 2i) = \sin\!\left(\frac{pos}{10000^{2i/d_{\text{model}}}}\right) $$$$ PE(pos, 2i+1) = \cos\!\left(\frac{pos}{10000^{2i/d_{\text{model}}}}\right) $$其中 \(pos\) 是位置,\(i\) 是维度索引。
第一遍看到这个公式的时候我确实没有什么直觉。10000 这个常数是什么?\(2i / d_{\text{model}}\) 作为指数是什么意思?但如果把公式拆一下,它的结构其实不复杂。
每一对相邻维度 \((2i, 2i+1)\) 对应一个频率 \(\omega_i = 1 / 10000^{2i/d_{\text{model}}}\)。写成更紧凑的形式:
$$ PE_{\omega}(p) = [\sin(\omega p),\; \cos(\omega p)] $$完整的 PE 就是把很多组不同频率的 \([\sin, \cos]\) 拼在一起:
$$ PE(p) = [\sin(\omega_0 p), \cos(\omega_0 p), \sin(\omega_1 p), \cos(\omega_1 p), \ldots] $$\(\omega_0\) 最大(高频),\(\omega_{d/2-1}\) 最小(低频),构成一个从 1 到 \(1/10000\) 的等比数列。
这么拆开看,公式层面的复杂感消失了一大半:拿掉 10000 的指数,原始公式就是"很多组不同频率的 sin/cos"。
这是 Taylor expansion 吗#
看到很多 sin 和 cos,我第一个想到的是 Taylor expansion。两者是不是类似的东西?
不是。Taylor expansion 用的是 polynomial basis——\(1, x, x^2, x^3, \ldots\)——在某个点附近做局部逼近。这里用的是 frequency basis——多个不同频率的 sin/cos——把一个 scalar position 展开成多个 frequency 下的特征。
思路更接近 Fourier 的方向:用不同频率的周期函数来表示信号。但也不要把它当成 Fourier series——Fourier series 是对一个已知函数做分解,这里是在设计一种 representation,把一个 integer 映射成 high-dimensional features。
我后来理解的方式是:
1scalar position → 多个 frequency 探针 → 高维 representation每个 frequency 是一个"探针",用来从不同的尺度观察同一个 position。
完全可以提前算好#
写到这里我停下来想了一个问题:position 是固定的,公式也是固定的,那 PE 不是每次都一样吗?
确实如此。只要 \(pos\) 和 \(d_{\text{model}}\) 确定,\(PE(pos)\) 就完全确定。它不依赖 token、不依赖 batch、不依赖 training step,也不依赖任何 model parameter。
所以对于模型支持的最大长度 \(L\),完全可以预先生成一个 \([L, d_{\text{model}}]\) 的矩阵,训练和推理时直接 slice:
1x = token_embedding + pe[:seq_len]在 PyTorch 里通常用 register_buffer("pe", pe) 而不是 nn.Parameter——它需要跟着模型保存和移动到 GPU,但不需要梯度更新。
位置变大了,但 vector 没变大#
然后我注意到一件事。sin 和 cos 的值域是 \([-1, 1]\),所以 PE 的每一个维度都满足:
$$ -1 \le PE(pos, k) \le 1 $$这意味着 position 是 10 还是 10000,PE vector 的每一维都在同一个范围里。position 变大不会让 vector 的 magnitude 变大。
这让我意识到一件之前没有想清楚的事:Sinusoidal PE 把 position 信息从 magnitude 编码转成了 phase 编码。 position = 10000 和 position = 10 的差异体现在各个维度的 phase pattern 不同,而不是某个 vector 比另一个"更大"。
这对后面和 token embedding 做加法是一个很自然的性质——不会因为 position 数字大就压过 content embedding 的信号。
和 embedding 相加的 scale#
不过话说回来,PE 每维有界不等于和 embedding 的 scale 就天然匹配。representation 相加时,数值尺度确实需要考虑。
原始 Transformer 里有一个容易忽略的细节:token embedding 在进入模型前会乘以 \(\sqrt{d_{\text{model}}}\)。也就是说概念上:
$$ x = \sqrt{d_{\text{model}}} \cdot \text{Embedding}(token) + PE(pos) $$我不想过度解读这个 scaling 的单一因果(paper 里只简单提了一句),但至少可以看出:原始 Transformer 显式考虑了 token embedding 与 PE 的相对数值尺度。
把 content + position 能工作这件事拆开看,有三个层面:
- shape / representation compatibility——两者都是 \(d_{\text{model}}\) 维向量;
- network 可以学习如何解释混合后的 representation——上一篇讨论过;
- 数值 scale 不能完全失衡——PE 有界在 \([-1,1]\) 是一个有利性质,但不能因此简单声称"它天然和 embedding 完美同尺度"。
随便给个 unique vector 不行吗#
到这里自然会产生一个疑问:如果目的只是打破 Self-Attention 的置换不变性,让模型知道每个 token 的位置不同,为什么不直接给每个位置分配一个互不相同的唯一向量?比如随机生成一组固定的 \(d_{\text{model}}\) 维向量:
1position 0 → fixed random vector A
2position 1 → fixed random vector B
3position 2 → fixed random vector C
4...
答案是不行。
这里有一个关键区分:
- position identity:你是谁?你是第几个?
- position geometry:你和其他位置的相对关系是什么?距离多远?谁在谁前面?
随便给一组固定的 unique vector,确实能解决 identity——每个 token 的位置不同,置换不变性被打破了。但这些向量之间没有任何空间几何结构。在高维空间里,任意两个随机向量几乎都是相互正交的,内积接近于 0。这意味着在模型的感知里,position 1 和 position 2 的关系,跟 position 1 和 position 1000 的关系完全没有区别。模型既看不出前后顺序,也度量不出相对距离。
那为什么 BERT、GPT-2 这类模型使用的 Learned Positional Embedding 看起来也是查表(每个 position 对应一个向量),却完全能工作呢?
因为 Learned PE 绝对不是“随便给的固定唯一向量”。它的向量是可学习参数。在海量数据的预训练过程中,反向传播的梯度在强迫模型把位置之间的几何拓扑——例如相邻位置的平滑性、相对距离的衰减——硬生生“学”进了这块 embedding 表里。训练收敛后可视化这些 learned embeddings,会发现相近位置的向量相似度天然更高。
但这要付出代价:
- 依赖数据拟合:模型必须消耗额外的参数量和训练步数去“发现”本来就已知的位置关系;
- 无法外推(extrapolation):预设表长是多少就只能支持多长,遇到没见过的更长位置,完全无法计算对应的向量。
这就澄清了 Sinusoidal PE 的根本追求:Positional representation 的核心价值不只在于唯一标识位置(Identity),更在于提供规则、确定且有利于表示相对距离的几何结构(Geometry)。
它不想把位置几何的先验完全丢给训练去硬学,而是希望直接在表示空间里内建这种结构。
sinusoidal PE 的设计就是在追这后面一半。
一对 sin/cos 就是单位圆上的一个点#
现在来看 sinusoidal PE 到底给了什么结构。
对于一个固定的频率 \(\omega\),PE 给出一个二维向量:
$$ PE_{\omega}(p) = [\sin(\omega p),\; \cos(\omega p)] $$这两个分量满足:
$$ \sin^2(\omega p) + \cos^2(\omega p) = 1 $$也就是说 \([\sin(\omega p), \cos(\omega p)]\) 始终在单位圆上。
position 从 0 开始递增,对应的 phase \(\theta = \omega p\) 线性增长,这个二维点就沿着单位圆旋转。每个 position 对应圆上的一个 phase。
我以前看到"sin/cos encoding"的时候,只是把它当成两个数值。意识到它们在几何上构成单位圆上的一个点,是后面理解 rotation 和 relative position 的基础。
在圆上旋转#
如果 position 从 \(p\) 变成 \(p + \Delta\),phase 就从 \(\omega p\) 变成 \(\omega p + \omega\Delta\)。
利用三角函数加法公式:
$$ \sin(\omega p + \omega\Delta) = \sin(\omega p)\cos(\omega\Delta) + \cos(\omega p)\sin(\omega\Delta) $$$$ \cos(\omega p + \omega\Delta) = \cos(\omega p)\cos(\omega\Delta) - \sin(\omega p)\sin(\omega\Delta) $$写成矩阵形式:
$$ PE_{\omega}(p + \Delta) = \begin{bmatrix} \cos(\omega\Delta) & \sin(\omega\Delta) \\ -\sin(\omega\Delta) & \cos(\omega\Delta) \end{bmatrix} PE_{\omega}(p) $$右边那个矩阵就是一个二维旋转矩阵 \(R_{\omega\Delta}\)。
这里最关键的一点是:这个旋转矩阵只依赖 \(\Delta\),不依赖当前位置 \(p\)。
也就是说,“往后 3 个位置"这件事,不管起点是 10 还是 100,在这个二维 sin/cos 空间里对应的都是同样大小的旋转:
relative displacement 在 representation space 中具有一致的几何意义。position 10 和 position 13 之间的关系,与 position 100 和 position 103 之间的关系,在同一个 frequency 下是同一种 rotation。
dot product 与相对位置#
这个 rotation 结构还带来另一个性质。计算同一频率下两个位置的 dot product:
$$ PE_{\omega}(p) \cdot PE_{\omega}(q) = \sin(\omega p)\sin(\omega q) + \cos(\omega p)\cos(\omega q) $$利用三角恒等式:
$$ = \cos(\omega(p - q)) $$原来各自的 absolute position \(p\) 和 \(q\),在 dot product 之后只剩下相对位移 \(p - q\)。
所以 position 10 与 11、position 100 与 101、position 1000 与 1001——在同一 frequency 下,它们的 dot product 完全相同,因为 \(p - q\) 都是 1。
sinusoidal PE 的 geometry 让 relative relation 可以被 dot product 这样的线性操作自然提取出来。它不是显式存储了 \(p - q\),而是构造出来的几何结构让这种 relation 可以被规则地利用。
但这里必须加一个重要的限定。
真实 Transformer 的 attention score 不是直接计算 \(PE(i) \cdot PE(j)\)。实际路径是:
$$ h_i = e_i + PE(i) $$$$ q_i = h_i W_Q, \quad k_j = h_j W_K $$$$ \text{score} = q_i k_j^T $$PE 会经过 learned projection,并且和 semantic content 混在一起。所以不能把真实 attention score 简化成"就是 relative-position cosine”——sinusoidal PE 提供的是一种有利于表达 relative structure 的 positional geometry,不是 attention 的全部。
一个圆有无限多个点#
走到这里我产生了一个困惑,后来发现这个困惑恰好暴露了我对 multi-frequency 设计的误解。
我的问题是:一个圆不是有无限多个点吗?角度是连续的,并不是只有 360 个位置。那为什么一个圆不能表示所有 position?为什么还需要很多个圆?
这个质疑本身是成立的。只使用一个频率 \(\omega\),\([\sin(\omega p), \cos(\omega p)]\) 在数学上确实可以为大量 integer position 提供不同的表示——只要 \(\omega / 2\pi\) 是无理数,integer position 在单位圆上就永远不会精确重合。
所以 multiple frequencies 不是因为一个圆"装不下"更多位置。不是 capacity 问题。
这个认识对我来说是一个转折点,因为我之前隐约以为"多个圆是为了容纳更多位置"。不是的。
多个频率 = 多尺度位置表示#
那为什么还需要多个频率?
假设只有一个频率 \(\omega\)。position 每增加 1,在圆上旋转 \(\omega\)。
如果 \(\omega\) 很大(高频),\(p \to p+1\) 的旋转角度大,局部的 position change 非常明显——local resolution 好。但 position 变化 100 的时候,圆上会绕很多次,从单一 frequency 看,长距离 relation 会出现周期性的模糊。
如果 \(\omega\) 很小(低频),\(p \to p+1\) 只在圆上移动一点点,对 local difference 不够敏感。但在较长 range 内 phase 变化平缓,更适合提供 coarse / long-range 的位置结构。
一个频率只能提供一个观察 position relationship 的尺度。这才是多个频率存在的真正原因。
完整 PE 把很多不同转速的圆拼在一起:
同一个 position 同时在所有 frequency 下都有自己的 phase。最终的 PE 就是这些不同 positional scale 下 observation 的拼接。
用一个比喻来说:想象很多只不同转速的钟。position = 100 的时候,快钟已经转了很多圈,慢钟才转了一小段。完整 PE 记录的是这个 position 在所有钟上的状态。
多个圆不是为了"位置不够放",而是为了"一个频率看 position 的尺度太单一"。
每个 position 同时拥有所有 frequency component——不是每个 frequency 负责某些 position,而是所有 frequency 共同描述同一个 position。
和 FPN 的类比#
这个 multi-scale 的思路让我想到 CV 里的 FPN(Feature Pyramid Network):
FPN 通过不同分辨率的 feature map 同时提供 local detail 和 larger-scale structure。Sinusoidal PE 通过不同频率的 sin/cos 同时提供 fine local positional change 和 coarse long-range positional structure。
两者背后有一个相似的设计思路:不押注单一尺度,同时向下游提供多尺度 representation。
但我想把边界说清楚:这只是 design pattern 层面的类比。FPN 的 multi-scale 来自 spatial resolution 和 receptive field,sinusoidal PE 的 multi-scale 来自 frequency 和 phase。一个是空间的,一个是频率的。机制完全不同,在这里类比的只是"multi-scale representation"这个想法。
PE 固定,用法不固定#
到目前为止,sinusoidal PE 的所有性质——有界、rotation、multi-scale——都是公式本身的数学性质,和训练没有关系。
于是我遇到了下一个问题:PE 完全固定,那 Transformer 到底怎么知道什么时候该更关注 high frequency,什么时候更关注 low frequency?
答案是把 fixed 和 learned 分开看。
token 和 position 相加之后,进入 learned projection:
$$ q_i = (e_i + p_i) W_Q = e_i W_Q + p_i W_Q $$\(p_i\) 是固定的。但 \(W_Q\) 是 learned 的。同理 \(W_K\)、\(W_V\)、FFN 的参数都是 learned 的。
所以可以这样理解:
1Sinusoidal PE = 固定的 frequency basis / features
2Transformer weights = 学习如何 project、mix、使用这些 features
这和 Fourier basis 的直觉有点类似:basis 可以固定,但 how to combine the basis 可以学习。当然不是说 Transformer 在显式做 Fourier series——只是"固定 basis + learned combination"这个模式在这里成立。
另外,我一开始想当然地觉得"不同 token 会选择不同的 frequency",但仔细一想不完全对。\(W_Q\) 等 projection 是跨 token 共享的——所有 token 用同一组 projection weights。
更准确的说法是:不同 attention head、不同 semantic context、不同 token pair 之间的 interaction,可以对不同 positional patterns 表现出不同的 sensitivity。frequency usage 是通过 learned projection、semantic interaction、attention 和 multi-head 隐式实现的,不是每个 token 自己独立选择 frequency。
content 和 position 在 attention 里怎么交互#
把之前学过的 Q/K/V 接回来,看看 content 和 position 在 attention 里到底是什么关系。
令 \(A = W_Q W_K^T\),attention score 可以展开:
$$ (e_i + p_i)\, A\, (e_j + p_j)^T = e_i A e_j^T + e_i A p_j^T + p_i A e_j^T + p_i A p_j^T $$四项分别对应:
- content ↔ content:两个 token 的语义相似性;
- content ↔ position:某种 content 对某个位置的敏感度;
- position ↔ content:某个位置对某种 content 的偏好;
- position ↔ position:纯位置之间的关系。
这四项都经过同一个 learned \(A\)。positional information 不是单独放在旁边被模型查阅的——从 \(e + PE\) 那一刻开始,position 和 semantic content 就共同参与了 learned interaction。
模型最终学到的不只是"这里是 position 7",而是可以形成"某种 semantic pattern 在某种 positional relationship 下是否重要"这样的交互。
再加上 Multi-Head Attention——每个 head 有自己独立的 \(W_Q^{(h)}, W_K^{(h)}, W_V^{(h)}\)——不同 head 可以学习不同的 semantic + positional interaction pattern。一个 head 可能更关注 local relation,另一个可能更容易利用 long-range structure。这不是说每个 head 严格对应一个 frequency band——真实的分工远比这复杂——但 multi-head 确实给了模型同时学习多种 interaction pattern 的自由度。
Learned PE 和 Sinusoidal PE#
写到这里自然要问:既然 learned positional embedding 也能给每个位置一个向量,而且效果和 sinusoidal PE 接近(原始 Transformer paper 里的实验结论),那两者的区别到底在哪?
1Learned PE:position → embedding table → learned vector
2Sinusoidal PE:position → deterministic sin/cos → fixed structured vector
Learned PE 把更多 positional structure 交给训练过程自己发现。Sinusoidal PE 预先提供了 smooth、structured、multi-frequency 的 positional geometry。
一个经常被提到的 sinusoidal PE 优势是:它可以在数学上为训练时没见过的 position 生成 PE vector——只要代入公式就行。但我觉得需要加一个限定:能生成 PE(position) 不等于整个模型已经学会对未见长度正常泛化。 PE 只是 Transformer 的输入之一,后面的所有 learned weights 都是在训练分布上拟合的。
所以 sinusoidal PE 的真正特点不在于"可以 extrapolate",而在于它从一开始就提供了一种有结构的 positional representation:bounded、smooth、rotation-equivariant、multi-scale。Learned PE 当然也可能在训练中发现类似的结构,但那是训练的结果而不是设计的保证。
小结#
这篇从"标量整数如何变成向量"走到了"为什么需要构造相对几何与多尺度结构"。回头看,整条线索可以压缩成几句话:
- PE 不是在发现 position,是在把已知的 integer position 编码成 vector representation。
- 随便给个固定随机向量只能解决 identity(区分位置),无法提供 geometry(相对距离与顺序);Sinusoidal PE 的根本追求是提供内建的相对位置几何。
- 一对 \([\sin(\omega p), \cos(\omega p)]\) 构成单位圆上的一个 phase,position 增加对应 rotation。
- 相同的 relative displacement 在同一 frequency 下对应相同大小的 rotation,这让 sinusoidal PE 的 geometry 天然有利于表达 relative structure。
- 多个 frequency 不是为了增加 position capacity——一个圆已经有无限多个点。多个 frequency 是为了提供多尺度 positional features:高频看 local,低频看 long-range。
- PE 有界在 \([-1,1]\),position 信息在 phase 而不在 magnitude。
- fixed PE 不等于 fixed usage——Transformer 通过 learned projection、attention interaction 和 multi-head 来学习如何使用这些固定的 frequency basis。
Sinusoidal PE 建立的这套思路——position 对应 phase,relative displacement 对应 rotation——后来在 RoPE(Rotary Position Embedding)中被更直接地使用:RoPE 把 position-dependent rotation 直接作用在 Q 和 K 上,而不是加在 embedding 里。但那是下一篇的事了。
参考资料#
- Vaswani et al., Attention Is All You Need — https://arxiv.org/abs/1706.03762
- MIT 6.S191, Introduction to Deep Learning — https://introtodeeplearning.com/
- 去掉 RNN 之后,顺序去哪了?
- 从动态读取到 QKV:Self-Attention 的公式是怎么长出来的
- 一组 QKV 就够了吗:Multi-Head Attention 到底在拆什么