起因#
最近在看 GAN 的时候,判别器的训练目标里反复出现两项:
\(\log D(x)\) 和 \(\log(1 - D(G(z)))\)
我能看出 \(\log D(x)\) 越大越好——\(D(x)\) 越接近 1,判别器越确信这是真实样本。也能看出 \(\log(1-D(G(z)))\) 在 \(D(G(z))\) 接近 0 的时候最大——判别器越确信生成的是假样本。
但有一件事我说不清楚:为什么一开始就应该写成带 log 的式子?
把 GAN 放一边,回到更基本的场景。二分类模型输出一个概率 \(p\),训练时用的损失是 Binary Cross Entropy:
$$ \mathcal{L} = -[y \log p + (1-y) \log(1-p)] $$这个公式我以前直接当工具用,但如果有人问我:里面每一项是什么?为什么是 log?为什么有负号?为什么不是别的形式?我都答不上来。
之前写 NTP 那篇的时候,在最后一步写了"负对数似然等价于 cross entropy loss",但没有展开推导。这篇就从这里接上,把背后的推导从头走一遍。
我需要搞清楚几件事:
- \(p\) 和 \(y\) 各是什么?
- “给真实标签分配概率"是什么意思?
- 似然和概率有什么区别?
- 为什么要取 log?
- 为什么最后要加负号?
- 十次试验七次成功,为什么估计 \(\hat{p} = 0.7\)?
一次只有两种结果的试验#
从最简单的情况开始。
抛一枚硬币,只有两种结果:正面或反面。用 1 表示正面,0 表示反面。
在抛之前,结果是不确定的。用 \(Y\) 表示这个尚未揭晓的随机变量:
$$ Y \in \{0, 1\} $$假设出现正面(\(Y = 1\))的概率是 \(p\),那么出现反面(\(Y = 0\))的概率就是 \(1 - p\):
$$ P(Y = 1) = p, \quad P(Y = 0) = 1 - p $$这就是 Bernoulli Distribution(伯努利分布)。记作 \(Y \sim \text{Bernoulli}(p)\)。
几个需要区分的东西:
- \(Y\):随机变量,表示"结果还没出来"这件事。
- \(y\):实际观察到的值,要么是 0,要么是 1。
- \(p\):模型参数,表示结果为 1 的概率。硬币可能不均匀,\(p\) 不一定是 0.5。
- \(p = 0.7\) 不意味着下一次一定出正面。它只是说正面比反面更可能出现。
把上面两行合成一个表达式:
$$ P(Y = y \mid p) = p^{y}(1 - p)^{1 - y} $$第一次看到这个写法我觉得有点故弄玄虚。但代入验证一下就知道它在做什么。
当 \(y = 1\):
$$ p^1 \cdot (1-p)^0 = p \cdot 1 = p $$当 \(y = 0\):
$$ p^0 \cdot (1-p)^1 = 1 \cdot (1-p) = 1-p $$和分开写的两行完全一样。指数 \(y\) 和 \(1 - y\) 的作用就是一个开关:\(y = 1\) 时,\(p\) 那一项打开、\(1-p\) 那一项关掉;\(y = 0\) 时反过来。
这里有一个需要注意的地方。\(P(Y = y \mid p)\) 是一个离散概率——\(Y\) 只取 0 或 1,每个取值对应一个确定的概率值。这和连续随机变量的概率密度不同,后者单点概率为 0,需要靠密度乘以区间宽度才能得到概率。
同一个算式,换一个提问方向#
继续用同一个表达式 \(P(Y = y \mid p) = p^y(1-p)^{1-y}\),但换一种问法。
问法一:已知参数,预测数据。
假设这枚硬币正面概率是 \(p = 0.7\)。还没有抛。问下一次出正面的概率是多少。
$$ P(Y = 1 \mid p = 0.7) = 0.7 $$这就是普通的概率计算:参数确定了,看不同结果各有多大的可能性。
问法二:已经看到数据,比较参数。
硬币已经抛了,结果是正面(\(y = 1\))。现在不确定的是硬币的参数 \(p\)。
如果 \(p = 0.7\):
$$ P(Y = 1 \mid p = 0.7) = 0.7 $$如果 \(p = 0.2\):
$$ P(Y = 1 \mid p = 0.2) = 0.2 $$数据固定是 \(y = 1\)。用同一个公式,代入不同的 \(p\),看谁算出来的值更高。\(p = 0.7\) 给这份数据分配了 0.7 的概率,\(p = 0.2\) 只给了 0.2。
在第二种问法里,算出来的这个值就叫 Likelihood(似然)。
Likelihood 这个词第一次碰到时我觉得很抽象。后来找到一句英文说法比较好理解:
“The likelihood of the observed data under this model.”
翻译成中文:如果这个模型(这个 \(p\))是真的,已经看到的这份数据有多容易出现?
“似然"不是一个很直观的中文词。可以暂时理解成"候选参数给已观察数据的评分”——\(p = 0.7\) 给正面这个数据打了 0.7 分,\(p = 0.2\) 打了 0.2 分。
但这个评分是由参数给数据分配的概率计算出来的,不能反过来理解成"参数本身的概率”。
$$ P(\text{数据} \mid p) \neq P(p \mid \text{数据}) $$左边是似然——给定参数 \(p\),数据出现的概率。右边是后验概率——在看到数据之后,参数 \(p\) 为真的概率。这是完全不同的两件事。后者属于贝叶斯统计的范畴,这里不展开。
Maximum Likelihood Estimation(最大似然估计,简称 MLE)做的是:在所有候选的 \(p\) 值里,找到那个让已观察数据的似然最大的 \(p\)。它最大化的是左边,不是右边。
多次独立观察#
一次抛硬币的信息量太少。抛一次出了正面,\(p = 0.999\) 给的似然比 \(p = 0.7\) 还高,但不能因此认为硬币几乎一定出正面。
多抛几次。
假设抛了三次,结果依次是 1, 0, 1。如果每次抛掷独立,而且每次正面的概率都是同一个 \(p\),那么这个具体序列的概率是三次概率的乘积:
$$ P(1, 0, 1 \mid p) = p \cdot (1-p) \cdot p = p^2(1-p) $$推广一下。抛 \(n\) 次,观察到 \(k\) 个 1(正面)和 \(n - k\) 个 0(反面)。这条已观察的具体序列的似然:
$$ L(p) = p^k (1-p)^{n-k} $$这里发生了三件事。
第一,各次抛掷独立,所以各次的概率可以相乘。如果抛掷之间有依赖——比如上一次出正面会影响下一次的概率——乘积就不成立了。
第二,每次抛掷共享同一个 \(p\),所以所有 \(p\) 可以合并成 \(p^k\),所有 \(1-p\) 可以合并成 \((1-p)^{n-k}\)。
第三,上面写的是特定序列 1, 0, 1 的概率,不是"三次里恰好出现两次正面"的概率。如果问后者——不论顺序,恰好出现 \(k\) 次正面——还需要乘以组合数 \(\binom{n}{k}\),因为有多种不同的序列都能产生 \(k\) 次正面。但在最大似然估计里,\(\binom{n}{k}\) 是一个不依赖 \(p\) 的常数,不影响哪个 \(p\) 使似然最大。
为什么要取对数#
把似然取对数,记为 Log-Likelihood(对数似然):
$$ \ell(p) = \log L(p) = k \log p + (n-k) \log(1-p) $$为什么要多这一步?我最初以为是"不取 log 就没法对 \(p\) 求导",但那是错的——\(p^k(1-p)^{n-k}\) 完全可以直接求导。取 log 的动机是别的。
对数是严格单调递增函数。 如果 \(a \gt b \gt 0\),那么 \(\log a \gt \log b\)。所以最大化 \(L(p)\) 和最大化 \(\log L(p)\) 会得到同一个最优 \(p\)。取对数不改变答案。
乘积变成求和。 \(\log(ab) = \log a + \log b\)。\(n\) 个样本的似然是 \(n\) 个概率的乘积,取对数后变成 \(n\) 项之和。求和无论是写出来、求导还是在程序里实现,都比连乘方便。
数值稳定性。 很多小于 1 的概率连乘,结果会迅速趋向零。比如 100 个样本,每个概率是 0.7,连乘得到 \(0.7^{100} \approx 3.2 \times 10^{-16}\),在计算机里接近浮点数下溢的边界。取对数后变成 \(100 \times \log(0.7) \approx -35.7\),是一个正常大小的数。
\(-\log p\) 对极端错误给出很大的惩罚。 这个性质在训练中很有用。
假设模型预测某个事件发生的概率是 \(p = 0.9\),然后这件事确实发生了:
$$ -\log(0.9) \approx 0.105 $$损失很小。模型预测得不错。
假设模型预测 \(p = 0.01\),但事件还是发生了:
$$ -\log(0.01) \approx 4.605 $$损失猛增到 40 多倍。模型给实际发生的事件只分配了 1% 的概率,\(-\log\) 会给出一个很大的惩罚。越是自信地犯错,惩罚越重。
十次试验七次正面#
现在用一个具体例子把前面的东西串起来。
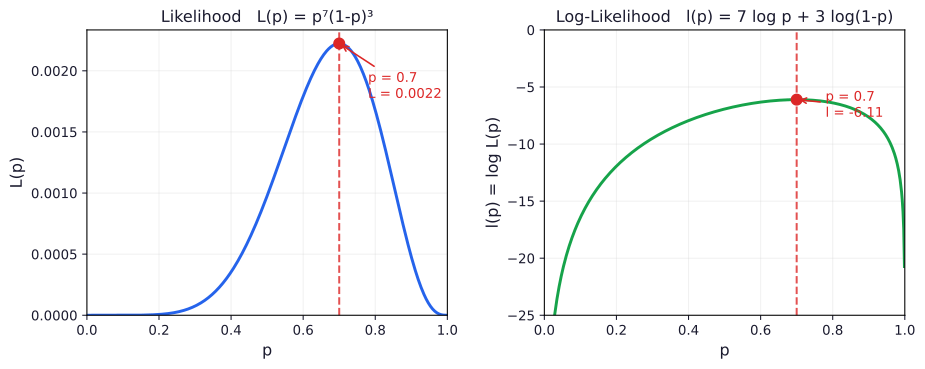
抛 10 次硬币(\(n = 10\)),7 次正面(\(k = 7\))。
似然函数:
$$ L(p) = p^7(1-p)^3 $$对数似然:
$$ \ell(p) = 7\log p + 3\log(1-p) $$先用直觉想。\(p\) 应该取多少?
\(p\) 太低不行。比如 \(p = 0.1\),\(L(0.1) = 0.1^7 \times 0.9^3 \approx 7.3 \times 10^{-8}\)。正面概率才一成,要出现 7 次正面几乎不可能。
\(p\) 太高也不行。比如 \(p = 0.99\),\(L(0.99) = 0.99^7 \times 0.01^3 \approx 9.3 \times 10^{-7}\)。正面概率高达 99%,但还是出现了 3 次反面,这同样很难解释。
最优的 \(p\) 要同时兼顾这 7 次正面和 3 次反面。
求导。对一般的 \(0 \lt k \lt n\):
$$ \ell'(p) = \frac{k}{p} - \frac{n-k}{1-p} $$导数在这里的含义是:\(p\) 稍微增大一点点时,对数似然会怎么变。\(\ell'(p) \gt 0\) 说明 \(p\) 增大时 \(\ell\) 在上升,\(\ell'(p) \lt 0\) 说明在下降。
令导数为零:
$$ \frac{k}{p} = \frac{n-k}{1-p} $$交叉相乘:
$$ k(1-p) = (n-k)p $$展开:
$$ k - kp = np - kp $$两边的 \(-kp\) 消掉:
$$ k = np $$$$ \hat{p} = \frac{k}{n} $$代入 \(n = 10, k = 7\):\(\hat{p} = 0.7\)。
这确实是最大值,不只是一个驻点。看导数的符号:当 \(p \lt k/n\) 时,分子 \(k/p\) 大于分母 \((n-k)/(1-p)\),\(\ell'(p) \gt 0\),对数似然在上升。当 \(p \gt k/n\) 时,\(\ell'(p) \lt 0\),在下降。先升后降,中间的驻点就是最大值。
两个边界情况需要单独处理。
\(k = 0\)(全是反面):对数似然变成 \(\ell(p) = n\log(1-p)\)。这是 \(p\) 的严格递减函数,\(p\) 越小越好。最大值在 \(p \to 0\) 时趋近取到。\(\log p\) 这一项消失了,因为没有任何正面需要解释。
\(k = n\)(全是正面):对数似然变成 \(\ell(p) = n\log p\)。严格递增,最大值在 \(p \to 1\) 时趋近取到。
这和 \(\hat{p} = k/n\) 的公式一致:\(k = 0\) 时 \(\hat{p} = 0\),\(k = n\) 时 \(\hat{p} = 1\)。
最后要强调一件事。“样本中 70% 是正面"和"硬币真实的正面概率已被证明是 70%“不是一回事。 \(\hat{p} = k/n\) 是在给定模型假设(每次独立、同一个 \(p\))下,从有限数据得到的最大似然估计。如果只抛了 10 次,硬币真实的 \(p\) 完全可能是 0.6 或 0.8,而 \(\hat{p} = 0.7\) 只是当前数据下最能自圆其说的那个估计值。
单条样本的负对数似然#
前面用了 \(n\) 次试验推导最大似然估计。现在回到最小的单元:一条样本。
一次伯努利试验的概率:
$$ P(Y = y \mid p) = p^y(1-p)^{1-y} $$取对数:
$$ \log P(Y = y \mid p) = y\log p + (1-y)\log(1-p) $$训练时通常写成最小化损失,所以取负号:
$$ \mathcal{L}_{\text{BCE}}(y, p) = -[y\log p + (1-y)\log(1-p)] $$代入 \(y = 1\):损失 \(= -\log p\)。
代入 \(y = 0\):损失 \(= -\log(1-p)\)。
用 \(p = 0.8\) 检查一下。
真实标签 \(y = 1\),模型输出 \(p = 0.8\):
$$ -\log(0.8) \approx 0.223 $$损失不大。模型认为正面的概率是 0.8,实际确实是正面。
真实标签 \(y = 0\),模型输出 \(p = 0.8\):
$$ -\log(1 - 0.8) = -\log(0.2) \approx 1.609 $$损失大得多。模型认为正面的概率高达 0.8,但实际是反面。
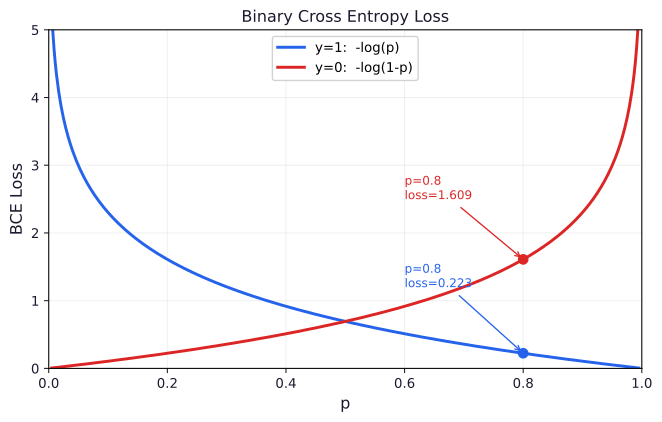
这个损失函数叫 Binary Cross Entropy(二元交叉熵),简称 BCE。对于取值为 0 或 1 的真实标签,BCE 在形式上就是伯努利分布的负对数似然。公式里的每一项都可以追溯到伯努利概率的统一表达式。
这里有一个误解需要消除。前面推导 \(\hat{p} = k/n\) 时,假设了 \(n\) 次试验共享同一个 \(p\)。但实际的二分类模型不是这样——不同的输入 \(x_i\) 会产生不同的预测概率 \(p_i\)。
这两件事不矛盾。对于每一条样本 \((x_i, y_i)\),模型输出一个 \(p_i\),标签是 \(y_i\)。可以分别计算每条样本的伯努利负对数似然,然后求和或取平均:
$$ \mathcal{L} = -\frac{1}{N}\sum_{i=1}^{N}[y_i\log p_i + (1-y_i)\log(1-p_i)] $$每个 \(p_i\) 可以不同。BCE 的成立不要求所有样本共享同一个成功概率。 它只要求每条样本各自服从一个伯努利分布——标签是 0 或 1,模型给出的 \(p_i\) 是对该样本标签为 1 的概率估计。
直接奖励正确标签的概率会怎样#
前面解释了取 log 的几个动机:不改变最优参数、乘积变求和、数值稳定。但还有一个问题我觉得值得单独拿出来说:如果不用 log,直接最大化"模型给正确标签分配的概率”,会怎样?
这需要区分两个不同的场景。
场景一:手上有一份固定的数据集,要找最优参数。
比如 10 次抛硬币,7 次正面。最大化 \(L(p) = p^7(1-p)^3\) 和最大化 \(\log L(p)\) 得到同一个 \(\hat{p} = 0.7\)。这是 log 的单调性保证的——取不取 log,答案一样。
场景二:模型部署后,长期面对来自同一分布的数据。
这个场景揭示了一个不同层面的问题。
假设在相同条件下,真实的标签为 1 的概率是 \(q = 0.7\)。模型始终输出一个固定的概率预测 \(p\)。每次来一个样本,标签以概率 \(q\) 为 1、以概率 \(1-q\) 为 0。
如果用"模型给正确标签分配的概率"作为评分,单次得分是:
- 标签为 1(概率 \(q\))时,得分 \(p\)
- 标签为 0(概率 \(1-q\))时,得分 \(1-p\)
长期平均得分:
$$ S_{\text{lin}}(p) = q \cdot p + (1-q)(1-p) $$代入 \(q = 0.7\):
$$ S_{\text{lin}}(p) = 0.7p + 0.3(1-p) = 0.4p + 0.3 $$这是 \(p\) 的线性函数,\(p\) 越大得分越高。最大值在 \(p = 1\) 取到。
问题来了。真实概率是 \(q = 0.7\),但这个评分标准鼓励模型报 \(p = 1\)——永远说"一定是正面”。模型不需要诚实地报告不确定性,只要把多数类别的概率拉满就行。
代入几个数字感受一下。
\(p = 0.7\)(诚实报告):\(S_{\text{lin}} = 0.4 \times 0.7 + 0.3 = 0.58\)。
\(p = 1.0\)(极端预测):\(S_{\text{lin}} = 0.4 \times 1.0 + 0.3 = 0.70\)。
极端预测得分更高。这个评分标准在惩罚诚实。
换成对数评分。长期平均得分:
$$ S_{\text{log}}(p) = q\log p + (1-q)\log(1-p) $$代入 \(q = 0.7\):
$$ S_{\text{log}}(p) = 0.7\log p + 0.3\log(1-p) $$用前面一样的方法求导:
$$ S_{\text{log}}'(p) = \frac{0.7}{p} - \frac{0.3}{1-p} $$令导数为零:\(0.7(1-p) = 0.3p\),解得 \(p = 0.7 = q\)。
对数评分的最大值恰好在 \(p = q\) 处取到。
验算几个具体数字。
\(p = 0.7\)(诚实报告):
$$ S_{\text{log}}(0.7) = 0.7 \times \log(0.7) + 0.3 \times \log(0.3) \approx 0.7 \times (-0.357) + 0.3 \times (-1.204) \approx -0.611 $$\(p = 0.9\)(偏高):
$$ S_{\text{log}}(0.9) = 0.7 \times \log(0.9) + 0.3 \times \log(0.1) \approx 0.7 \times (-0.105) + 0.3 \times (-2.303) \approx -0.765 $$\(p = 1\)(极端):
$$ S_{\text{log}}(1) = 0.7 \times \log(1) + 0.3 \times \log(0) = 0 + (-\infty) = -\infty $$\(-0.611 \gt -0.765 \gt -\infty\)。诚实报告的得分最高。
这意味着:在模型假设正确、数据足够多的条件下,对数评分会鼓励模型报告真实概率,而不仅仅是猜对多数类别。 统计学里把这个性质叫做 proper scoring rule(合适评分规则)。
但这件事不能说得太绝对。对数评分不是唯一具备这个性质的评分方法。比如 Brier score \(-(y - p)^2\) 也是 proper scoring rule。取 log 不是"唯一能训练出概率"的选择。
所以取 log 带来的好处实际上有两个层面,而且它们是独立的:
- 对同一份固定数据,取 log 不改变最大似然参数(单调性),但计算上更方便(乘积变求和,数值更稳定)。
- 放到长期重复观测的场景下,对数评分还有一个额外的性质:它鼓励模型诚实地报告预测概率,而不只是猜对最可能的类别。
回到 GAN 判别器#
最后回到最初的问题。
GAN 的判别器就是一个二分类器。约定真实样本的标签 \(y = 1\),生成样本的标签 \(y = 0\)。判别器输出 \(D(x)\),表示它认为输入 \(x\) 是真实样本的概率。
把这个套进伯努利对数似然。
对真实样本 \(x \sim p_{\text{data}}\),标签 \(y = 1\):
$$ \log P(y=1 \mid D(x)) = \log D(x) $$对生成样本 \(x = G(z)\),标签 \(y = 0\):
$$ \log P(y=0 \mid D(G(z))) = \log(1 - D(G(z))) $$判别器的训练目标是最大化这两项。第一项推动 \(D(x)\) 接近 1——正确识别真实样本。第二项推动 \(D(G(z))\) 接近 0——正确识别生成样本。
在看 GAN 之前,我只能从 log 的单调性看出优化方向——“最大化 \(\log D(x)\) 会让 \(D(x)\) 变大”。现在从伯努利对数似然的角度看,这个目标不是凭空冒出来的:它就是判别器作为二分类器的最大似然目标,每一项都对应一个伯努利标签的对数概率。
参考资料#
- Next-Token Prediction:语言模型的训练目标从哪来 — cross entropy 与 negative log-likelihood 的上下文
- 概率密度不是概率:连续随机变量为什么需要 PDF — 离散伯努利概率 vs 连续情况的概率密度
- 从 Forward 到 Optimizer:再看一遍 Training Loop — loss 在训练循环中的角色
- Christopher Bishop, Pattern Recognition and Machine Learning, Chapter 4.3.6
- MIT 6.S191: Introduction to Deep Learning — https://introtodeeplearning.com/