起因#
上一篇结尾留了一个问题:Pre-training Loss 通常随模型规模平滑改善,但一些下游 benchmark 上的准确率似乎在某个规模区间突然大幅提升。
当时看到这个现象的第一反应是:该不会模型大到一定程度,内部真的"涌现"出了某种新能力吧?
MIT 6.S191 Lecture 6 在介绍完 Scaling Laws 之后紧接着讲了这个话题,还引用了一篇 2023 年的论文,说这些所谓的涌现能力可能只是评价指标造成的幻觉。
这让我很好奇。到底哪边说得对?我花了几天把相关论文读了一遍,发现这个问题比"是"或"不是"都要复杂得多。
为什么有人认为大模型会出现涌现能力?#
先看现象。
2022 年 Wei 等人在 Emergent Abilities of Large Language Models 里报告了一组观察:在若干 benchmark 上,小模型(比如参数量在几十亿以下)的准确率几乎是零或随机水平,但模型参数量增大到某个范围之后,准确率突然大幅提升。
他们给出的 Emergent Abilities 定义大致是:在小模型中不存在、但在大模型中出现的能力。
一些代表性的例子包括:多步算术推理、某些 few-shot 任务、需要特定推理链才能完成的问题。在 PaLM(540B)上能做对的事,PaLM(62B)完全做不到。
这些结果引发了很多讨论。一些人认为这说明模型内部发生了某种"相变"——类似物理学中水结冰的相变,达到某个临界规模后,模型突然获得了新的计算能力。
但需要注意一个很容易忽略的区分:“某种能力只在大模型中被观察到"和"模型内部突然产生了新的计算机制"是两件不同的事情。 前者是经验观察,后者是因果解释。
49% 与 51% 有什么本质区别?#
我开始理解这个问题,是从一个非常简单的例子出发的。
假设有一道封闭的二选一题目:
1 + 1 等于 2 还是 3?
模型需要从候选答案 2 和 3 里选一个。为了简化,假设模型只会输出这两个选项之一。
不同规模的模型对正确答案 2 的预测概率可能是这样的:
| 模型 | P(2) | P(3) | Greedy 输出 |
|---|---|---|---|
| 1B | 40% | 60% | 3(错) |
| 3B | 45% | 55% | 3(错) |
| 7B | 49% | 51% | 3(错) |
| 13B | 51% | 49% | 2(对) |
| 30B | 55% | 45% | 2(对) |
这里的 P(2) 是模型给候选答案 2 分配的概率。Greedy Decoding 就是选概率最大的那个答案输出。
关键在于 7B 和 13B 之间发生了什么:P(2) 从 49% 变到了 51%,跨过了 50% 的边界。在概率层面只是一个很小的改善,但 Greedy Decoding 的输出从错变对。
需要说清楚的是,50% 这个边界是二选一假设的产物。如果候选答案有四个,边界就是 25%(或者更复杂的情况,取决于其他选项的概率分布)。一般 LLM 的解码过程并不存在一个固定的 50% 阈值。
现在对比两种评价方式:
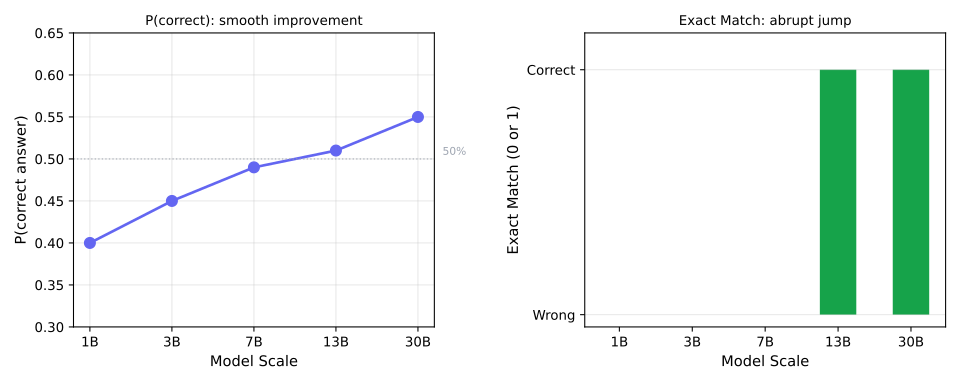
左图是正确答案的预测概率,从 40% 平滑上升到 55%——模型一直在持续改善。右图是 Exact Match,从 0 突然跳到 1——看起来像是"涌现”。
同一个模型的同一段改善过程,用不同的指标观察,呈现出完全不同的曲线形态。 连续的概率改善,经过 Greedy Decoding 的离散决策和 Exact Match 的二值评价之后,变成了一次跳变。
评价指标放大了什么?#
2023 年 Schaeffer 等人在 Are Emergent Abilities of Large Language Models a Mirage? 里系统地提出了这个质疑。
他们的核心论点是:很多被报告为"涌现"的现象,可能是评价指标本身的性质制造的。特别是 Exact Match 这类非线性的、离散的指标。
如果换用其他指标来看同一组实验:
| 指标 | 特点 |
|---|---|
| Exact Match | 只看最终答案是否完全正确,0 或 1 |
| Token-level Accuracy | 看回答中每个 token 的正确率 |
| Edit Distance | 看回答与标准答案之间的编辑距离 |
| Log-Likelihood | 看正确答案的对数概率 |
用 Token-level Accuracy 或 Log-Likelihood 衡量,原本在 Exact Match 上看起来像突变的曲线,可能变得平滑得多。
但这不意味着 Exact Match 是一个"错误"的指标。对于数学问题,最终答案是对是错本来就是最重要的——一道数学题写对了 80% 的步骤但最终答案错了,从使用者的角度看仍然是失败的。对代码生成也是一样:通过测试或不通过测试,没有中间状态。
问题在于:任务成功率的突然提升,能不能作为"模型内部突然产生了新能力"的证据?
从上面 49% → 51% 的例子来看,显然不够。模型可能一直在平稳改善,只是碰巧在某个规模跨过了决策边界。
如果有 1000 道题呢?#
到这里我觉得自己理解了。但随即冒出来一个更深的疑问:
上面的例子是一道题。一道题的 Exact Match 确实会因为跨过 50% 而跳变。但真实的 benchmark 通常有几百甚至上千道题。如果有 1000 道题,每道题的决策边界不太可能在同一个模型规模上同时被跨过。求完平均之后,整体 Accuracy 难道不会变得很平滑吗?
形式化地写一下。假设每道题 \(i\) 在模型规模 \(N\) 下的得分是:
$$ a_i(N) \in \{0, 1\} $$整体准确率是:
$$ \text{Accuracy}(N) = \frac{1}{M}\sum_{i=1}^{M} a_i(N) $$如果 1000 道题的"翻转阈值"(从错到对的模型规模)均匀分布在 1B 到 100B 之间,那么随着 \(N\) 增大,每个区间都有几道题翻转,整体 Accuracy 会近似线性地爬升——看不到突变。
但如果这些阈值集中在一个较窄的区间呢?比如说 1000 道题中有 600 道的翻转阈值落在 10B 到 20B 之间,那么模型从 10B 扩展到 20B 时,Accuracy 会在这个区间内快速上升。
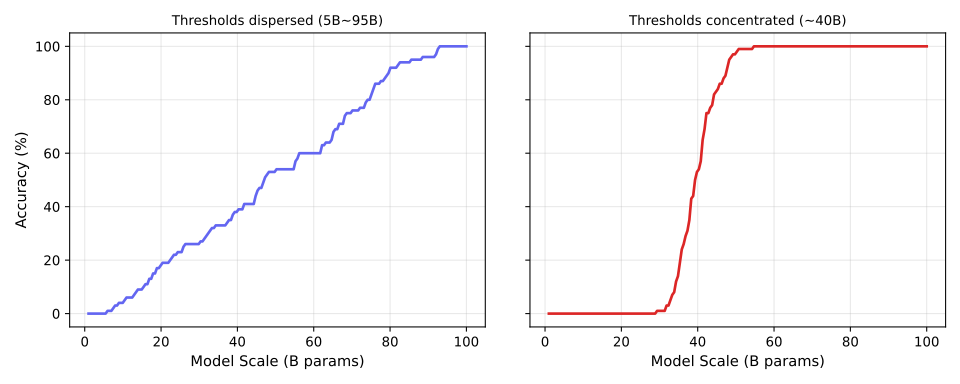
左图:阈值分散,整体 Accuracy 平滑爬升。右图:阈值集中在 40B 附近,Accuracy 在该区间快速上升。
1000 道题的阈值不需要完全相同。只要集中在一个较窄的区间内,整体 Accuracy 就可能表现出明显的非线性增长。
而阈值集中这件事并非不合理——如果一组题目共享某些底层技能(比如都需要三位数加法能力,或者都需要理解否定句),那么这些题目的翻转阈值可能天然就落在相近的规模范围内。
复杂任务为什么更容易呈现非线性?#
还有一个角度可以解释为什么某些任务看起来更像"涌现"。
假设一个问题需要模型连续完成 10 个推理步骤,只有全部正确才算成功。如果每一步的成功概率是 \(p\),并且假设各步骤独立,那么整体成功率是:
$$ P(\text{all correct}) = p^{10} $$看几组数字:
| 单步成功率 \(p\) | 整体成功率 \(p^{10}\) |
|---|---|
| 60% | 约 0.6% |
| 70% | 约 2.8% |
| 80% | 约 10.7% |
| 90% | 约 34.9% |
| 95% | 约 59.9% |
\(p\) 从 60% 提升到 95%,改善幅度不到一倍。但 \(p^{10}\) 从 0.6% 跳到 59.9%,变化了两个数量级。
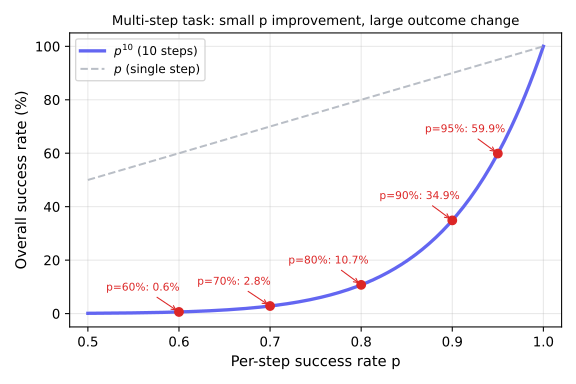
模型的局部能力(单步准确率)可能在持续、平稳地改善。但如果任务需要多个步骤全部成功,整体成功率会呈现明显的非线性——在 \(p\) 较低时几乎为零,在 \(p\) 较高时迅速攀升。
不过必须说明:真实 LLM 的推理步骤通常不满足独立性假设。前面步骤的输出是后续步骤的输入,错误可能传播也可能被纠正。\(p^{10}\) 只是一个教学模型,用来说明"局部平稳改善如何在多步聚合后呈现非线性"这个机制。而且 \(p^{10}\) 本身是一个连续函数,并不存在数学意义上的不连续点——它只是变化很陡。
涌现能力是否真的被否定了?#
读完 Schaeffer 的论文之后,如果得出"所有 Emergent Abilities 都是指标的幻觉"这个结论,那也走得太远了。
2024 年 Du 等人在 Understanding Emergent Abilities of Language Models from the Loss Perspective 里做了更细致的分析。他们发现:一些下游任务的准确率确实与 Pre-training Loss 存在非常密切的关系,而且在 Loss 降低到某个阈值附近时,任务成功率会出现快速上升。这种阈值行为不完全能用 Exact Match 的离散性来解释——即使换用连续指标,某些任务上也观察到了类似的非线性。
所以需要区分清楚三个不同的问题:
- 任务成功率是否突然改善? 在一些 benchmark 上确实观察到了这种现象。
- 模型在连续评价指标上的表现是否也发生快速变化? 需要具体任务具体分析,不能一概而论。
- 模型内部是否真的形成了新的计算机制? 仅凭 Accuracy 曲线的形状,无论用什么指标,都不足以回答这个问题。这需要独立的因果性证据——比如 Mechanistic Interpretability 那一套方法。
第三个问题是最根本的,也是目前最没有定论的。观察到一个新能力在大模型中"变得可用",和证明"模型内部的计算过程发生了质变",之间还有很长的距离。
写在最后#
回到最开始的疑问:大模型的能力是不是真的会"涌现"?
我现在的理解是,需要看"涌现"这个词指什么。
如果"涌现"指的是:某些任务的成功率在模型规模增大时快速改善—— 这在很多 benchmark 上确实可以观察到,虽然一部分可以用评价指标的离散性来解释,但不是全部。
如果"涌现"指的是:模型内部在某个规模突然产生了全新的计算机制—— 这目前没有充分的证据支持,也没有被彻底否定。仅靠 Accuracy 曲线上的跳变不能证明这一点。
对我来说,这次阅读最有价值的不是某个具体结论,而是几个可以迁移到其他问题的思考习惯:
模型行为与评价指标不是一回事。 你观察到的曲线形状,同时受到模型本身和评价方式的影响。
单题的跳变不等于整体 benchmark 必然跳变。 大量题目的门槛分布决定了整体指标可能有多平滑。但如果题目共享底层技能,阈值可能集中,非线性仍然可能出现。
观察到新能力变得可用,不等于证明内部机制突然产生。 从行为到机制的推断需要独立的因果性证据。
最后回头连一下 Scaling Laws 那篇的结论:Pre-training Loss 的平滑改善,与下游能力的非线性变化,可以同时成立。 两者并不矛盾——Loss 是一个连续的统计量,下游任务成功率经过了任务特定的评价标准和多步推理的聚合,呈现不同的曲线形态是完全可能的。
参考资料#
- Wei et al., Emergent Abilities of Large Language Models, 2022 — https://arxiv.org/abs/2206.07682
- Schaeffer et al., Are Emergent Abilities of Large Language Models a Mirage?, 2023 — https://arxiv.org/abs/2304.15004
- Du et al., Understanding Emergent Abilities of Language Models from the Loss Perspective, 2024 — https://arxiv.org/abs/2403.15796
- Scaling Laws:为什么可以用小模型预测大模型?Chinchilla 又改变了什么?
- 从 Pre-training 到 Post-training:为什么大模型需要分阶段训练?