起因#
上一篇理清了 Pre-training 和 Post-training 的关系——Pre-training 让模型学会语言建模,SFT 和 RLHF 再让它学会遵循指令。
写完那篇之后,我回过头来想一个更上游的问题:Pre-training 本身应该怎么做?具体来说,假设手里有一笔固定的训练预算(比如一定数量的 GPU 时间),我应该训一个多大的模型、喂多少数据?
以前做 CV 的时候,这类决策基本靠经验加试错:先跑几组小实验,观察 loss 曲线和验证集指标,再决定要不要加大模型。到了 LLM 时代,一次 pre-training 动辄几百万美元,试错的代价完全不一样了。
MIT 6.S191 Lecture 6 提到了 Scaling Laws 和 Chinchilla,说的就是这件事。我花了些时间把几篇关键论文的核心结论理了一遍,发现里面有些东西比想象中更微妙。
模型变大,效果究竟能提高多少?#
先从一个简单的假设开始。
假设我已经训了三个不同参数量的语言模型:1B、4B、16B。每个模型的 Validation Loss 都记录下来了。现在准备训一个 64B 的模型,问题是:
在真正花钱训练 64B 模型之前,能不能根据前三个模型的结果,大致预测它的 Loss?
传统的做法是:不知道,只能训了才知道。
但 2020 年 Kaplan 等人在 OpenAI 发表的 Scaling Laws for Neural Language Models 里给出了一个不太一样的回答:在一定条件下,模型参数量、训练数据量、计算量与 Pre-training Loss 之间存在近似的幂律关系,而且这种关系在一定范围内具有可外推性。
这件事的意义不在于"模型越大效果越好"——这个结论其实不需要 Scaling Laws 就能观察到。真正有价值的是"好多少"在一定条件下可以预测。
Scaling Laws 里的三个变量#
Scaling Laws 研究的核心是三个变量之间的关系:
| 符号 | 含义 |
|---|---|
| \(N\) | 模型参数量(Model Parameters) |
| \(D\) | 训练处理的 Token 数(Training Tokens) |
| \(C\) | 训练计算量(Training Compute,通常用 FLOPs 衡量) |
补充几个容易混淆的单位:1B = 10 亿参数,1T = 1 万亿。1T Tokens 不等于 1TB 的文本文件大小,也不等于 1 万亿个完整的英文单词——一个 token 大约是 0.75 个英文单词或 2-3 个字节。
Kaplan 等人发现,当只看参数量 \(N\) 对 Loss 的影响时(假设训练数据充分),可以用一个简化的幂律来描述:
$$ L(N) = L_{\infty} + \frac{A}{N^{\alpha}} $$直觉上,\(L_{\infty}\) 是一个不可消除的基础 loss(数据本身的噪声和不确定性),\(A / N^{\alpha}\) 是随参数量增大而逐渐缩小的"可改善部分"。\(\alpha\) 是一个正的指数,决定了改善的速度。
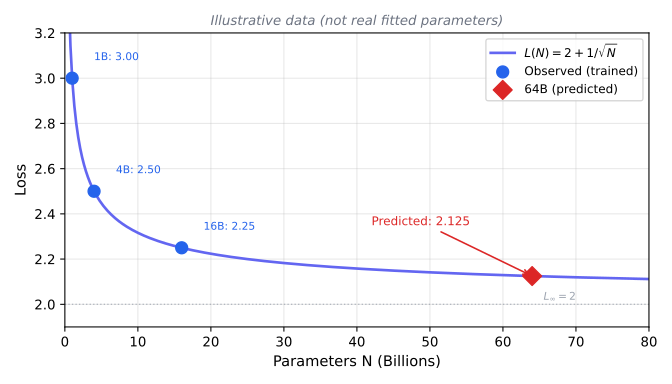
这意味着 loss 的改善量随 \(N\) 增大而递减——从 1B 到 4B 的提升,比从 16B 到 64B 的提升幅度更大。
为了建立直觉,用一组教学构造的数据来看效果。假设:
$$ L(N) = 2 + \frac{1}{\sqrt{N}} $$其中 \(N\) 以 Billion 为单位。那么:
- 1B → Loss = 3.0
- 4B → Loss = 2.5
- 16B → Loss = 2.25
- 64B → 预测 Loss = 2.125
这组数据是为了解释幂律形状而构造的,不是真实研究的拟合参数。
需要强调的是:实际研究中,可靠的外推依赖于足够多的中间规模数据点、一致的训练配置、以及对拟合不确定性的评估。三个点拟合一条曲线然后推到任意规模,显然不够稳健。Kaplan 原文用了大量不同规模的模型来拟合这些关系。
一个让我想了很久的问题——预测 Loss 有什么用?#
理解了幂律关系之后,我脑子里冒出来一个很自然的疑问:
就算能通过小模型预测大模型的 Pre-training Loss,又有什么实际意义?Loss 不等于实际能力,即使 Loss 从 2.5 降到 2.1,我也不知道模型的数学题准确率或者代码生成能力变好了多少。
后来想了想,觉得需要把"有用"分清楚三个层次:
- Pre-training Loss:语言建模目标上的统计表现。
- Downstream Benchmark:在具体任务(数学、代码、问答)上的准确率。
- Product Value:实际用户体验和业务效果。
Scaling Laws 对第一个层次有直接的预测价值。在做预训练的资源规划时,这件事很有用:在投入全部计算预算之前,先用小规模实验估计大模型的 loss,可以筛选超参数、比较架构方案、评估训练成本。这比盲目扩大规模然后等几周出结果要高效得多。
但从 Loss 到下游任务准确率,中间不存在简单的映射关系。Loss 下降 0.1 对应的数学题准确率提升可能是 2%,也可能是 15%,取决于具体任务和模型的当前能力区间。一些研究者也在尝试为下游任务建立独立的 scaling 预测模型,但这比预测 pre-training loss 复杂得多。
Scaling Laws 对预训练资源规划很有价值,但不能直接保证下游能力或者商业价值。
Chinchilla——固定计算预算下,增大模型还是增加数据?#
前面的讨论只看了参数量 \(N\) 对 loss 的影响。但训练一个模型不只是选参数量——还需要决定喂多少 token。
对于标准的 Dense Transformer,训练计算量的一个粗略估计是:
$$ C \approx 6ND $$其中 \(C\) 是 FLOPs,\(N\) 是参数量,\(D\) 是训练 Token 数。这不是严格恒等式,忽略了 attention 的二次项和其他开销,但在数量级估计上够用。
这个公式意味着,给定固定的计算预算 \(C\),\(N\) 和 \(D\) 之间存在直接的 trade-off:参数量大 10 倍,能处理的 token 就少 10 倍。
比较两个训练方案:
| 方案 A | 方案 B | |
|---|---|---|
| 参数量 \(N\) | 70B | 7B |
| 训练 Token 数 \(D\) | 100B | 1T |
| 近似计算量 \(C\) | \(\approx 4.2 \times 10^{22}\) | \(\approx 4.2 \times 10^{22}\) |
两者花的计算量接近,但参数量差了 10 倍。
70B 模型的参数更多,理论上容量更大——但它只看了 100B token,训练可能不够充分。7B 模型参数少,但看了 1T token,训练更充分。
哪个最终的 loss 更低?
2022 年 DeepMind 在 Training Compute-Optimal Large Language Models(通常叫 Chinchilla 论文)里直接做了这个实验。他们比较了:
- Gopher:280B 参数,训练了约 300B token。
- Chinchilla:70B 参数,训练了约 1.4T token。
两者的训练计算量接近。但参数量只有 Gopher 四分之一的 Chinchilla,在大量 benchmark 上反而表现更好。
这个结果说明:训练参数量不是唯一目标。固定计算预算下,参数量和训练数据量需要协调分配,盲目增大模型但训练数据不足,反而可能浪费计算资源。
Kaplan 和 Chinchilla 到底是什么关系?#
我在看资料的时候一度很困惑:Scaling Laws 和 Chinchilla Scaling Laws 是两个不同的定律吗?名字为什么这么像?
后来理清楚了。Scaling Laws 是一个研究方向,不是一个特定的定律。在这个方向上,有两个特别重要的研究节点:
| Kaplan et al., 2020 | Hoffmann et al., 2022(Chinchilla) | |
|---|---|---|
| 机构 | OpenAI | DeepMind |
| 核心问题 | N、D、C 与 Loss 的幂律关系 | 给定 C,N 和 D 应该如何分配 |
| 关于 Compute-Optimal | 倾向于优先增大模型参数量 | 发现应同比例扩大 N 和 D |
| 模型参数量范围 | 约 768 到 1.5B | 约 70M 到 16B,加上 Chinchilla 70B |
需要注意的是:Kaplan 的论文也研究了 compute-optimal 问题,并不是 Chinchilla 第一次提出这个概念。两者的分歧在于对最优分配比例的结论不同。
Kaplan 的实验暗示,固定计算量时,应该把更多预算分给更大的模型(即优先增加 \(N\))。Chinchilla 的结论则是,\(N\) 和 \(D\) 应该大致按相同比例扩大。这个分歧可能源于训练设定、参数统计口径、学习率调度等方面的差异。
所以,Chinchilla Scaling Laws 是对 Kaplan Scaling Laws 在 compute-optimal 问题上的一次重要修正,不是一个独立的新方向。
Chinchilla 也不是最终答案#
Chinchilla 的一个常被引用的经验比例是:每个参数大约需要 20 个训练 token(即 \(D \approx 20N\))。这个比例在他们的实验条件下大致成立。
但这不是一个永远适用的硬规则。
首先,这个比例是在特定的模型架构、数据集、训练超参数条件下拟合出来的。换一种架构、换一种数据混合方式,最优比例可能不同。
其次,Training Compute-Optimal 和 Inference-Optimal 不是一回事。Chinchilla 优化的是:给定训练计算预算,怎么获得最低的 pre-training loss。但如果一个模型需要处理大量推理请求,推理成本可能远超训练成本。在这种场景下,训一个更小但训练更充分的模型(用更多 token 去"过度训练"一个参数量较小的模型),虽然 pre-training 的计算效率不是最优的,但整体经济性可能更好。
2024 年的 Beyond Chinchilla-Optimal: Accounting for Inference in Language Model Scaling Laws 讨论的就是这个问题。LLaMA 系列模型的设计思路也体现了这种考虑——它们的 token/parameter 比例远超 Chinchilla 的经典建议,因为 Meta 的目标不只是最低的 pre-training loss,还要考虑推理部署时的成本。
训练最优不等于推理最优,更不等于产品最优。最终的设计选择取决于优化目标是什么。
写在最后#
回到开头的问题。
如果让我提炼三件事:
第一,大模型的 Pre-training Loss 在一定条件下具有可预测性。 这是 Scaling Laws 最核心的贡献。它让大模型训练从纯粹的试错,变成了可以先估算再决策的工程问题。
第二,固定训练计算预算下,参数量与训练数据量需要协调分配。 Chinchilla 揭示了盲目增大参数量而不配合足够训练数据的代价。
第三,最优训练配置取决于你的优化目标。 Pre-training Loss、下游任务表现、推理成本,这些是不同的优化目标,可能导向不同的最优配置。
说到这里,还有一个问题一直在脑子里:Pre-training Loss 的改善通常是平滑的——模型从 7B 到 70B,loss 稳步下降。但在一些下游 benchmark 上,研究者观察到了不太一样的现象:准确率在某个模型规模区间似乎突然大幅提升。
这就是所谓的 Emergent Abilities。下一篇想把这件事掰开看看。
参考资料#
- Kaplan et al., Scaling Laws for Neural Language Models, 2020 — https://arxiv.org/abs/2001.08361
- Hoffmann et al., Training Compute-Optimal Large Language Models, 2022 — https://arxiv.org/abs/2203.15556
- Sardana & Frankle, Beyond Chinchilla-Optimal: Accounting for Inference in Language Model Scaling Laws, 2024
- 从 Pre-training 到 Post-training:为什么大模型需要分阶段训练?