起因#
上一篇 Tensor Parallelism 写完之后,我对 TP 的基本原理有了底:把单个算子内部的矩阵乘法拆到多张 GPU 上执行,每张卡只算部分输出,最后通过 AllReduce 聚合。TP 分片的是计算本身。
但文章结尾有一句话当时没展开——“节点间的较低带宽互连跑 ZeRO/FSDP 或 Pipeline Parallelism”。Pipeline Parallelism 到底做了什么?
回头看 ZeRO 那篇,里面有一个关键区分:ZeRO-3 把参数、梯度和 Optimizer States 分片存储到不同 GPU,但每张 GPU 做 forward 时仍然需要 AllGather 完整参数,执行的是完整的模型计算。也就是说,ZeRO 分片的是存储,不是计算。
Pipeline Parallelism 做的事情不同:它把模型按 Layer 切分,不同的 GPU 负责不同的 Layer。GPU 0 只跑 Layer 0-5,GPU 1 只跑 Layer 6-11。每张卡上的计算量确实变少了。
这听起来很理想——模型太大单卡放不下?切成几段分到多张卡上不就行了?
实际试过之后我发现没那么简单。切分模型只是第一步,更关键的问题是:切完之后,GPU 之间存在严格的数据依赖,大部分 GPU 在大部分时间里都在等待。
这篇想搞清楚:Pipeline Parallelism 的调度是怎么一步步发展起来的,以及一个让我想了比较久的问题——1F1B 到底优化了什么。
把模型切到多张 GPU,和让多张 GPU 同时工作,不是一回事#
先看三种分布式训练方式的区别。
假设有一个 24 层 Transformer,4 张 GPU:
- DDP:每张 GPU 各持有完整的 24 层模型副本,各自处理不同的数据分片,通过 AllReduce 同步梯度。
- ZeRO-3:参数、梯度、Optimizer States 分片存储,但计算时通过 AllGather 临时收集完整参数,每张 GPU 仍然执行完整的 forward/backward。
- Pipeline Parallelism:GPU 0 只负责 Layer 0-5(Stage 0),GPU 1 只负责 Layer 6-11(Stage 1),以此类推。每张 GPU 只执行自己那一段的计算。
这里需要区分几个容易混淆的概念:
- Layer:模型的一个层(比如一个 Transformer Block)。
- Pipeline Stage:一段连续的模型计算,通常包含若干 Layer。
- Physical GPU:执行计算的物理设备。
在最简单的 PP 设定中,一个 Stage 对应一张 GPU。后面的讨论默认用这个假设。实际系统中一个 Stage 也可以由多张 GPU 共同执行(PP + TP 混合),但这不影响调度的核心逻辑。
现在的问题是:GPU 0 执行完 Stage 0 的 forward,输出的 Activation 需要发送给 GPU 1 作为 Stage 1 的输入。GPU 1 在收到这个 Activation 之前,没有任何有效计算可做。
也就是说,模型的 Layer 之间存在严格的串行数据依赖。仅仅把 Layer 分到不同 GPU,并不能让所有 GPU 同时干活。
没有 Micro-batch 的时间线:大部分 GPU 都在等#
先考虑最朴素的情况。一整个 Batch 从 GPU 0 出发,经过 GPU 1、GPU 2、GPU 3 完成 forward,再反方向从 GPU 3 回到 GPU 0 完成 backward。
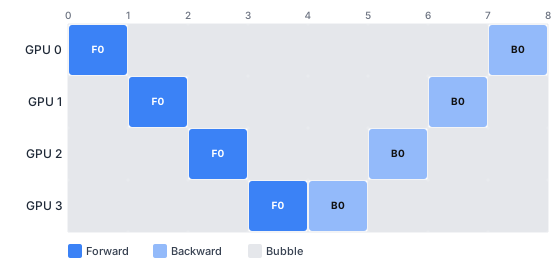
看这张时间线能很直观地发现:在任何一个时间点,最多只有一张 GPU 在做有效计算,其余三张全在等待。4 张 GPU 的利用率约为 25%。
这和不用 PP 有什么区别?单卡计算时间是 8 个时间单位(4 次 forward + 4 次 backward),4 张 GPU 的总时间也是 8 个时间单位——并行度为 1,完全没有加速。
问题出在哪里?Batch 是一个不可分割的整体,它必须从第一个 Stage 流到最后一个 Stage 再流回来。GPU 之间的依赖链迫使它们串行执行。
Micro-batch:让不同 Stage 同时处理不同的工作#
解决思路是:把一个大 Batch 拆成多个小的 Micro-batch(MB0, MB1, MB2, …)。
当 GPU 0 完成 MB0 的 forward 并把 Activation 发送给 GPU 1 后,GPU 0 不需要等待——它可以立即开始 MB1 的 forward。与此同时,GPU 1 正在处理 MB0。
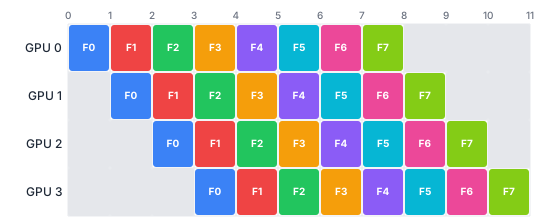
对比之前的串行时间线,关键变化是:不同的 GPU 在同一时刻处理的是不同的 Micro-batch。GPU 0 在处理 MB3 的时候,GPU 1 在处理 MB2,GPU 2 在处理 MB1,GPU 3 在处理 MB0。这才是 Pipeline 的含义——多个工作单元在不同的阶段同时流动。
但有一点需要想清楚:同一个 Micro-batch 的 Stage 依赖仍然存在。MB0 必须先经过 Stage 0 才能进入 Stage 1。被重叠的是不同 Micro-batch 的执行,不是同一个 Micro-batch 内部的 Stage。
Pipeline Bubble 的三个阶段#
有了 Micro-batch 之后,一个完整的训练迭代(包括所有 Micro-batch 的 forward 和 backward)可以分为三个阶段:
- Warmup:Pipeline 正在填充。前几个 Micro-batch 还没流到最后一个 Stage,靠后的 GPU 仍然空闲。
- Steady State:Pipeline 已满。多个 Stage 同时处理不同的 Micro-batch,这是 GPU 利用率最高的阶段。
- Cooldown:不再注入新的 Micro-batch,已有的工作依次排空。靠前的 GPU 逐渐变空闲。
Warmup 和 Cooldown 阶段,部分 GPU 处于空闲状态。这些空闲时间就是 Pipeline Bubble。
Bubble 是 Pipeline Parallelism 的固有代价——它来自 Pipeline 的填充和排空过程,只要 Pipeline 有多个 Stage,就无法完全消除。
在后面的讨论中,我用 \(p = 4\) 个 Stage、\(m = 8\) 个 Micro-batch 作为贯穿全文的例子。
GPipe / AFAB:先跑完所有 Forward,再跑所有 Backward#
GPipe(也叫 AFAB,All-Forward-All-Backward,或 F-then-B)是最直观的 Pipeline 调度方式。
它的规则很简单:每个 Stage 在一个训练迭代中,先执行所有 Micro-batch 的 Forward,再执行所有 Micro-batch 的 Backward。
但不同 Stage 之间不是全局同步的——Stage 1 的 Forward 必须等 Stage 0 把对应 Micro-batch 的 Activation 发过来。所以实际的执行顺序要满足 Pipeline 的数据依赖。
下面是 4 Stage × 8 Micro-batch 的 GPipe 完整时间线:
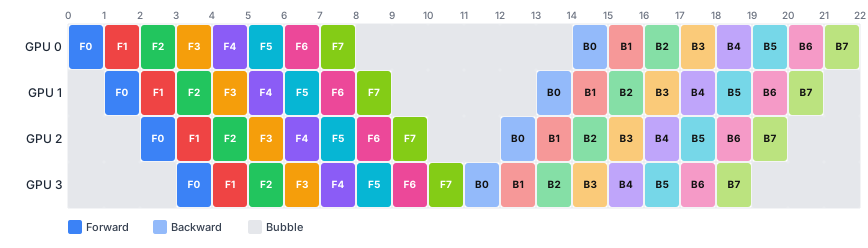
从图中可以观察到几个特征:
- 每个 Stage 内部,所有 Forward(F0-F7)先执行完,然后才开始 Backward(B0-B7)。
- Pipeline 的 Warmup 和 Cooldown 阶段存在明显的灰色 Bubble。
- 在 Forward 阶段结束、Backward 阶段开始之间,也存在一段 Bubble。
GPipe 的逻辑简单、容易理解,但有一个问题让我想了一会儿:
考虑 Stage 0。它先执行了 F0 到 F7,8 个 Forward 全部完成后才开始 B0。也就是说,在 B0 执行之前,F0 到 F7 这 8 个 Micro-batch 的 Forward 中间结果(Activation)都需要保留在显存中——因为 Backward 需要它们来计算梯度。
之前的文章讨论过这件事:Activation 的 lifetime 被 backward 拉得很长。在 GPipe 中,这个问题更突出——同一个 Stage 上有 \(m\) 个 Micro-batch 的 Activation 同时驻留在显存中。
已经执行了 Forward 但尚未执行 Backward 的 Micro-batch 越多,需要同时保留的 Activation 就越多。 这是 GPipe 调度方式的显存代价。
1F1B:为什么不早点执行 Backward?#
这一节是我想得最久的部分。
GPipe 的问题在于:所有 Forward 做完了才开始 Backward,导致大量 Activation 长时间驻留显存。一个自然的想法是——能不能在允许的依赖关系下,尽早执行某个 Micro-batch 的 Backward?
这就是 1F1B(One-Forward-One-Backward)调度的核心思想。
1F1B 不是"每做一个 Forward 就立即做同一个 Micro-batch 的 Backward"。我一开始的理解有偏差,以为 F0 后面必须紧跟 B0。实际上不是——MB0 的 Backward 需要等所有下游 Stage 的 Backward 完成,这个时间点可能比 Stage 0 完成 F0 要晚得多。
1F1B 的实际调度逻辑:
- 每个 Stage 有一个 Warmup 阶段:先执行若干个 Forward,填满 Pipeline。Stage \(i\) 的 Warmup Forward 数量是 \(p - 1 - i\)。直觉上,越靠前的 Stage 需要越多的 Warmup Forward 来"喂饱"下游。
- Warmup 结束后进入 Steady State:交替执行一个 Forward 和一个 Backward。注意这里交替的 Forward 和 Backward 通常对应不同的 Micro-batch——比如执行 F4 后执行 B0,而不是 F4 后执行 B4。
- 最后是 Cooldown:所有 Forward 都发出去了,依次执行剩余的 Backward。
用 Stage 0(Warmup = 3)的操作序列来说明:
1F0 F1 F2 F3 B0 F4 B1 F5 B2 F6 B3 F7 B4 B5 B6 B7前 3 个(F0, F1, F2)是 Warmup。然后从 F3 开始,每做一个 Forward 就紧跟一个 Backward:F3-B0、F4-B1、F5-B2、F6-B3、F7-B4。最后 B5、B6、B7 是 Cooldown。
再看 Stage 3(最后一个 Stage,Warmup = 0):
1F0 B0 F1 B1 F2 B2 F3 B3 F4 B4 F5 B5 F6 B6 F7 B7Stage 3 没有 Warmup——它是最后一个 Stage,Forward 完成后不需要等下游,可以立即开始 Backward。
下面是同参数(4 Stage × 8 MB)的 1F1B 时间线:
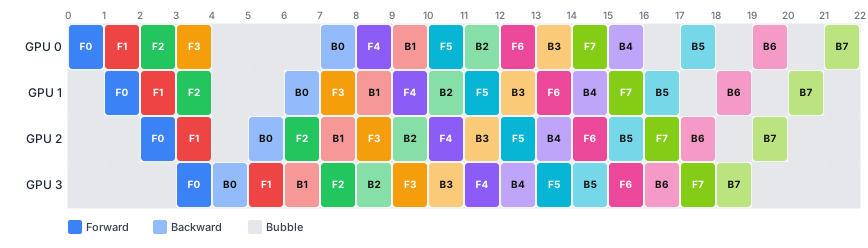
和上面的 GPipe 图使用相同的时间刻度和颜色编码。直接对比可以看到:两种调度的总时间相同,都是 22 个时间单位。Bubble 区域的形状不同,但面积相似。
我一开始看到这个结果有点困惑:1F1B 让 Forward 和 Backward 交替执行了,为什么总时间没变?Bubble 也没有明显减少?
1F1B 到底优化了什么#
这是我觉得最容易产生误解的地方。
一个容易形成的直觉是:“1F1B 让 Forward 和 Backward 交替执行,Pipeline 利用率更高,所以 Bubble 更少”。但对于普通的(非交错的)1F1B,这个说法在理想均衡条件下并不成立。
在各 Stage 均衡、忽略通信的理想假设下,GPipe 和 1F1B 的 Iteration 总时间都是 \((m + p - 1)(T_F + T_B)\)。对于 \(p = 4, m = 8, T_F = T_B = 1\),就是 \(22\)。两者的 Bubble Time 相同。
1F1B 的核心收益不是减少 Bubble,而是减少需要同时保留的 Activation 数量。

具体来看:
- GPipe / AFAB:一个 Stage 先完成所有 \(m\) 个 Forward,然后才开始 Backward。在 Backward 开始之前,这 \(m\) 个 Micro-batch 的 Activation 全部需要保留。已经执行 Forward 但尚未执行 Backward 的 Micro-batch 数量(“在途"数量)峰值为 \(m\)。
- 1F1B:Warmup 阶段结束后,每做一个 Forward 就紧跟一个 Backward。Backward 执行后,对应 Micro-batch 的 Activation 可以立即释放。在途 Activation 的峰值不会超过 \(p\)(Warmup 阶段积累的数量)。
当 \(m \gg p\) 时,这个差距很显著。比如 \(m = 32, p = 4\):GPipe 需要同时保留 32 个 Micro-batch 的 Activation,而 1F1B 最多只保留 4 个。
需要说明:这里的 \(O(m)\) 和 \(O(p)\) 描述的是在途 Activation 的数量级,不是整个训练显存的复杂度。实际的峰值 GPU 显存还包括参数、梯度、Optimizer States、通信 Buffer 等,Activation 只是其中一部分。
| 维度 | GPipe / AFAB | 普通 1F1B |
|---|---|---|
| Forward/Backward 顺序 | 所有 F 先于所有 B | Warmup 后 F/B 交替 |
| 理想 Bubble(均衡 Stage) | \((p-1)(T_F+T_B)\) | 相同 |
| 在途 Activation 峰值 | \(O(m)\) | \(O(p)\) |
| 主要收益 | 简单、易理解 | 显著减少 Activation 显存 |
1F1B 的 Activation 优势在工程上意味着:在相同的显存预算下,1F1B 可以使用更多的 Micro-batch(减少 Bubble 占比),或者使用更大的 Micro-batch Size(提高单个 CUDA Kernel 的计算效率)。这些间接收益在实际训练中可能比调度本身的区别更重要。
名词澄清:Non-interleaved 1F1B 的 “Non-interleaved” 指什么#
这一节短,但对我来说有必要写,因为 “interleaved” 这个词在 PP 的上下文中指代了两件不同的事情。
前面讨论的 1F1B,技术上叫 Non-interleaved 1F1B。这里的 “Non-interleaved” 不是说 Forward 和 Backward 不交替——它们在 Steady State 是交替的。
“Non-interleaved” 指的是:每个物理 GPU 只负责一段连续的模型层(一个 Virtual Model Chunk)。这是最简单的模型划分方式。
相对地,Interleaved 1F1B(来自 Megatron-LM)让一个物理 GPU 负责多个不连续的 Model Chunk。比如 GPU 0 同时负责 Layer 0-2 和 Layer 12-14。通过在不同 Chunk 之间交错调度,可以进一步减少 Pipeline Bubble。
Interleaved 1F1B 的调度更复杂,Bubble 确实可以减少,但引入了额外的通信和调度开销。这篇不展开它的时间线——理解了 Non-interleaved 1F1B 的调度逻辑之后,再看 Interleaved 版本会容易很多。
更高级的调度算法(如 Zero Bubble Pipeline、DualPipe 等)在此基础上进一步优化,但核心问题仍然是同一个:如何在数据依赖的约束下,让尽可能多的 GPU 在尽可能多的时间里做有效计算。
写在最后#
三个让我觉得值得记住的认识:
Pipeline Parallelism 切分的是模型计算,但没有消除 Stage 之间的数据依赖。 和 DDP/ZeRO 不同,PP 中每张 GPU 只执行一部分模型层。但 Layer 之间是串行依赖的——一个 Stage 必须等到上游 Stage 完成才能开始工作。这个依赖决定了 Pipeline Bubble 的存在。
Micro-batch 是提高 Pipeline 利用率的关键机制。 没有 Micro-batch,4 张 GPU 的利用率只有 25%。Micro-batch 让不同 Stage 可以同时处理不同的工作,但 Bubble 仍然无法完全消除。
普通 1F1B 的核心价值是减少 Activation Memory,而不是减少 Bubble。 在理想均衡的条件下,GPipe 和普通 1F1B 的 Bubble Time 相同。1F1B 的真正优势是把在途 Activation 从 \(O(m)\) 降到 \(O(p)\),腾出显存空间来容纳更多 Micro-batch 或更大的 Micro-batch Size。
理解了调度之后,接下来的问题是:到底应该设多少个 Stage、多少个 Micro-batch?为什么增加 GPU 不一定更快?为什么最慢的 Stage 决定了整个 Pipeline 的吞吐?
这些问题在下一篇讨论。
参考资料#
- Tensor Parallelism:为什么矩阵乘法可以拆分到多张 GPU 上?
- 从 DDP 到 ZeRO:为什么分布式训练要对参数、梯度和优化器状态分片?
- 从推理到训练:模型调度中的显存约束
- GPU 显存不够怎么办?Checkpointing 与 Offloading 的工程权衡
- Huang et al. GPipe: Efficient Training of Giant Neural Networks using Pipeline Parallelism. NeurIPS 2019.
- Narayanan et al. Efficient Large-Scale Language Model Training on GPU Clusters Using Megatron-LM. SC 2021.
- NVIDIA Megatron Core Pipeline Schedule 文档
- MIT 6.S191: Introduction to Deep Learning — Lecture 9: Secrets to Massively Parallel Training. https://introtodeeplearning.com/