最近学习 MIT 6.S191 Lecture 9,陆续把 DDP、ZeRO、FSDP2、Tensor Parallelism、Pipeline Parallelism、Sequence Parallelism、Context Parallelism,以及 Expert Parallelism 过了一遍。
每一种并行策略单独看都不难理解。但当这些缩写一起出现时,很容易混淆:它们究竟有什么区别?为什么需要这么多种并行?实际训练时又如何组合?
这篇文章不再展开具体算法和通信细节,只希望用一张图建立一个统一的理解框架。
并行的本质:我们究竟在切分什么?#
假设我们有一个 Transformer,输入形状为:
$$ X \in \mathbb{R}^{B \times S \times H} $$其中:
- \(B\):Batch Size
- \(S\):Sequence Length
- \(H\):Hidden Dimension
模型本身还有 \(L\) 个 Layer。如果使用 MoE,还会包含 \(E\) 个 Expert。
训练时,除了模型计算,还需要存储 Parameters、Gradients、Optimizer States 和 Activations。
不同的并行策略,其实是在对这些不同的维度、计算任务或存储状态进行切分。
核心区别不是用了多少张 GPU,而是每张 GPU 究竟负责什么。
七种并行策略全景#
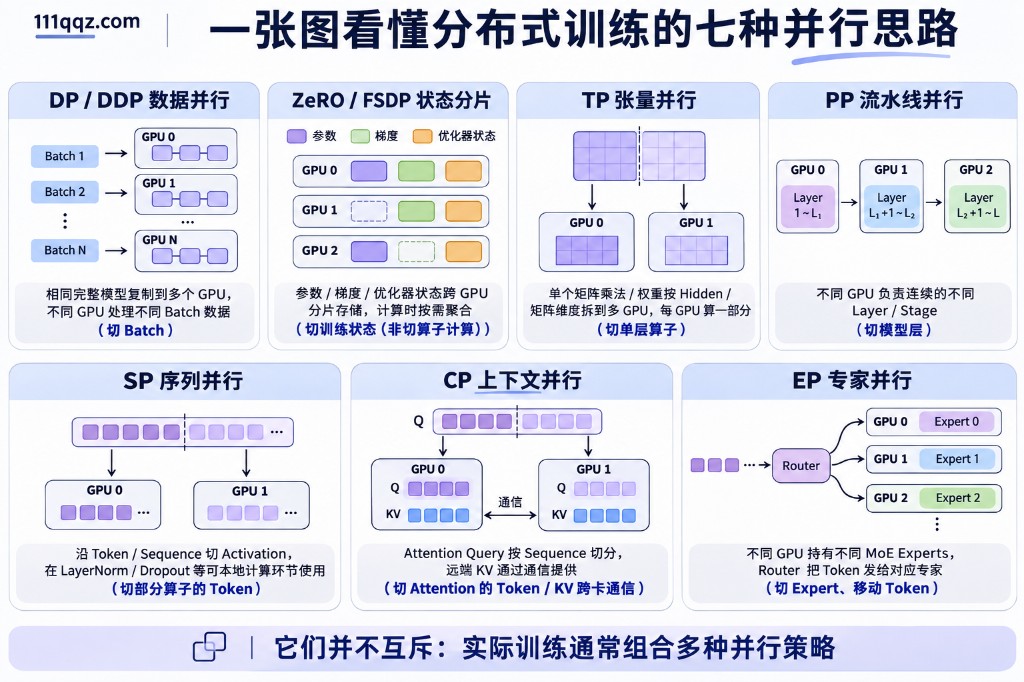
| 并行策略 | 核心切分对象 | 最主要的目的 |
|---|---|---|
| DP / DDP | Batch / 数据样本 | 扩展训练吞吐 |
| ZeRO / FSDP | 训练状态的存储 | 消除冗余、节省显存 |
| TP | 单个 Layer 内部的 Tensor / 算子计算 | 分摊单层计算与参数 |
| PP | 模型的不同 Layer / Stage | 分摊整个模型 |
| SP | 部分算子的 Sequence Activation | 减少 Activation 冗余 |
| CP | 包括 Attention 在内的 Sequence 计算 | 支持更长的 Context |
| EP | MoE Expert | 分摊 Expert 参数与计算 |
DP:不同 GPU 处理不同数据#
Data Parallelism 最容易理解。
每张 GPU 持有相同的完整模型,但处理不同的 Mini-batch。Backward 之后同步梯度,让各 GPU 的模型更新保持一致。
它解决的主要问题是训练吞吐,而不是单卡模型显存。
ZeRO / FSDP:不必复制所有训练状态#
普通 DDP 的问题是,每张 GPU 都保存完整的 Parameters、Gradients 和 Optimizer States。
ZeRO 通过不同 Stage 逐步分片这些状态。FSDP2 则提供了 PyTorch 原生的全参数分片实现。
最重要的一点:训练状态的存储分片,不等于模型计算的切分。
ZeRO-3 / FSDP 在典型数据并行场景下,仍然需要在计算相应模块时临时收集完整参数,执行该模块的完整计算。
TP:一层太大,就把一层拆开#
Tensor Parallelism 将一个 Layer 内部的计算分配到多张 GPU。
例如一个很大的矩阵乘法,可以按照输入或输出特征维度拆分。
与 ZeRO 不同,TP 不只是改变参数存在哪里,而是让多张 GPU 真正分担同一个算子的计算。
PP:一层可以不拆,把不同层交给不同 GPU#
Pipeline Parallelism 沿着模型深度切分。
例如 GPU 0 负责前几层,GPU 1 负责中间几层,GPU 2 负责后几层。
为了避免 GPU 长时间等待,可以把 Batch 拆成多个 Micro-batch,并通过 Pipeline 调度提高设备利用率。
PP 的核心问题是 Pipeline Bubble 和 Stage Balance。
SP:有些计算不需要完整 Sequence#
Sequence Parallelism(这里特指 Megatron 风格)通常作为 TP 的补充。
例如 LayerNorm、Dropout 和部分 Residual 操作,并不需要同时持有所有 Token 的 Activation。
因此,可以让不同 GPU 只处理自己负责的 Token,减少重复计算和 Activation 存储。
它并不是简单地为整个模型增加一个独立的并行维度。
CP:Attention 也需要沿 Sequence 分摊#
Context Parallelism 同样沿 Sequence 维度切分,但它进一步覆盖 Attention。
Self-Attention 存在跨 Token 依赖,因此只保留本地 Token 还不够。GPU 需要访问远端的 Key / Value 数据。
CP 通过跨 GPU 通信满足这些依赖,让各 GPU 分担长 Sequence 的 Attention 计算和相关 Activation。
SP 和 CP 切的是同一个 Sequence 维度,区别主要在于覆盖哪些算子,以及如何处理跨 Token 的依赖。
EP:MoE 的专家也可以分布在不同 GPU 上#
Expert Parallelism 是针对 Mixture of Experts 的特殊并行方式。
不同 GPU 存储和计算不同的 Expert。Router 决定 Token 应该访问哪些 Expert,然后通过 Dispatch 将 Token 发送到对应的设备。
与传统 Dense 模型不同,MoE 每个 Token 只激活一部分 Expert。
因此,EP 的核心是在多张 GPU 上合理组织 Expert 的存储、Token Routing 和计算。
这些并行策略不是互斥的#
真正的大规模分布式训练系统,通常会组合多种并行策略。
例如,假设使用 8 张 GPU:
$$ 8 = DP(2) \times TP(2) \times PP(2) $$我们可以将 GPU 划分成两个数据并行副本。每个副本使用两个 Pipeline Stage,而每个 Stage 内部再通过两张 GPU 执行 Tensor Parallelism。
同时:
- 在 TP 内部,可以启用 SP 减少部分 Activation 冗余。
- 如果 Sequence 很长,可以考虑引入 CP。
- 如果模型使用 MoE,可以在相应的 Expert 层设计 EP。
- 根据显存约束,还可以使用 ZeRO / FSDP 等训练状态分片方案。
不过需要注意,这些并行方式并非七个完全独立的维度。SP 通常依附于 TP;ZeRO / FSDP 是训练状态管理策略;EP 与 TP、DP 的设备分组也可能存在重叠或复用。
因此,不能机械地把所有并行度相乘,就认为得到了 GPU 总数。
实际配置还需要考虑模型结构、设备拓扑和通信需求。
从切分对象,到通信与计算的权衡#
回顾整个系列,我觉得可以把这些并行策略归纳为三个层次。
第一层:让不同 GPU 处理不同的工作。
DP 分数据,PP 分模型层,TP 分算子,CP 分长序列计算,EP 分专家计算。
第二层:消除不必要的存储冗余。
ZeRO / FSDP 分片训练状态,SP 减少部分算子的 Activation 冗余。
第三层:让计算与数据分布相匹配。
每次切分,都会带来新的通信需求。DP 需要同步梯度,TP 需要合并部分计算结果,PP 需要在 Stage 之间传递 Activation,CP 需要跨设备访问 KV,EP 需要 Dispatch Token。
所以,并行度越大,并不意味着训练一定越快。
真正需要优化的是:
$$ \text{Effective Training Throughput} $$它同时取决于计算效率、显存约束、通信开销、负载均衡,以及不同操作能否有效重叠。
写在最后#
最初学习分布式训练时,我把 DDP、ZeRO、TP、PP 看作几套独立的技术。
但系统学习之后发现,它们其实都在回答同一个问题:
对于一个计算任务,哪些数据必须存在于同一张 GPU,哪些计算可以独立完成,哪些依赖必须通过通信满足?
并行策略的名称只是结果。背后的核心始终是数据布局、计算划分和通信组织。
这也是整个分布式训练系列,我最希望保留下来的心智模型。
延伸阅读#
本文是整个系列的总览。具体实现可以参考此前的专题文章: